2026年10月20日
5 分钟
MiniMax H3 复现手册:从权重下载到 2K 出片的全套资源清单
这个系列的评论区被问得最多的不是数据,是“怎么跑起来”。之前的文章给了性能数字:单卡 4 步 LoRA 口径 768p/5s 只要 75 秒,双卡满血口径一条 5s 约 9.3 分钟——但数字背后的复现路径散落在不同文档里。 这篇把它们收拢成一个可直接动手的手册:模型权重在哪下、容器镜像怎么选、双卡...
探索前沿技术,分享实践经验,追踪行业动态
这个系列的评论区被问得最多的不是数据,是“怎么跑起来”。之前的文章给了性能数字:单卡 4 步 LoRA 口径 768p/5s 只要 75 秒,双卡满血口径一条 5s 约 9.3 分钟——但数字背后的复现路径散落在不同文档里。 这篇把它们收拢成一个可直接动手的手册:模型权重在哪下、容器镜像怎么选、双卡...
做视频生成产品,模型选型看能力,成本核算看价格。H3 上线后我们把市面上能接到的渠道都摸了一遍:官方两个站、云厂商聚合、转发平台、社区工作流,价格从每秒 1 分到每秒 8 毛都有。 这份调研的结论一句话:H3 是当前视频生成市场的“价格屠夫”——官方 2K 定价约 ¥7.80/分钟,较 Seedan...
H3 的部署文档给的显存参考是一回事,你手上的预算是另一回事。跑 MiniMax H3 到底该租哪张卡,这个问题我们在服务客户的过程中被问了很多遍:4090 24G 便宜但显存小,5090 贵一截,中间还有一张 4090 48G 看起来两头兼顾。 答案是:两头兼顾的卡,往往两头都不占。这次我们把三张...
H3 的部署文档给的显存参考是一回事,你手上的预算是另一回事。跑 MiniMax H3 到底该租哪张卡,这个问题我们在服务客户的过程中被问了很多遍:4090 24G 便宜但显存小,5090 贵一截,中间还有一张 4090 48G 看起来两头兼顾。 答案是:两头兼顾的卡,往往两头都不占。这次我们把三张...
我们给 Imagifly「梦梦」这个 QQ Bot 接了 LLM,让它自然地混进群聊。上线一个月后拉账单:日均 token 消耗 64.5 万、日均费用 $0.80。对一个以闲聊为主的 bot 来说,这个数字明显偏高。这篇文章记录一次完整的优化复盘——不是拍脑袋的"我们优化了性能",而是把每一分降幅...
gongji-skills 是共绩算力的开源 Agent 工具库,每个 skill 里都带一份 api/.md 接口文档(共 63 个文件),供 Agent 构造 API 请求时参考。这些文档是从 Apifox 手工导出的快照,有一个根本问题:接口更新了,快照不会跟着变。 我们提交了 PR 2(ht...
gongji-skills 是共绩算力的开源 Agent 工具库,每个 skill 里都带一份 api/.md 接口文档(共 63 个文件),供 Agent 构造 API 请求时参考。这些文档是从 Apifox 手工导出的快照,有一个根本问题:接口更新了,快照不会跟着变。 我们提交了 PR 2(ht...
视频生成模型的输出分辨率经常卡在 720p,要上 2K,超分是绕不开的一环。现在主流的两条技术路线恰好代表了两种哲学:判别式模型用 CNN 逐帧还原,快而稳;生成式扩散模型靠"脑补"补细节,锐但需要人盯。 我们选了 RTX VSR 和 FlashVSR 这两个各自路线的代表,在 5 组差异很大的内容...
视频生成模型的输出分辨率经常卡在 720p,要上 2K,超分是绕不开的一环。现在主流的两条技术路线恰好代表了两种哲学:判别式模型用 CNN 逐帧还原,快而稳;生成式扩散模型靠"脑补"补细节,锐但需要人盯。 我们选了 RTX VSR 和 FlashVSR 这两个各自路线的代表,在 5 组差异很大的内容...
MiniMax-H3 是当前开源生态里体量最大的视频生成模型之一:33.1B 参数的全能 DiT 主干 + Qwen3-VL-32B 文本编码器,BF16 全量权重接近 500GB,一次推理要在显存里同时装下视频 DiT、音频 DiT、双 VAE 和一个 32B 的文本编码器。这类模型过去默认跑在...
MiniMax-H3 是当前开源生态里体量最大的视频生成模型之一:33.1B 参数的全能 DiT 主干 + Qwen3-VL-32B 文本编码器,BF16 全量权重接近 500GB,一次推理要在显存里同时装下视频 DiT、音频 DiT、双 VAE 和一个 32B 的文本编码器。这类模型过去默认跑在...
把 MiniMax H3 的 2K 生成和超分放进同一个容器对外提供服务,看起来是最省钱的方案:一张卡、一个实例、一套代码。我们的压测结论是——短时可用,长跑必崩。这篇文章复盘一次完整的 OOM 故障定位过程,以及两条经过实测验证的架构解法。 压测按五层设计:L 层(单任务基线)、M 层(生成与超分...
把 MiniMax H3 的 2K 生成和超分放进同一个容器对外提供服务,看起来是最省钱的方案:一张卡、一个实例、一套代码。我们的压测结论是——短时可用,长跑必崩。这篇文章复盘一次完整的 OOM 故障定位过程,以及两条经过实测验证的架构解法。 压测按五层设计:L 层(单任务基线)、M 层(生成与超分...
MiniMax H3 的完整模型链约 41GB——视频 DiT、音频 DiT、双 VAE,再加一个 Qwen3-VL-32B 文本编码器。而单卡 RTX 5090 的可用显存只有 31.4GB。模型比卡大 10GB,却能稳定跑完 60 次测量、无一显存溢出。这篇文章除了给出 12 档位的完整耗时与成...
MiniMax H3 的完整模型链约 41GB——视频 DiT、音频 DiT、双 VAE,再加一个 Qwen3-VL-32B 文本编码器。而单卡 RTX 5090 的可用显存只有 31.4GB。模型比卡大 10GB,却能稳定跑完 60 次测量、无一显存溢出。这篇文章除了给出 12 档位的完整耗时与成...
共绩算力:以电网式算力调度技术建设全球领先的分布式算电网 平台简介 共绩算力是共绩科技有限公司旗下的弹性算力服务平台,运营主体为共绩科技有限公司(成立于 2023 年,清华大学校友团队创立,总部位于北京中关村)。 公司致力于利用人工智能与资源调度技术,解决 AI 时代算力供需之间长期存在的“资源分...
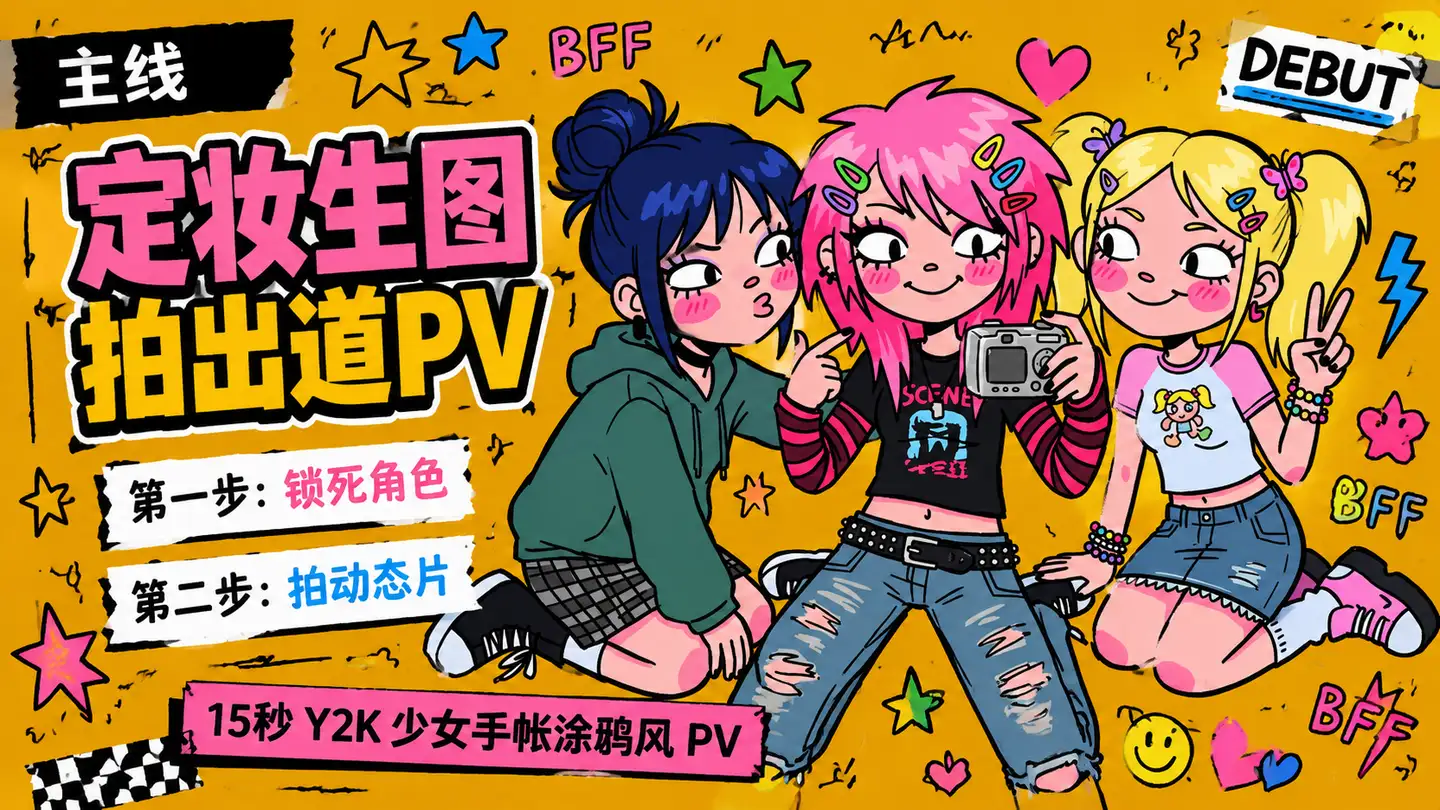
先说一个玩 AI 视频的人都懂的痛:你脑子里有个角色,抽了四十条视频,没有两条里的”她”长得一样。今天粉色双马尾,明天就变成黑长直。AI 视频默认是”抽卡”——每一条都是重新掷骰,角色长相、画风、配色全凭运气。 我最近试出一套能治这病的路子,借一个真实的创作场景讲清楚:如果你要给一支”少女团体”做...