pubDate: 2026-08-27coverIndex: 0authors: ["Shiyuh"]description: 花 Opus 4.8 四十分之一的钱,用上同样 57 分的模型——而且全部跑在国产芯片上。8 月 26 日晚,智谱正式发布并开源 GLM-5.3-Flash(320B-A18B),这是 GLM-5 系列的首个原生多模态模型。在此之前,它以匿名模型“Ox-Alpha”(中文社区称“牛来”)的身份在 OpenCode 和 OpenRouter 上进行了大规模测试,迅速成为当周最受欢迎的平台模型,创下双平台调用量新高。
现在,GLM-5.3-Flash 已正式上线共绩算力大模型云服务,按量计费,稳定易用。
性能持平旗舰,成本仅为 1/40
先看一组数字。
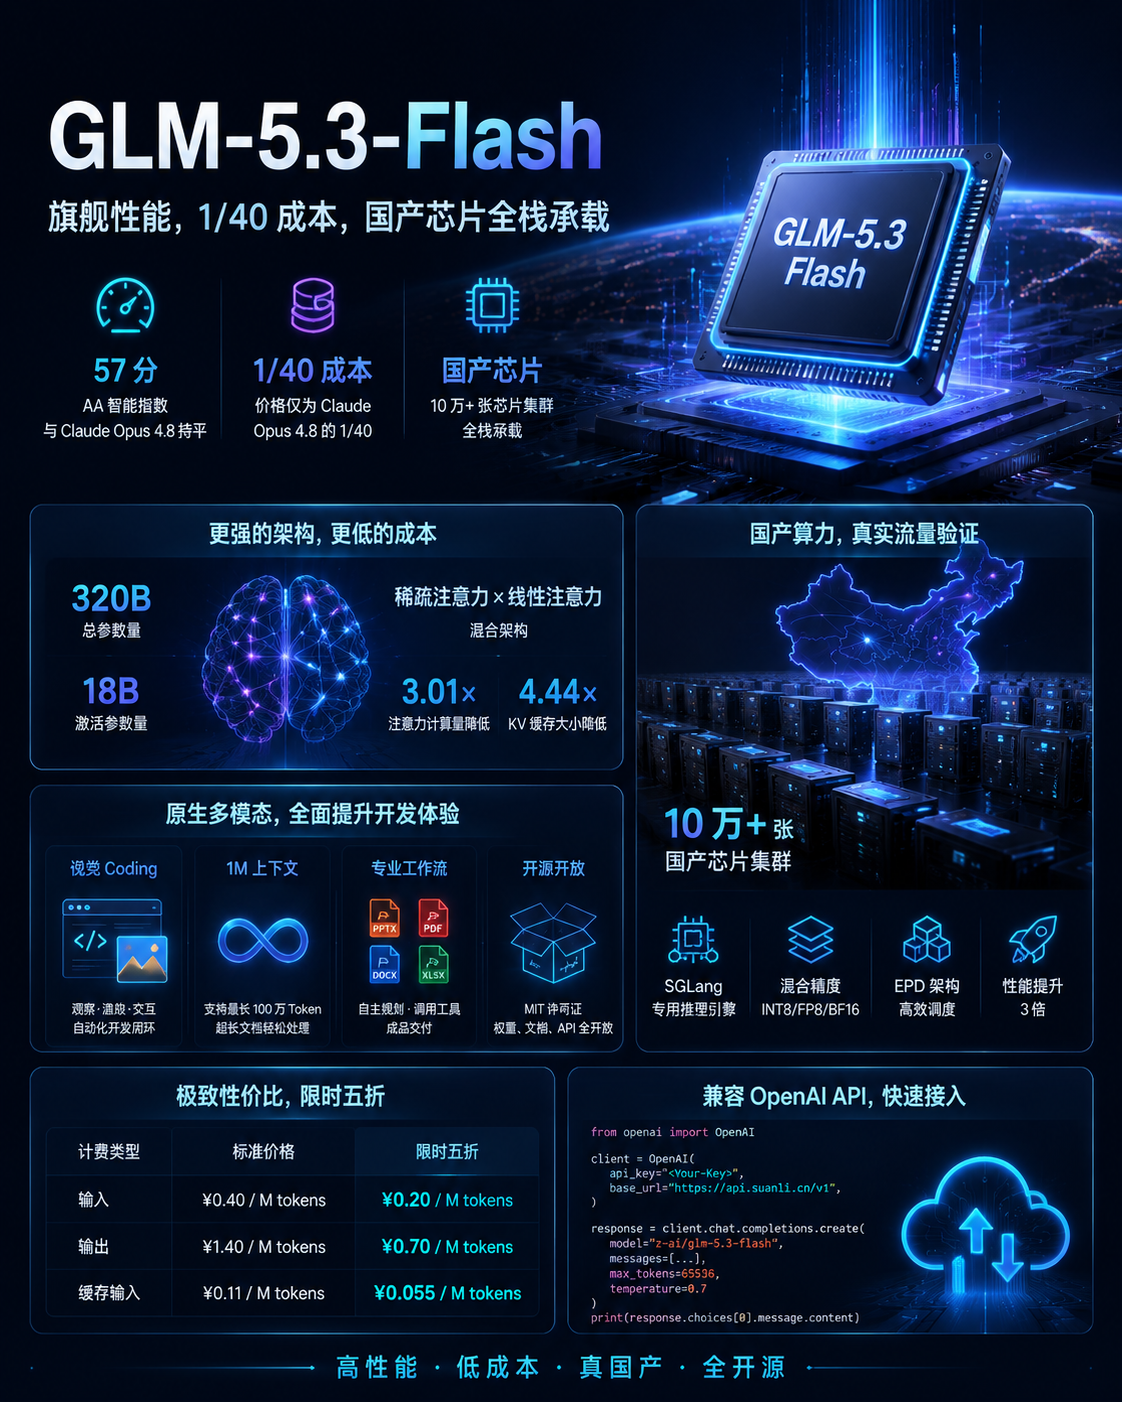
GLM-5.3-Flash 在全球权威的 Artificial Analysis Intelligence Index(AA 综合智能指数)中取得 57 分,与 Anthropic 最受欢迎的旗舰模型 Claude Opus 4.8 得分持平。在智谱自研的 Z.ai Code Bench 体感评估中,其编程表现也与 Claude Opus 4.8 相当。
但价格呢?GLM-5.3-Flash 的定价仅为同系列 GLM-5.3 的 1/10,限时折扣期内进一步降至 1/20,相当于 Claude Opus 4.8 价格的 1/40。
也就是说,你花四十分之一的钱,就能用上综合能力持平 Claude Opus 4.8 的模型。
这不是实验室数据,而是一个已经在全球开发者面前跑了六天真实流量的模型。
全部跑在国产芯片上
GLM-5.3-Flash 的发布,也回应了此前围绕 Ox-Alpha 最大的一个疑问:如此大规模的免费测试,算力从哪里来?
答案是:全部由国产芯片承载。
据悉,智谱共调用了超过 10 万张国产芯片集群用于该模型服务。这也是智谱首次尝试使用大规模国产芯片集群,直接承载来自全球开发者的真实线上负载。用户并不知道模型背后是谁、使用什么芯片,只根据速度、稳定性和效果决定是否继续调用——国产算力因此经历了一次持续的真实流量考验。
为了让模型真正跑在国产芯片上,智谱对推理系统做了大量针对性改造。基于 SGLang 构建专用推理引擎,加入节点内张量并行、W8A8 量化、INT8/FP8/BF16 混合缓存量化等技术。在集群层面采用 Encode-Prefill-Decode(EPD)分离架构,将多模态编码、Prompt 预填充和逐 Token 解码拆分为三个独立调度的算力池。
最终结果:与同一批硬件上的初始基线相比,端到端服务性能提升了 3 倍,硬件效率和单 Token 成本已达到与主流英伟达 GPU 相当的水平。
320B 参数,为什么比上一代旗舰还强
价格下降的另一半原因,来自模型架构本身。
GLM-5.3-Flash 总参数量 320B、激活参数量 18B,是首个采用稀疏注意力与线性注意力混合架构的开源前沿模型。相比 GLM-5.3,其注意力计算量和 KV 缓存大小分别降低 3.01 倍和 4.44 倍。
架构层面还有几个关键点:
-
原生多模态视觉 Coding:视觉能力被原生融入 Coding 循环,模型能主动观察界面、渲染结果与交互反馈,持续测试和改进代码。无论是前端开发、游戏构建、Blender 3D 场景,还是真实环境操作,模型都能在代码、浏览器和图形界面之间协同完成任务。
-
1M 超长上下文:原生支持最长 100 万 Token 上下文,足以处理整部《三体》三部曲体量的内容。
-
专业工作流能力:模型能自主拆解复杂目标、调用合适工具、检查并优化输出,完成从研究分析到 PPTX、PDF、DOCX、XLSX 成品交付的完整工作流。
定价与可用性
GLM-5.3-Flash 现已上线共绩算力平台,标准 API 定价为:
计费类型 | 价格 |
输入 | ¥0.40 / M tokens |
输出 | ¥1.40 / M tokens |
缓存输入 | ¥0.11 / M tokens |
限时五折:上线推广期间,所有调用享五折优惠。
模型兼容 OpenAI API 格式,Base URL 为 https://api.suanli.cn/v1,支持 1M 上下文。
如何开始
通过共绩算力 API 即可快速接入:
from openai import OpenAI
client = OpenAI(    api_key="<Your-Key>",    base_url="https://api.suanli.cn/v1",)
response = client.chat.completions.create(    model="z-ai/glm-5.3-flash",    messages=[        {"role": "system", "content": "You are a helpful assistant."},        {"role": "user", "content": "Hello, how are you?"}    ],    max_tokens=65536,    temperature=0.7)
print(response.choices[0].message.content)
GLM-5.3-Flash 已全面开源(MIT 许可证),开放 API 接口和在线体验渠道。模型权重、技术文档和示例代码均已公开。