This is the full developer documentation for 共绩算力
# 活动
# 6.18 前充值享 20% 返现
### 步骤
[Section titled “步骤”](#步骤)
1. 用户于个人账户进行充值操作。
2. 平台将在用户充值后,向其账户返还充值金额 20% 的款项。
### 奖励规则
[Section titled “奖励规则”](#奖励规则)
用户完成在平台的充值行为后,平台会在 5 个工作日内,将用户充值金额的 20% 作为返现,发放至用户账户。
### 特别说明
[Section titled “特别说明”](#特别说明)
* 返现金额仅可在共绩算力平台使用,长期有效,且不支持提现。
* 返现金额与用户充值金额在共绩算力平台具有同等效力,均能够用于付费算力。
* 本活动的有效时间为 2025 年 5 月 26 日至 2025 年 6 月 18 日。
* 为保证活动的公平性,严禁出现转卖、刷单等违规行为。若有账户违反规则,平台将取消该账户的奖励资格,并依法追究相关责任。
* 在法律允许的范围内,本活动的最终解释权归共绩算力所有。
# 向共绩算力提建议,采纳返 50 元
## 操作步骤
[Section titled “操作步骤”](#操作步骤)
1. 若用户在产品使用过程中,产生关于产品优化的建议,可通过平台向共绩算力进行反馈。
2. 共绩算力一旦采纳该建议,将在共绩算力官网中此文档进行公示,公示期为三天。
3. 公示结束后,若未收到任何异议,共绩算力将在 48 小时内,把建议奖励金额发放至用户账户。
## 奖励规则
[Section titled “奖励规则”](#奖励规则)
共绩算力对于用户所提出且被采纳的建议,每条将以 50 元的标准,打入用户账户。
## 特别说明
[Section titled “特别说明”](#特别说明)
1. 反馈奖励金额仅可在供给算力平台使用,90 天有效期,不可提现。
2. 反馈奖励金额与用户充值在共绩算力平台具有同等效力,均可用于付费算力服务。
3. 为保障活动公平性,严禁出现转卖、刷单等违规行为。若发现账户违反规则,平台将取消其奖励资格,并追究相关责任。
4. 在法律允许的范围内,本活动最终解释权归共绩算力所有。
## 反馈入口
[Section titled “反馈入口”](#反馈入口)
## 公示区
[Section titled “公示区”](#公示区)
# 个人开发者支持计划,申领最高 1500 元免费算力
共绩云上线新版本啦,我们针对大家之前遇到的问题做了很大的整改。新版本为各位提供了更加稳定、易用的算力服务:**秒级按量计费,单卡 4090 最低价!!1.68 元/h**
如果您的项目在起步阶段,而算力恰好是负担较重的成本,我们愿意与您一同解决问题
我们希望更好地支持各位开发者,并对有潜力的产品提供**最大力度的免费算力支持**。活动期间内最高提供** 1500 元免费额度**的专业算力支持,在活动期间表现优异的产品,将获得本平台算力**永久最低折扣**
## 活动内容
[Section titled “活动内容”](#活动内容)
1. 新手免费体验:扫码进群,填写申请表单立即领取** 50 元**(等价 24 小时 4090 显卡)算力体验积分,需携带申请项目的简要说明。
1. 深度支持:进群后填写申请表,通过审核的个人开发者可获得——
* **每月 200 元起**的持续算力支持(根据项目质量评估)
* **累计最高 1500 元**算力资源
## **我们优先考虑为这样的项目提供深度支持**
[Section titled “我们优先考虑为这样的项目提供深度支持”](#我们优先考虑为这样的项目提供深度支持)
(符合任一条件通过率更高。仅作参考,具体将根据各位开发者的实际情况筛选):
✔ 已有产品验证:个人网站/应用月活≥1 万
✔ 技术影响力:GitHub 项目≥100 star
✔ 开发者品牌:技术内容单篇浏览≥1 万,或账号粉丝≥1 万
## 规则说明
[Section titled “规则说明”](#规则说明)
1. 云服务资源将折成平台积分形式发放到您的账户
2. 对于共建者计划有任何疑问或需要帮助,请发送邮件至:**。
3. 赠送积分不可折现。
(最终解释权归共绩算力所有)
# 作者
# 博客
# 文档
# 关于
# 联系我们
## 工作时间
[Section titled “工作时间”](#工作时间)
工作日 10:00-18:30
## 技术支持
[Section titled “技术支持”](#技术支持)
常见问题:
点击链接:
或者扫码直接咨询

## 销售咨询
[Section titled “销售咨询”](#销售咨询)
| |
| --------------------------------------------- |
| 算力需求咨询,备注:共绩算力 |
|  |
## 销售电话
[Section titled “销售电话”](#销售电话)
18124016585
## 问题反馈
[Section titled “问题反馈”](#问题反馈)
# (产品)云主机
# 基础镜像
# 最佳实践
# 使用云主机的 Jupyter Lab 进行读取训练
🦀
参考文档[快速上手云主机服务](https://www.gongjiyun.com/docs/cloud-hosting/quickstart/rtsfwxqkiiozojkcia9cxrvgntf/)和 保存应用数据 文档 来进行配置
【数据安全必读】
系统盘与数据盘均为本地 SSD,无冗余,单点故障可能导致数据永久丢失。
请务必将重要数据实时备份至「共享存储卷」或本地,共绩算力对本地盘损坏及数据丢失不承担任何责任。
立即开通共享存储卷,获得企业级冗余 + 跨区域同步,彻底告别数据丢失:\
**

我们目前建议用户通过 Jupyter Lab 来进行共享存储卷文件的上传,方便多机文件共享
当出现缺少库的时候可以通过`pip install XXX` 来进行安装,

选中代码 点击运行 开始训练

可以看到数据成功存储到共享存储卷的目录中

# 「提示词反推工具」:图像打标批处理/炼丹必备辅助神器
## 一、为什么你需要「提示词反推」?
[Section titled “一、为什么你需要「提示词反推」?”](#一为什么你需要提示词反推)
做 AI 绘图的同学都懂:
1. 好不容易找到一张“梦中情图”,却写不出同样味道的提示词;
2. 训练 LoRA/角色模型时,需要给成百上千张图写标注,手打到天荒地老;
3. 多人协作,标注风格不统一,炼出来的丹直接“歪脸”。
**共绩算力**刚刚上线的「提示词反推工具」一次性解决以上痛点:
* 支持 **JoyCaption-3 / Qwen3 / Ovis2.5** 三大 SOTA 多模态模型;
* 批量拖拽,**500 张图 3 分钟**打完标签,显存占用 <6 G;
* 反推结果可直接复现 **80%+ 原图灵魂**,支持中文/英文/双语输出;
* 系统提示词完全开放,想写“古风仙侠”还是“赛博机甲”随你改;
* 云端运行,无需本地配置,**按量计费 0.29 元/千张**起。
## 二、一分钟快速上手
[Section titled “二、一分钟快速上手”](#二一分钟快速上手)
在共绩算力控制台中选择云主机,创建云主机——选择社区镜像——选择提示词助手—图象打标批处理

先点击 8888 的回传链接 然后按照指引启动提示词反推工具

**运行完成后推出 jupyterlab 点击 7860 端口的回传链接**
 
## 三、实测案例:蓝白裙萝莉复刻挑战
[Section titled “三、实测案例:蓝白裙萝莉复刻挑战”](#三实测案例蓝白裙萝莉复刻挑战)
**反推提示词(JoyCaption-3 中英双语)**
```yaml
best quality, a cute anime girl, sunshine, soft features, swing, a blue white edged dress, solo, flower, blue eyes, blush, blue flower, long hair, barefoot, sitting, looking at viewer, blue rose, blue theme, rose, light particles, pale skin, blue background, off shoulder, full body, smile, collarbone, long hair, blue hair, vines, plants,
最佳质量,可爱动漫少女,阳光,柔和线条,秋千,蓝白滚边连衣裙,单人,花朵,蓝眼,脸红,蓝色花朵,长发,赤脚,坐姿,注视观众,蓝玫瑰,蓝色主题,玫瑰,光粒子,苍白肌肤,蓝色背景,露肩,全身,微笑,锁骨,长发,蓝发,藤蔓,植物
```
原图(上)vs Qwen Images 文生图(下)
  
**复现参数**
* Model: DreamShaper 8
* Sampling: DPM++ 2M Karras, 30 steps
* CFG: 7.5
* Seed: 12345
* Resolution: 512×768
**肉眼评价**:发色轻微变暖,但连衣裙白边、露肩剪裁、蓝玫瑰与藤蔓光影全部保留,**整体完成度 ≥80%**,可直接当训练集正样本。
## 四、高级玩法:自定义系统提示词
[Section titled “四、高级玩法:自定义系统提示词”](#四高级玩法自定义系统提示词)
工具镜像已内置角色文件,路径:
```text
/root/PromptHeler/roles
├── caption.txt # 反推模型系统提示
├── translator_zh.txt # 中→英翻译模型提示
└── translator_en.txt # 英→中翻译模型提示
```

**示例 1:让模型输出“Stable Diffusion 风格”标签**
打开 `caption.txt`,追加:
```text
You are an AI assistant that describes images in Stable Diffusion tags.
Output only tags, separated by comma. Avoid sentences.
Keywords: masterpiece, best quality, ultra-detailed, official art, 8k wallpaper...
```
**示例 2:专精“古风仙侠”**
```text
You are a Chinese ancient-culture expert.
Describe characters with wuxia/xianxia elements: 汉服,发簪,玉佩,仙剑,霓裳,轻纱,水墨背景...
```
保存后无需重启,下一条任务立即生效。
> 小技巧:把常用风格做成 `roles` 文件夹模板,团队共享,标注一致性直接拉满。
# 通过镜像站下载模型到云主机
🦄
本文面向在共绩算力云主机上部署开源模型的开发者,介绍如何借助 Hugging Face 镜像站,将模型权重直接拉取到云主机的指定目录,便于后续推理、微调或打包为自定义镜像。
> 示例模型:[Tongyi-MAI/Z-Image-Turbo](https://huggingface.co/Tongyi-MAI/Z-Image-Turbo) —— 通义 MAI 团队开源的高性能文生图 Turbo 模型,单卡 16G 显存即可运行,非常适合在共绩 RTX 4090 / L20 / H20 等卡型上快速体验。
>
> > 加速镜像:<[https://hf-mirror.com\>(第三方公益节点,](https://hf-mirror.com\>%EF%BC%88%E7%AC%AC%E4%B8%89%E6%96%B9%E5%85%AC%E7%9B%8A%E8%8A%82%E7%82%B9%EF%BC%8C)**不承诺 100% 可用、不保证带宽、不保证长期稳定运行**)
## 适用场景
[Section titled “适用场景”](#适用场景)
* 云主机实例在国内网络环境下直连 Hugging Face 速度慢或失败
* 需要把模型权重下载到云主机的固定目录(本地盘或共享存储卷),供后续本地加载
* 需要在下载完成后把整套环境打包成自定义镜像,用于弹性部署服务一键启动
## 前置准备
[Section titled “前置准备”](#前置准备)
### 1. 启动一台云主机实例
[Section titled “1. 启动一台云主机实例”](#1-启动一台云主机实例)
在[共绩控制台](https://console.suanli.cn/dashboard)创建云主机实例,镜像可选官方 PyTorch 基础镜像或任意预装 Python 环境的镜像。实例启动后通过浏览器 Console 或 SSH 进入调试终端。

### 2. 规划模型存放目录
[Section titled “2. 规划模型存放目录”](#2-规划模型存放目录)
建议提前规划模型权重的落盘路径,避免散落在系统盘。常见两种选择:
* **本地盘(一次性调试)**:直接放在实例本地目录,例如 `/root/models/`。实例销毁后数据会丢失。
* **共享存储卷(推荐用于长期复用)**:挂载共绩的共享存储卷(PVC),例如 `/mnt/shared/models/`。多个实例、弹性部署服务可共用同一份权重,避免反复下载。共享存储卷的挂载方式参考 [云主机中使用共享存储卷](/docs/cloud-hosting/function-usage-instructions/yvawwrzvcivbypk8vihcgjrkn8c/)。
本文后续示例统一使用 `/root/models/Z-Image-Turbo`,实际使用时按需替换。
```bash
mkdir -p /root/models
cd /root/models
```
### 3. 获取并配置 Hugging Face Token(重要)
[Section titled “3. 获取并配置 Hugging Face Token(重要)”](#3-获取并配置-hugging-face-token重要)
虽然 Z-Image-Turbo 是完全公开的模型,但**强烈建议始终配置 HF Token 再发起下载**,原因:
* 未登录状态下匿名下载有较低的速率上限,容易在大模型仓库触发限流
* 后续一旦需要下载 gated(需申请访问)或 private 模型(如 Llama、Gemma 系列),流程完全一致,不必临时改脚本
* Token 对镜像站同样有效,不会因为切换镜像失效
**Token 获取地址**:<>
创建 Token 时选择 `Read` 权限即可。拿到形如 `hf_xxxxxxxxxxxxxxxxxxxxxxxx` 的字符串后,在终端中通过环境变量注入:
  
```bash
export HF_TOKEN="hf_xxxxxxxxxxxxxxxxxxxxxxxx"
```
> ⚠️ Token 属于敏感凭证,**不要硬编码在脚本、Dockerfile 或打包成的自定义镜像中**,推荐每次在终端临时 `export`,或写入 `~/.bashrc` 个人环境。若需在弹性部署服务中使用,通过环境变量在部署配置中单独注入。
## 核心流程:下载 Z-Image-Turbo
[Section titled “核心流程:下载 Z-Image-Turbo”](#核心流程下载-z-image-turbo)
### 步骤 1:安装 huggingface\_hub
[Section titled “步骤 1:安装 huggingface\_hub”](#步骤-1安装-huggingface_hub)
```bash
pip install -U huggingface_hub
```
安装完成后验证命令可用:
```bash
hf --version
```
### 步骤 2:设置镜像站与 Token 环境变量
[Section titled “步骤 2:设置镜像站与 Token 环境变量”](#步骤-2设置镜像站与-token-环境变量)
```bash
export HF_ENDPOINT="https://hf-mirror.com"
export HF_TOKEN="hf_xxxxxxxxxxxxxxxxxxxxxxxx"
export HF_HUB_DOWNLOAD_TIMEOUT=30
```
三个变量的作用:
* `HF_ENDPOINT`:把默认请求转向镜像站
* `HF_TOKEN`:随请求携带身份,提高速率上限并解锁受限仓库
* `HF_HUB_DOWNLOAD_TIMEOUT`:网络波动时延长单次分片超时,降低中断概率
### 步骤 3:执行下载命令
[Section titled “步骤 3:执行下载命令”](#步骤-3执行下载命令)
```bash
hf download Tongyi-MAI/Z-Image-Turbo \
--local-dir /root/models/Z-Image-Turbo
```
命令含义:
* `Tongyi-MAI/Z-Image-Turbo`:Hugging Face 上的仓库 ID,格式为 `作者/仓库名`
* `--local-dir`:指定权重落盘目录,`hf` 工具会把仓库内的所有文件完整镜像到该路径
下载过程支持断点续传,如果中途网络中断,重新执行同一条命令即可继续。

### 步骤 4:验证下载结果
[Section titled “步骤 4:验证下载结果”](#步骤-4验证下载结果)
```bash
ls -lh /root/models/Z-Image-Turbo
du -sh /root/models/Z-Image-Turbo
```
正常情况下可以看到 `model_index.json`、各子目录(`transformer/`、`vae/`、`text_encoder/` 等)以及若干 `.safetensors` 权重文件,总大小约 12 GB 左右。
## 进阶用法
[Section titled “进阶用法”](#进阶用法)
### 仅下载部分文件
[Section titled “仅下载部分文件”](#仅下载部分文件)
如果只需要特定子模块(例如只要 transformer 权重),可用 `--include` 精确指定:
```bash
hf download Tongyi-MAI/Z-Image-Turbo \
--include "transformer/*" "model_index.json" \
--local-dir /root/models/Z-Image-Turbo
```
反之,可用 `--exclude` 过滤掉不需要的文件(如 `.bin` 或 ONNX 子目录):
```bash
hf download Tongyi-MAI/Z-Image-Turbo \
--exclude "*.bin" "onnx/*" \
--local-dir /root/models/Z-Image-Turbo
```

### 使用 hfd 提升大模型下载速度
[Section titled “使用 hfd 提升大模型下载速度”](#使用-hfd-提升大模型下载速度)
对于几十 GB 以上的仓库,推荐使用多线程下载脚本 `hfd`,并发数更高、稳定性更好。详细用法参考 [Hugging Face 加速配置指南](https://www.gongjiyun.com/docs/platform/resource-acceleration/b8t4wbnsdieruakadxsc2mnrn2f/) 中的「hfd + 多线程下载工具加速」章节:
```bash
wget -O hfd.sh https://hf-cdn.sufy.com/hfd/hfd.sh
chmod +x hfd.sh
mv hfd.sh /usr/local/bin/hfd
export HF_ENDPOINT="https://hf-mirror.com"
hfd Tongyi-MAI/Z-Image-Turbo \
--hf_token $HF_TOKEN \
--local-dir /root/models/Z-Image-Turbo \
-x 4 -j 3
```
`-x 4` 表示每个文件 4 线程分片,`-j 3` 表示同时下载 3 个文件。

### 后台下载,避免 SSH 断开中断
[Section titled “后台下载,避免 SSH 断开中断”](#后台下载避免-ssh-断开中断)
大模型下载耗时较长,通过 SSH 执行时建议使用 `nohup` 或 `screen` 防止会话断开导致任务终止:
```bash
nohup hf download Tongyi-MAI/Z-Image-Turbo \
--local-dir /root/models/Z-Image-Turbo \
> /root/models/download.log 2>&1 &
```
查看进度:
```bash
tail -f /root/models/download.log
```
更系统的后台托管方案参考 \[守护进程(开后台)]\([https://www.gongjiyun.com/docs/cloud-hosting/best-practice/wyp7wfifcixzwfkhfkdc4mlxnrq/。](https://www.gongjiyun.com/docs/cloud-hosting/best-practice/wyp7wfifcixzwfkhfkdc4mlxnrq/%E3%80%82)
## 配合弹性部署:下载一次,多处复用
[Section titled “配合弹性部署:下载一次,多处复用”](#配合弹性部署下载一次多处复用)
弹性部署服务**不支持直接提供命令行终端**,无法在部署实例内现场下载模型。推荐流程:
1. 在云主机中按上述步骤把 Z-Image-Turbo 下载到共享存储卷(例如 `/mnt/shared/models/Z-Image-Turbo`)。
2. 编写推理服务代码,通过本地路径加载模型(而非仓库 ID),例如:
```py
```
pipe = ZImagePipeline.from\_pretrained( “/mnt/shared/models/Z-Image-Turbo”, torch\_dtype=torch.bfloat16, low\_cpu\_mem\_usage=False, )
````plaintext
3. 将包含代码和依赖的云主机环境打包为自定义镜像。
4. 在弹性部署服务中使用该自定义镜像,同时挂载同一份共享存储卷,服务即可开箱加载权重,无需冷启动时再下载。
这样既节省冷启动时间,也避免多实例重复占用存储与带宽。
## 常见问题
Q:下载提示 `401 Unauthorized` 或 `403 Forbidden`?
A:Token 未配置或权限不足。确认 `HF_TOKEN` 已 `export`,且 Token 在 Hugging Face 账号下为 `Read` 及以上权限;若是 gated 模型,需先到仓库页面点击申请并等待通过。
Q:下载一半卡住不动?
A:镜像站节点负载波动所致。按 `Ctrl+C` 中断后重新执行同一条命令,`hf` 工具会自动断点续传。必要时调大 `HF_HUB_DOWNLOAD_TIMEOUT`。
Q:磁盘空间不够?
A:云主机系统盘容量有限,大模型务必下载到共享存储卷或数据盘。下载前先用 `df -h` 确认目标目录所在磁盘的剩余空间大于模型体积的 1.2 倍。
Q:能否跳过镜像站直连?
A:可以,将 `HF_ENDPOINT` 设回默认值即可:
```text
unset HF_ENDPOINT
````
## 注意事项
[Section titled “注意事项”](#注意事项)
* 镜像站为第三方公益服务,稳定性取决于节点状态,不适合作为生产环境的强依赖
* **不要**把 `HF_TOKEN` 硬编码到脚本、Dockerfile 或打包的自定义镜像中,始终通过环境变量注入
* 大模型下载过程中可能出现中断,重复执行命令即可续传
* 不建议在长期脚本或 CI/CD 中硬编码镜像地址,建议通过环境变量统一管理,便于后续替换
* 仅用于学术研究与个人学习用途,请勿用于商业用途或任何违法用途
祝模型下载与部署顺利~
# 如何在 JupyterLab 快速解压文件
👋
小技巧:先在侧边栏中点击进入目标文件夹,再点击 notebook 或者 终端,这样可以直接在目标文件夹下快速在目标文件夹内开始下一步操作
【数据安全必读】
系统盘与数据盘均为本地 SSD,无冗余,单点故障可能导致数据永久丢失。
请务必将重要数据实时备份至「共享存储卷」或本地,共绩算力对本地盘损坏及数据丢失不承担任何责任。
立即开通共享存储卷,获得企业级冗余 + 跨区域同步,彻底告别数据丢失:\
**

## 1.使用 Shell 命令 (最常用)
[Section titled “1.使用 Shell 命令 (最常用)”](#1使用-shell-命令-最常用)
这是最直接、最灵活的方式。Jupyter Notebook 单元格支持直接执行 Shell 命令,只需在命令前加上感叹号 `!` 即可。
1. **打开一个 Notebook (.ipynb 文件)**。
2. 在新的单元格中,根据你的文件类型输入相应的命令。
### 1.1 解压 `.zip` 文件
[Section titled “1.1 解压 .zip 文件”](#11-解压-zip-文件)
使用 `unzip` 命令。
**基本解压到当前目录:**
```text
!unzip your_file_name.zip
```
**解压到指定文件夹 (推荐)**:
```text
!mkdir -p unzipped_data
!unzip your_file_name.zip -d unzipped_data/
```
### 1.2 解压 `.tar.gz` 或 `.tgz` 文件
[Section titled “1.2 解压 .tar.gz 或 .tgz 文件”](#12-解压-targz-或-tgz-文件)
使用 `tar` 命令。
* 基本解压:
* x 代表 extract (提取),z 代表 gzip 格式,v 代表 verbose (显示过程),f 代表 file (指定文件名)。
```text
!tar -xzvf your_archive_name.tar.gz
```
* 解压到指定文件夹 (推荐):
* 使用 -C (大写 C) 选项来指定目标目录。
```text
!mkdir -p untarred_data
!tar -xzvf your_archive_name.tar.gz -C untarred_data/
```
### 1.3 解压 `.tar.bz2` 或 `.tbz2` 文件
[Section titled “1.3 解压 .tar.bz2 或 .tbz2 文件”](#13-解压-tarbz2-或-tbz2-文件)
同样使用 `tar` 命令,只是把 `z` (gzip) 换成 `j` (bzip2)。
```text
!tar -xjvf your_archive_name.tar.bz2 -C destination_folder/
```
### 1.4 解压 `.tar` 文件 (无压缩)
[Section titled “1.4 解压 .tar 文件 (无压缩)”](#14-解压-tar-文件-无压缩)
如果只是一个 `.tar` 包,去掉压缩选项 `z` 或 `j`。
```text
!tar -xvf your_archive_name.tar -C destination_folder/
```
## 2.使用 Python 标准库 (更具编程性)
[Section titled “2.使用 Python 标准库 (更具编程性)”](#2使用-python-标准库-更具编程性)
如果你的工作流程是全自动化的 Python 脚本,或者希望在代码中处理解压逻辑(如错误处理),使用 Python 库是更好的选择。
### 2.1 解压 `.zip` 文件 (使用 `zipfile` 库)
[Section titled “2.1 解压 .zip 文件 (使用 zipfile 库)”](#21-解压-zip-文件-使用-zipfile-库)
```py
import zipfile
import os
zip_path = 'your_file_name.zip'
extract_path = 'unzipped_data_python'# 创建目标文件夹
os.makedirs(extract_path, exist_ok=True)
zip_ref.extractall(extract_path)
print(f"文件已解压到:{extract_path}")
```
### 2.2 解压 `.tar` 文件 (包括 `.gz`, `.bz2`) (使用 `tarfile` 库)
[Section titled “2.2 解压 .tar 文件 (包括 .gz, .bz2) (使用 tarfile 库)”](#22-解压-tar-文件-包括-gz-bz2-使用-tarfile-库)
`tarfile` 库非常智能,可以自动识别压缩类型。
```py
import tarfile
import os
tar_path = 'your_archive_name.tar.gz' # .tar.gz, .tgz, .tar.bz2, .tar 都可以
extract_path = 'untarred_data_python'# 创建目标文件夹
os.makedirs(extract_path, exist_ok=True)
tar_ref.extractall(path=extract_path)
print(f"文件已解压到:{extract_path}")
```
### 2.3 使用 JupyterLab 内置终端
[Section titled “2.3 使用 JupyterLab 内置终端”](#23-使用-jupyterlab-内置终端)
JupyterLab 自带一个功能完整的终端模拟器,这和直接在系统的命令行操作完全一样。
1. 在 JupyterLab 启动器页面点击 **Terminal**,或者通过菜单 `File -> New -> Terminal` 打开。
2. 在打开的终端窗口中,直接输入标准的 shell 命令(**注意:这里不需要加 ****!**)。
```shell
unzip your_file_name.zip -d destination_folder
tar -xzvf your_archive_name.tar.gz -C destination_folder
```
## 3.使用 JupyterLab 扩展 (图形化操作)
[Section titled “3.使用 JupyterLab 扩展 (图形化操作)”](#3使用-jupyterlab-扩展-图形化操作)
对于喜欢点击操作的用户,可以安装社区开发的扩展来实现右键解压。一个不错的选择是 `jupyterlab-unfold`。
**安装扩展** (在 JupyterLab 终端或系统终端中执行):
```text
pip install jupyterlab-unfold
```
或者使用 conda:
```text
mamba install -c conda-forge jupyterlab-unfold
```
**重启 JupyterLab**。
安装成功后,在左侧的文件浏览器中,你只需**右键点击**压缩文件(如 `.zip` 或 `.tar.gz`),就会在菜单中看到 “Unfold here” (在此处解压) 的选项。点击即可完成解压。
## 4.总结与推荐
[Section titled “4.总结与推荐”](#4总结与推荐)
| | | | |
| -------------------- | ---------------------------- | -------------- | ---------------------- |
| 方式 | 优点 | 缺点 | 适用场景 |
| **1. Shell 命令 (!)** | 最快捷、最常用,无需切换界面 | 需要记住不同格式的命令 | 快速查看数据、一次性解压任务 |
| **2. Python 库** | 可编程、可移植,能集成到自动化脚本中 | 代码稍长,不如 ! 命令直接 | 数据预处理流程、需要精细控制或错误处理的脚本 |
| **3. JupyterLab 终端** | 功能最强大,与标准 Linux/macOS 终端体验一致 | 需要额外打开一个终端窗口 | 需要执行复杂 shell 命令或交互式操作时 |
| **4. GUI 扩展** | 无需代码,操作直观 | 需要额外安装和配置扩展 | 偏好图形化界面、不熟悉命令行的用户 |
# 在共绩算力使用 OpenClaw 社区镜像完整指南
👋
与传统的从零安装不同,本方案预先集成了 Node.js 运行环境及 OpenClaw 核心代码。您无需等待漫长的依赖下载和编译过程,只需完成以下三个简单步骤:
1. 发布任务:在控制台一键启动预装镜像。
2. 配置 API:通过 SSH 登录,运行向导填入您的大模型 Key。
3. 隧道连接:建立 SSH 隧道,即可在本地浏览器安全访问云端服务。
## 第一步:登录并检查状态
[Section titled “第一步:登录并检查状态”](#第一步登录并检查状态)
在开始之前,请确认你已登录共绩算力控制台,并可以发布云主机任务。
官网首页点击进入云主机控制台:

点击创建云主机

选择 CPU

选择 OpenClaw 社区镜像:

任务发布成功之后点击更多操作

通过 SSH 或网页终端登录服务器:

检查 `openclaw` 命令是否可用:
```bash
openclaw --version
```
(如果显示版本号,说明环境正常)

***
## 第二步:触发配置向导 (关键)
[Section titled “第二步:触发配置向导 (关键)”](#第二步触发配置向导-关键)
在预装镜像中,您需要手动运行配置命令来进入那个“图形化/交互式”的设置界面。
**执行以下命令:**
```bash
openclaw onboard
```
(或者尝试 openclaw configure,如果 configure 直接进入编辑模式的话)

此时,屏幕会进入全交互模式,请按照您之前提供的流程操作:
1. **风险确认**: 选 **● 是**。
2. **入门模式**: 选 **● 手动** (Manual)。
* 原因:我们需要固定端口为 18789,以便后续 SSH 隧道连接。
3. **配置处理**: 选 **● 更新值**。
4. **模型 Key**: 选择输入您的 API Key,或选择 **跳过**。
5. **模型提供商**: 保持默认或按需选择。
6. **通讯频道**: 推荐选 **Telegram** 或 **暂时跳过**。
7. **技能/Hooks**: 建议都选 **跳过/否** (先跑通核心功能)。

我理解这功能强大但 inherently 存在风险。是否继续?
│ ● 是 / ○ 否

入门模式
│ ○ 快速启动(稍后可通过 `openclaw configure` 配置详细信息。)
│ ● 手动(配置端口、网络、Tailscale 及认证选项。)

◆ 配置处理
│ ○ 使用现有值
│ ● 更新值
│ ○ 重置
配置对应模型的 key:

没有的话可以先跳过,后续也可以配置:

◆ 按提供商筛选模型:

◆ 选择频道(快速启动)
│ ● Telegram (Bot API)(推荐 · 新手友好)
│ ○ WhatsApp (二维码链接)
│ ○ Discord (Bot API)
│ ○ IRC (服务器 + 昵称)
│ ○ Google Chat (Chat API)
│ ○ Slack (Socket 模式)
│ ○ Signal (signal-cli)
│ ○ iMessage (imsg)
│ ○ 飞书/Lark (Feishu/Lark)、
│ ○ Nostr (NIP-04 私信)
│ ○ Microsoft Teams (Bot Framework)
│ ○ Mattermost (插件)
│ ○ Nextcloud Talk (自托管)
│ ○ Matrix (插件)
│ ○ BlueBubbles (macOS 应用)
│ ○ LINE (Messaging API)
│ ○ Zalo (Bot API)
│ ○ Zalo (个人账号)
│ ○ 群晖 Chat (Synology Chat) (Webhook)
│ ○ Tlon (Urbit)
│ ○ 暂时跳过

◆ 现在配置技能?(推荐)
│ ○ 是 / ● 否

启用钩子(Hooks)?空格 之后 enter 选择跳过
 
**🏁 配置完成标志**: 界面最后会显示 `Dashboard ready` 和一个包含 Token 的链接(如 `http://.../#token=xxxx`)。 **👉 此时不要关闭终端,继续下一步。**
***
## 第三步:启动网关服务 (解决 Host 限制)
[Section titled “第三步:启动网关服务 (解决 Host 限制)”](#第三步启动网关服务-解决-host-限制)
配置完成后,服务通常还没有运行,或者运行在受限模式。 **必须使用 ****—dev**** 参数启动**,以允许通过 SSH 隧道从外部访问。
**执行命令:**
```bash
openclaw --dev gateway --port 18789
```

**✅ 成功标志**: 日志显示:
```text
[gateway] listening on ws://127.0.0.1:18789
[heartbeat] started
```
(⚠️ 保持此窗口开启,不要关闭!)
***

## 第四步:获取最新 Token
[Section titled “第四步:获取最新 Token”](#第四步获取最新-token)
由于使用了 `--dev` 模式,系统可能会生成一个新的 Token,覆盖刚才配置时显示的旧 Token。
**打开一个新的终端窗口**(可以通过 SSH) (保持上面的服务窗口不动),再次登录服务器,执行:
```bash
cat ~/.openclaw-dev/openclaw.json | grep token
```
**复制输出的 Token 字符串** (例如 `b9ca8e62...`)。

## 第五步:本地连接 (SSH 隧道)
[Section titled “第五步:本地连接 (SSH 隧道)”](#第五步本地连接-ssh-隧道)
回到您的 **本地电脑 (Windows PowerShell)**:
1. 执行隧道命令:
```powershell
ssh -p 40044(此处替换为自己的对应端口) -N -L 18789:127.0.0.1:18789 root@fdyq1.550w.link(替换成对应的服务地址)
```
1. (输入密码,光标停住即成功)
2. 打开浏览器,访问:
```text
http://localhost:18789/#token=<您刚才查到的新Token>
```
1. (替换 <…> 为实际的 Token 字符串)
***
## 💡 常见问题:如果 `openclaw configure` 没反应?
[Section titled “💡 常见问题:如果 openclaw configure 没反应?”](#-常见问题如果-openclaw-configure-没反应)
如果在预装镜像中运行 `openclaw configure` 直接报错或没有进入交互界面,可能是因为配置文件已存在但损坏,或者路径不对。
**强制重置并重新配置的方法:**
1. **删除旧配置** (⚠️ 注意:这会清除之前的设置,重新开始):
```bash
rm -rf ~/.openclaw
rm -rf ~/.openclaw-dev
```
1. **再次运行配置**:
```bash
openclaw configure
```
1. 此时一定会重新启动完整的交互式向导。
# 云主机最佳实践
## 数据安全必读
[Section titled “数据安全必读”](#数据安全必读)
系统盘与数据盘均为**本地 SSD**,**无冗余机制**,属于单点故障架构,一旦硬件损坏将可能导致**数据永久丢失**。
**重要说明:**
* 本地盘仅适合运行环境与临时数据
* 重要数据必须实时备份
* 平台对本地盘损坏及数据丢失不承担责任
**强制建议的数据安全方案:** 将重要数据实时备份至「共享存储卷」或本地多副本存储系统。
立即开通共享存储卷(企业级冗余 + 跨区域同步):
共享存储卷:单账号 200G 上限可多任务读写的数据盘,目前共享存储卷对大量小文件的写入速率不高,解压等可以先解压到系统盘再转移到共享盘
## 一、快速快速上手总览
[Section titled “一、快速快速上手总览”](#一快速快速上手总览)
流程目标:**从 0 到可用云主机环境**
完整流程分为三步:
1. 使用基础镜像创建云主机
2. 配置实例资源与存储
3. 查看运行状态并进入使用
## 二、创建云主机(Step 1)
[Section titled “二、创建云主机(Step 1)”](#二创建云主机step-1)
## 2.1 进入云主机控制台
[Section titled “2.1 进入云主机控制台”](#21-进入云主机控制台)
访问控制台并进入云主机页面:
点击顶部【云主机】 → 进入云主机管理界面 → 选择可用设备资源

## 2.2 GPU 设备选择逻辑(简化决策模型)
[Section titled “2.2 GPU 设备选择逻辑(简化决策模型)”](#22-gpu-设备选择逻辑简化决策模型)
当前图片中所有 GPU 型号均满足基础部署需求,选择逻辑如下:
### 显存层面
[Section titled “显存层面”](#显存层面)
* 单卡显存 ≥ 24GB
* 已远超大多数服务部署、推理任务、数据处理需求
* 无需担心显存不足问题
### 性价比层面
[Section titled “性价比层面”](#性价比层面)
* 1 卡配置:低成本、按秒计费、适合开发/测试/推理
* 多卡配置:适用于训练任务、高并发、多模型场景
### 实际选择策略
[Section titled “实际选择策略”](#实际选择策略)
* 常规任务(推理、服务部署、数据处理):**1 卡足够**
* 训练任务(LLM、多模态、大模型):再考虑 2 卡 / 4 卡
**结论:** 如果没有明确的大模型训练需求,直接选择 1 卡配置即可,开箱即用、成本可控、无需纠结型号差异。
## 三、配置资源(Step 2)
[Section titled “三、配置资源(Step 2)”](#三配置资源step-2)
## 3.1 实例基础配置
[Section titled “3.1 实例基础配置”](#31-实例基础配置)
### 3.1.1 设置实例名称
[Section titled “3.1.1 设置实例名称”](#311-设置实例名称)
实例名称用于后续管理与识别,建议命名规则:
用途 + 场景 + 日期
示例:
* llm-inference-20260206
* data-process-20260206
* model-train-test
也可使用系统自动生成名称。
### 3.1.2 选择基础镜像
[Section titled “3.1.2 选择基础镜像”](#312-选择基础镜像)
选择平台预制基础镜像即可快速获得完整运行环境。
示例镜像:
* Ubuntu 22.04
* PyTorch 2.1.2
* Python 3.10
* CUDA 11.9

说明:
* 平台已提供完整适配环境
* 无需手动安装 CUDA、驱动、深度学习框架
* 环境一致性强,适合迁移与部署
### 3.1.3 启动命令与启动参数(可选)
[Section titled “3.1.3 启动命令与启动参数(可选)”](#313-启动命令与启动参数可选)
启动命令对应 Kubernetes 中的 `ENTRYPOINT`,启动参数对应 `args`。若基础镜像默认启动行为不满足需求,可在此处自定义覆盖。
示例:
假设需要启动一个自定义 Python 推理服务,可配置如下:
| | | |
| ---- | ------------------- | -------------------- |
| 配置项 | 值 | K8s 对应字段 |
| 启动命令 | python | command (ENTRYPOINT) |
| 启动参数 | -m http.server 8080 | args |
实际效果等同于在容器内执行: `python -m http.server 8080`
不填写则使用基础镜像内置的启动命令(通常为 `supervisord` 启动预设服务)。
### 3.1.4 添加端口映射
[Section titled “3.1.4 添加端口映射”](#314-添加端口映射)
任务支持添加自定义端口,例如添加一个 `8080` 端口后,平台会自动生成一个 HTTPS 公网链接,将该链接的流量转发至任务内部所监听的 `8080` 端口。
适用场景:
* 将 Web 服务(如 JupyterLab、VSCode、Gradio、FastAPI 应用)暴露到公网访问。
具体端口添加操作及云主机内如何监听端口,请参考使用说明: 👉 [云主机端口设置与映射说明](https://www.gongjiyun.com/docs/cloud-hosting/function-usage-instructions/vyvhwddfkixca2km5vxckeeknab/)
## 3.2 挂载共享存储卷(数据安全核心步骤)
[Section titled “3.2 挂载共享存储卷(数据安全核心步骤)”](#32-挂载共享存储卷数据安全核心步骤)
开通共享存储卷服务,并挂载到实例目录:

**挂载规范(非常重要):**
* 禁止挂载到以下目录:
* /
* /root
* 推荐目录结构:
* /root/data
* /root/code
* /root/workspace
说明:
* 根目录挂载会引发系统权限与环境异常问题
* 二级目录结构安全且可控
完成配置后:同意协议 → 点击【创建实例】
## 3.3 对象存储加速桶(大模型与大文件推荐方案)
[Section titled “3.3 对象存储加速桶(大模型与大文件推荐方案)”](#33-对象存储加速桶大模型与大文件推荐方案)
### 使用场景说明
[Section titled “使用场景说明”](#使用场景说明)
当涉及以下数据类型时:
* 大模型权重文件(LLM / 多模态模型 / 向量模型)
* 预训练模型参数
* 大型数据集
* 只读型公共模型文件
* 多实例共享模型文件
**强烈建议使用「对象存储加速桶」挂载到云主机,而不是存放在云主机本地盘或共享存储卷中。**
存储 - 对象存储加速:没有具体上限,可以 s3 协议以只读方式将云上对象存储数据加载到集群内挂载到任务里
***
### 为什么不建议直接存放在云主机本地盘
[Section titled “为什么不建议直接存放在云主机本地盘”](#为什么不建议直接存放在云主机本地盘)
存在以下风险与问题:
1. **存储空间限制风险** 云主机本地盘存在容量上限,大模型文件体积通常为 50GB:
* 可能导致磁盘空间不足
* 镜像无法正常保存
* 环境无法持久化
1. **性能与稳定性风险** 在云主机中直接上传/下载大文件:
* 高峰期网络带宽波动大
* 下载速度不稳定
* 容易出现下载中断、文件损坏
1. **架构设计问题** 本地盘存储模型文件会导致:
* 实例与数据强耦合
* 实例不可快速销毁重建
* 无法实现多实例共享
### 对象存储加速桶的架构优势
[Section titled “对象存储加速桶的架构优势”](#对象存储加速桶的架构优势)
对象存储 + 加速挂载模式具备:
* 高吞吐读取能力
* CDN 级访问加速
* 多实例共享访问
* 只读数据集中管理
* 云主机无状态化
* 模型统一版本管理
**推荐模式**:
计算层:云主机 存储层:对象存储加速桶 安全层:共享存储卷(业务数据)
### 标准使用模型
[Section titled “标准使用模型”](#标准使用模型)
模型/权重文件存放位置:对象存储加速桶(只读)
业务数据/用户数据:共享存储卷(读写)
运行环境:云主机本地盘(临时环境)
形成标准云架构分层:
* 计算层:云主机实例
* 模型层:对象存储
* 数据层:共享存储卷
### 配置文档参考
[Section titled “配置文档参考”](#配置文档参考)
对象存储加速配置说明文档:
## 四、查看运行状态(Step 3)
[Section titled “四、查看运行状态(Step 3)”](#四查看运行状态step-3)
实例创建完成后,可在云主机列表查看运行状态:

状态说明:
* 运行中:可直接连接使用
* 创建中:等待资源初始化
* 停止:可重新启动
***
## 五、核心概念说明
[Section titled “五、核心概念说明”](#五核心概念说明)
## 5.1 GPU 资源模型
[Section titled “5.1 GPU 资源模型”](#51-gpu-资源模型)
逻辑理解模型:
* GPU 数量(1 卡 / 2 卡 / 4 卡 / 8 卡):并行计算能力
* 显存大小:单任务可承载模型规模
* 内存大小:多任务调度能力
* CPU 核心数:数据处理与调度能力
适用场景:
* 1 卡:推理服务、API 部署、数据处理
* 多卡:分布式训练、大模型训练、高并发任务
***
## 5.2 实例名称的管理意义
[Section titled “5.2 实例名称的管理意义”](#52-实例名称的管理意义)
实例名称本质是资源管理标签,用于:
* 成本追踪
* 项目区分
* 运维管理
* 权限管理
推荐命名结构:
项目 + 功能 + 时间
***
## 5.3 基础镜像体系结构说明
[Section titled “5.3 基础镜像体系结构说明”](#53-基础镜像体系结构说明)
### 系统层
[Section titled “系统层”](#系统层)
* Ubuntu 20.04 / 22.04
* CUDA 自动适配 GPU 架构
* apt 源已加速优化
### 运行与管理层
[Section titled “运行与管理层”](#运行与管理层)
* Bash 作为主 Shell
* screen 多会话管理
* supervisord 统一进程管理
* ·基础镜像预装的 JupyterLab、VSCode Server、SSH 服务等均由 `supervisord` 以守护进程方式统一启动与管理,确保服务异常退出后能自动恢复。
### 开发工具层
[Section titled “开发工具层”](#开发工具层)
* SSH Server
* VSCode Server(Python、Pylance、Jupyter、Debugger 插件已配置)
* JupyterLab(Debugger、LSP、TOC、LaTeX、Matplotlib 等插件)
* miniconda(环境管理、Python 依赖管理)
### AI 框架支持(合并展示)
[Section titled “AI 框架支持(合并展示)”](#ai-框架支持合并展示)
**PyTorch:** 1.8.2, 1.13.1, 2.0.1, 2.1.2, 2.2.2, 2.3.1, 2.4.1, 2.5.1, 2.6.0, 2.7.1
**TensorFlow:** 1.15、2.1、2.4、2.7、2.11、2.15、2.18、2.19(按 Python 版本适配)
说明:
* 所有镜像已完成 CUDA / Python / 系统兼容适配
* 环境即开即用
* 无需手动配置驱动与依赖
***
## 六、整体使用逻辑总结
[Section titled “六、整体使用逻辑总结”](#六整体使用逻辑总结)
标准使用结构:
1. 云主机只负责计算
2. 共享存储卷负责数据安全
3. 镜像负责环境一致性
架构模型:
计算层(云主机) + 存储层(共享存储卷) + 环境层(基础镜像)
这是一个标准的云计算安全架构模型,具备:
* 数据安全
* 环境可复制
* 实例可销毁
* 成本可控
* 可扩展性强
## 七、云主机常见问题地址:
[Section titled “七、云主机常见问题地址:”](#七云主机常见问题地址)
# 如何优化云主机共享内存
👋
感谢 **临江喵蓝狐** 用户在 beta 测试期间发现并反馈了 FluxMusic 项目的共享内存问题。正是这个宝贵的实际案例,让我们能够深入分析和总结出这套完整的解决方案。
该用户在使用 Python 3.12 环境运行 FluxMusic 训练时遇到的 Bus error 问题,不仅帮助我们识别了音频深度学习项目中的关键内存瓶颈,也为广大开发者提供了一个典型的故障排查和优化案例。
## 1. 问题描述
[Section titled “1. 问题描述”](#1-问题描述)
### 1.1 典型错误信息
[Section titled “1.1 典型错误信息”](#11-典型错误信息)
```bash
RuntimeError: DataLoader worker (pid 12902) is killed by signal: Bus error.
It is possible that dataloader's workers are out of shared memory.
Please try to raise your shared memory limit.
```
### 1.2 问题场景
[Section titled “1.2 问题场景”](#12-问题场景)
项目:FluxMusic(基于 Flux 扩散模型的音乐生成)
环境:Python 3.12 + PyTorch 分布式训练
硬件:单卡 64GB GPU 内存,128GB 系统内存
初始配置:global\_batch\_size=32, num\_workers=4
现象:直接运行 train.py 报错,调小 batch\_size 后正常
用户实际遇到的困惑:
```text
"emm,pid 进程被杀了,out of shared memory 怎么办?
"怎么提高 shared memory?"
"单卡 64g 内存,oom 有点逆天啊,你怎么操作的?
"emm,可能是参数调大了
```
### 1.3 根本原因分析
[Section titled “1.3 根本原因分析”](#13-根本原因分析)
为什么 64GB GPU 内存还会 OOM?
这里有个常见误区,很多开发者认为 GPU 内存、系统内存和共享内存是一回事,实际上它们是完全不同的概念。共享内存 (shared memory) 是 Linux 系统中专门用于进程间通信的内存区域,通常挂载在 /dev/shm 目录下,默认大小只有 64MB,这个大小与你有多大的 GPU 内存或系统内存完全无关。
当 PyTorch 的 DataLoader 使用多进程加载数据时(num\_workers > 0),每个 worker 进程都需要通过共享内存来传递数据。对于 FluxMusic 这样的音频项目,单个 batch 包含了 CLAP 文本特征、T5 文本特征、梅尔频谱图等大量数据,实际需要 320MB 以上的共享内存空间。然而系统默认只提供 64MB,结果就是 worker 进程刚开始工作就被系统的 OOM-killer 杀死,训练程序甚至都没机会使用你的 64GB GPU 内存。
整个内存使用有三个层次:最底层的共享内存负责 DataLoader 多进程通信,中间层的系统内存负责 Python 进程和数据缓存,最上层的 GPU 内存负责模型参数、梯度和激活值的存储。问题就出现在最底层,所以即使你有再大的 GPU 内存也无济于事。
## 2. 解决方案
[Section titled “2. 解决方案”](#2-解决方案)
### 2.1 立即修复(推荐)
[Section titled “2.1 立即修复(推荐)”](#21-立即修复推荐)
修改参数设置是最快速有效的解决方案,无需修改系统配置,适合紧急情况下快速恢复训练。
```py
python train.py \
--global_batch_size 8 \ # 从 32 降到 8,大幅降低内存需求
--num_workers 1 \ # 从 4 降到 1,最保险的设置
--accum_iter 64 # 从 16 增加到 64,保持训练效果
python train.py \
--global_batch_size 16 \ # 先减半试试
--num_workers 2 \ # 减少一半工作进程
--accum_iter 32 # 相应调整梯度累积
loader = DataLoader(
dataset,
batch_size=4, # 单卡 batch 从 8 降到 4
num_workers=1, # 最安全的设置:单进程
pin_memory=False, # 关闭 pin_memory,节省约 50% 共享内存
persistent_workers=False, # 关闭持久化,进一步减少内存占用
prefetch_factor=1, # 减少预取,默认是 2
)
```
实际效果对比:原始配置使用 batch\_size=32 和 num\_workers=4 时需要约 400MB 共享内存,这远超系统默认的 64MB 限制。如果调整为安全配置 batch\_size=8、num\_workers=1,共享内存需求会降到 80MB 左右,在大多数环境下都能正常运行。中等配置 batch\_size=16、num\_workers=2 的内存需求约为 160MB,需要适当增加共享内存才能稳定运行。
重要提醒:很多人以为”内存越大性能越好”,但实际上对于音频项目来说,num\_workers 超过 2 通常没有明显的加速效果,因为音频数据的预处理相对复杂,CPU 成为瓶颈。而 batch\_size 过大反而可能影响收敛质量,特别是在音频生成这种对细节敏感的任务中。
### 2.2 系统级解决
[Section titled “2.2 系统级解决”](#22-系统级解决)
回答用户问题:“怎么提高 shared memory? ”
这是根治方案,直接解决共享内存不足的根本问题。适合有管理员权限的环境。
#### 2.2.1 检查当前共享内存大小
[Section titled “2.2.1 检查当前共享内存大小”](#221-检查当前共享内存大小)
```bash
df -h /dev/shm
mount | grep shm
```
#### 2.2.2 不同环境的解决方案
[Section titled “2.2.2 不同环境的解决方案”](#222-不同环境的解决方案)
```bash
docker run --shm-size=8G your_image
sudo mount -o remount,size=8G /dev/shm
df -h /dev/shm
echo "tmpfs /dev/shm tmpfs defaults,size=8G 0 0" | sudo tee -a /etc/fstab
sudo mount -a
volumes:
name: shm
emptyDir:
medium: Memory
sizeLimit: 8Gi
volumeMounts:
name: shm
mountPath: /dev/shm
```
#### 2.2.3 共享内存大小推荐
[Section titled “2.2.3 共享内存大小推荐”](#223-共享内存大小推荐)
根据实际使用场景确定大小,图像分类项目由于数据相对简单,通常 2-4GB 就够用了。音频生成项目如 FluxMusic 由于包含音频数据和文本特征的复杂处理,建议配置 8-16GB。视频处理项目涉及超大数据流,需要 16-32GB。而多模态大模型由于数据处理极其复杂,往往需要 32GB 以上的共享内存。
重要警告:需要注意的是共享内存实际占用的是系统 RAM,设置过大会影响其他程序的运行。一般建议不超过系统内存的 25%,比如 64GB 内存的机器,设置 8-16GB 共享内存比较合理,既能满足训练需求,又不会对系统造成太大压力。
#### 2.2.4 验证修改效果
[Section titled “2.2.4 验证修改效果”](#224-验证修改效果)
```bash
df -h /dev/shm
free -h
python train.py --global_batch_size 32 --num_workers 4
```
### 2.3 代码优化
[Section titled “2.3 代码优化”](#23-代码优化)
针对”单卡 64g 内存,oom 有点逆天啊”的困惑
GPU 内存再大也没用,关键是要优化 CPU 侧的多进程策略。
#### 2.3.1 多进程策略优化
[Section titled “2.3.1 多进程策略优化”](#231-多进程策略优化)
```py
import torch.multiprocessing as mp
import os
def main(args):
# 第一步:设置多进程策略(关键)
mp.set_sharing_strategy('file_system') # 用文件系统代替共享内存
mp.set_start_method('spawn', force=True) # Python 3.12 必须用 spawn
# 第二步:环境变量优化
os.environ['OMP_NUM_THREADS'] = '4' # 限制 CPU 线程数
os.environ['MKL_NUM_THREADS'] = '4' # Intel MKL 优化
os.environ['PYTORCH_CUDA_ALLOC_CONF'] = 'max_split_size_mb:128'
os.environ['NUMBA_CACHE_DIR'] = '/tmp/numba_cache' # FluxMusic 项目特有
# 第三步:内存监控(可选)
import psutil
shm_usage = psutil.disk_usage('/dev/shm')
print(f"共享内存状态:{shm_usage.used/(1024**3):.1f}GB / {shm_usage.total/(1024**3):.1f}GB")
# 原有的训练代码...
dist.init_process_group("nccl")
```
#### 2.3.2 DataLoader 安全模式
[Section titled “2.3.2 DataLoader 安全模式”](#232-dataloader-安全模式)
```py
def create_safe_dataloader(dataset, args):
"""为音频项目优化的安全 DataLoader"""
# 计算安全的 batch_size
available_shm = psutil.disk_usage('/dev/shm').total / (1024**3) # GB
if available_shm < 1: # 小于 1GB
batch_size = max(1, args.global_batch_size // 8)
num_workers = 0 # 单进程最安全
elif available_shm < 4: # 1-4GB
batch_size = max(2, args.global_batch_size // 4)
num_workers = 1
else: # 4GB 以上
batch_size = args.global_batch_size // dist.get_world_size()
num_workers = min(2, args.num_workers)
print(f"安全配置:batch_size={batch_size}, num_workers={num_workers}")
return DataLoader(
dataset,
batch_size=batch_size,
num_workers=num_workers,
pin_memory=available_shm > 4, # 大内存才开启 pin_memory
persistent_workers=num_workers > 0,
prefetch_factor=1 if num_workers > 0 else None,
drop_last=True,
shuffle=False,
sampler=DistributedSampler(dataset, rank=dist.get_rank())
)
```
#### 2.3.3 内存泄漏防护
[Section titled “2.3.3 内存泄漏防护”](#233-内存泄漏防护)
```py
def training_loop_with_cleanup(model, dataloader, optimizer):
for epoch in range(args.epochs):
for batch_idx, batch in enumerate(dataloader):
# 训练逻辑
loss = model(batch)
loss.backward()
optimizer.step()
optimizer.zero_grad()
# 定期清理(每 100 步)
if batch_idx % 100 == 0:
# 清理 Python 缓存
import gc
gc.collect()
# 清理 CUDA 缓存
if torch.cuda.is_available():
torch.cuda.empty_cache()
# 监控共享内存
shm_usage = psutil.disk_usage('/dev/shm')
usage_percent = (shm_usage.used / shm_usage.total) * 100
if usage_percent > 80:
print(f"警告:共享内存使用率 {usage_percent:.1f}%")
```
关键要点:使用 file\_system 共享策略虽然在数据传输上会稍慢一些,但可以完全避免共享内存的限制问题,这对于内存需求大的音频项目特别有效。在 Python 3.12 环境下,spawn 模式比传统的 fork 模式更加稳定,能有效避免由 fork 机制导致的内存问题和进程泄漏。另外建立完善的监控机制非常重要,可以帮助提前发现内存泄漏和性能瓶颈,避免训练中途崩溃。
## 3. 最佳实践
[Section titled “3. 最佳实践”](#3-最佳实践)
### 3.1 推荐配置
[Section titled “3.1 推荐配置”](#31-推荐配置)
根据不同使用场景,按照稳定性优先的原则,建议采用分层次的配置策略。开发测试环境下可以使用 batch\_size=8、num\_workers=1 的保守配置,依赖系统默认的 64MB 共享内存就能满足代码调试和功能验证的需求。生产训练环境建议采用 batch\_size=16、num\_workers=2 的中等配置,配合 8GB 共享内存,既能保证训练效率又确保稳定性,适合正式的模型开发工作。高性能集群环境可以考虑 batch\_size=32、num\_workers=4 的激进配置,但需要 16GB 共享内存的支持,主要用于大规模训练和研究实验。
选择原则:优先保证训练稳定性,再考虑性能优化。对于 FluxMusic 等音频项目,建议从生产训练配置开始,因为音频数据的复杂性使得保守的配置往往是最明智的选择。
### 3.2 快速诊断
[Section titled “3.2 快速诊断”](#32-快速诊断)
解答”pid 进程被杀了,out of shared memory 怎么办”
#### 3.2.1 立即诊断步骤
[Section titled “3.2.1 立即诊断步骤”](#321-立即诊断步骤)
```bash
ps aux | grep python | grep train
dmesg | tail -20 | grep -i "killed\|oom\|memory"
df -h /dev/shm
free -h && echo "---" && cat /proc/meminfo | grep -i shm
```
#### 3.2.2 实时监控脚本
[Section titled “3.2.2 实时监控脚本”](#322-实时监控脚本)
```bash
#!/bin/bash
echo "开始监控训练进程..."
while true; do
echo "=== $(date) ==="
# 检查共享内存
shm_info=$(df -h /dev/shm | tail -1)
echo "共享内存状态: $shm_info"
# 检查训练进程
train_processes=$(ps aux | grep python | grep train | wc -l)
echo "训练进程数: $train_processes"
# 检查内存使用前5名
echo "内存使用TOP5:"
ps aux --sort=-%mem | head -6
# 检查是否有OOM
recent_oom=$(dmesg | tail -10 | grep -i "killed\|oom" | tail -1)
if [ ! -z "$recent_oom" ]; then
echo "⚠️ 发现OOM: $recent_oom"
fi
echo "===================="
sleep 10
done
```
#### 3.2.3 问题诊断清单
[Section titled “3.2.3 问题诊断清单”](#323-问题诊断清单)
当遇到”Bus error”时,按顺序检查:
1. 是否真的是共享内存问题?
```bash
dmesg | grep -A5 -B5 "killed.*python"
```
2. 当前共享内存设置是多少?
```bash
df -h /dev/shm
mount | grep shm # 看详细配置
```
3. 训练参数是否设置过激进?
```bash
ps aux | grep python | grep train
```
4. 是否在容器中运行?
```bash
docker inspect | grep -i shm
ls -la /dev/shm
```
#### 3.2.4 常见误区辨析
[Section titled “3.2.4 常见误区辨析”](#324-常见误区辨析)
误区 1:GPU 内存够大就不会 OOM 很多开发者会习惯性地用 nvidia-smi 检查 GPU 内存,或者用 free -h 检查系统内存,但这些都不是关键。真正需要关注的是共享内存的状态,用 df -h /dev/shm 才能看到问题的根源。这是最容易被忽视但最重要的检查点。
误区 2:增加系统内存能解决问题 这是另一个常见的错误认知,以为买更大的内存条就能解决问题。实际上需要做的是配置更大的共享内存分区,这与物理内存的大小没有直接关系,而是操作系统配置的问题。
误区 3:降低 batch\_size 没用 实际上 batch\_size 对共享内存需求的影响非常大,这是最容易被低估的优化手段。从 32 降到 8,共享内存需求可以减少 75%,这往往能够立即解决问题,而且对训练效果的影响相对较小。
#### 3.2.5 自动化诊断脚本
[Section titled “3.2.5 自动化诊断脚本”](#325-自动化诊断脚本)
```py
import psutil
import subprocess
import os
def diagnose_shared_memory():
"""全面诊断共享内存问题"""
print("🔍 共享内存诊断报告")
print("=" * 50)
# 1. 共享内存状态
shm_usage = psutil.disk_usage('/dev/shm')
shm_total_gb = shm_usage.total / (1024**3)
shm_used_gb = shm_usage.used / (1024**3)
shm_percent = (shm_used_gb / shm_total_gb) * 100
print(f"📊 共享内存状态:")
print(f" 总量:{shm_total_gb:.1f}GB")
print(f" 已用:{shm_used_gb:.1f}GB")
print(f" 使用率:{shm_percent:.1f}%")
# 2. 风险评估
if shm_total_gb < 1:
print("⚠️ 警告:共享内存过小,建议增加到 8GB")
elif shm_percent > 80:
print("🚨 危险:共享内存使用率过高,即将 OOM")
else:
print("✅ 正常:共享内存状态良好")
# 3. 推荐配置
print(f"\n💡 推荐配置:")
if shm_total_gb < 4:
print(" batch_size: 8")
print(" num_workers: 1")
print(" pin_memory: False")
else:
print(" batch_size: 16")
print(" num_workers: 2")
print(" pin_memory: True")
if __name__ == "__main__":
diagnose_shared_memory()
```
### 3.3 故障排查流程
[Section titled “3.3 故障排查流程”](#33-故障排查流程)
#### 3.3.1 紧急救援(训练崩了怎么办)
[Section titled “3.3.1 紧急救援(训练崩了怎么办)”](#331-紧急救援训练崩了怎么办)
场景:训练进行到一半突然报 Bus error,所有 worker 都死了
```py
python train.py \
--global_batch_size 8 \ # 直接降到最小
--num_workers 0 \ # 关闭多进程
--resume checkpoint_latest.pt # 从断点恢复
python train.py \
--global_batch_size 4 \
--num_workers 0 \
--accum_iter 128 \ # 大幅增加梯度累积
--resume checkpoint_latest.pt
```
#### 3.3.2 系统化排查(找根本原因)
[Section titled “3.3.2 系统化排查(找根本原因)”](#332-系统化排查找根本原因)
步骤 1:确认问题性质
```bash
dmesg | grep -i "python.*killed"
df -h /dev/shm
```
步骤 2:评估解决方案难度
```bash
sudo echo "有权限" || echo "无权限,只能调参数"
if [ -f /.dockerenv ]; then
echo "在Docker容器中,需要重新启动容器"
else
echo "在裸机上,可以直接修改"
fi
```
步骤 3:选择合适的解决方案
| | | |
| ------------ | -------- | ---------------------------------------- |
| 情况 | 推荐方案 | 操作 |
| 有 sudo 权限,裸机 | 直接增加共享内存 | `sudo mount -o remount,size=8G /dev/shm` |
| 有管理权限,Docker | 重启容器 | `docker run --shm-size=8G ...` |
| 无管理权限 | 调整参数 | `batch_size=8, num_workers=1` |
| 云平台/集群 | 提交工单 | 联系管理员修改配置 |
#### 3.3.3 逐步优化(找最佳参数)
[Section titled “3.3.3 逐步优化(找最佳参数)”](#333-逐步优化找最佳参数)
找到安全配置后,逐步测试性能边界:
```bash
python train.py --global_batch_size 8 --num_workers 1
python train.py --global_batch_size 12 --num_workers 1
python train.py --global_batch_size 16 --num_workers 2
```
#### 3.3.4 预防性措施
[Section titled “3.3.4 预防性措施”](#334-预防性措施)
建立训练前检查清单:
```bash
#!/bin/bash
echo "🔍 训练前环境检查"
shm_size=$(df -h /dev/shm | tail -1 | awk '{print $2}')
echo "共享内存大小: $shm_size"
if [[ "$shm_size" == "64M" ]]; then
echo "⚠️ 警告: 共享内存过小,建议降低batch_size"
fi
if [ "$1" -gt 16 ] && [[ "$shm_size" == "64M" ]]; then
echo "🚨 危险: batch_size太大,可能导致OOM"
echo "建议: batch_size <= 8"
fi
available_space=$(df -h . | tail -1 | awk '{print $4}')
echo "可用磁盘空间: $available_space"
echo "✅ 检查完成,建议在小参数下先测试运行"
```
#### 3.3.5 经验教训总结
[Section titled “3.3.5 经验教训总结”](#335-经验教训总结)
从 FluxMusic 项目中学到的经验:
首先要养成永远先用最保守参数测试的习惯,比如 batch\_size=4、num\_workers=0 这样的极端保守设置,确保能跑起来再逐步优化。这看起来很笨拙,但能避免在错误的方向上浪费大量时间。其次,不要迷信大参数的效果,64GB GPU 并不等于可以随意使用大 batch\_size,音频项目的内存需求模式和图像项目完全不同,有其特殊性。
另外要建立完整的监控习惯,包括训练前检查共享内存状态、训练中持续监控进程状态、一旦发现问题立即降级参数等。最后要准备好应急预案,保存一份确认可用的小参数配置文件,定期保存训练 checkpoint,甚至可以设置自动重启脚本来应对意外情况。
最终建议:宁可跑得慢,也不要跑不起来。稳定性永远比速度重要。
## 4. 总结
[Section titled “4. 总结”](#4-总结)
通过 FluxMusic 项目的实际案例,我们总结出针对各种深度学习项目共享内存问题的系统解决方案:
### 4.1 解决策略优先级
[Section titled “4.1 解决策略优先级”](#41-解决策略优先级)
根治方案是增加系统共享内存到 8 GB,这是一次性彻底解决问题的最佳方式,特别适合生产环境使用,因为它无需修改任何代码,对训练性能也没有任何负面影响。当有系统管理权限时,这应该是首选方案。
快速修复方案是减少 num\_workers 和 batch\_size 参数,这是应急情况下快速恢复训练的有效手段。虽然可能会轻微影响训练速度,但能够立即保证训练的稳定性,特别适合在没有管理员权限或者需要立即恢复训练的场景下使用。
代码优化方案主要是设置合适的 multiprocessing 策略,这能显著提高多进程的稳定性,特别适合 Python 3.12 环境。通过使用 file\_system 共享策略和 spawn 启动模式,可以有效减少对系统共享内存的依赖,从根本上缓解内存压力。
监控预防方案是建立完善的内存使用监控体系,这能帮助提前发现潜在问题,避免训练过程中的突然中断。同时监控数据还能为未来的容量规划提供重要的数据支持,让整个训练流程更加可预测和可控。
### 4.2 最佳实践建议
[Section titled “4.2 最佳实践建议”](#42-最佳实践建议)
对于不同环境的推荐方案:在开发调试阶段,建议使用立即修复方案(方案 2.1),通过调整参数快速验证功能,重点是确保代码能够正常运行,性能优化可以后续考虑。在生产部署阶段,应该优先采用系统级解决方案(方案 2.2),通过增加共享内存来确保长期稳定性,这样可以充分发挥硬件性能而不受限于软件配置。在云端训练环境中,最好结合容器化部署和代码优化,既能享受云平台的便利性,又能通过技术手段实现最佳性能。
特别提醒:音频和视频项目的内存需求模式与图像项目有显著差异,通常要高出 2-3 倍,这主要是因为多模态数据处理的复杂性。在 Python 3.12 环境下需要特别注意多进程策略的设置,新版本对内存管理更加严格。最重要的一点是要牢记 GPU 内存大小与共享内存问题完全无关,这是最容易造成误解的地方,很多开发者会因此在错误的方向上浪费时间。
### 4.3 回答用户核心困惑
[Section titled “4.3 回答用户核心困惑”](#43-回答用户核心困惑)
“单卡 64g 内存,oom 有点逆天啊”
这个困惑反映了一个非常常见的概念混淆。用户提到的 64GB 是 GPU 内存,而实际上 Bus error 是发生在 CPU 侧的共享内存问题。系统的共享内存默认只有 64MB,这个大小与你有多大的 GPU 内存完全无关,即使你有 1TB 的 GPU 内存也不会改变共享内存只有 64MB 的事实。这是最容易造成误解的地方,很多开发者会因此感到非常困惑。
“怎么提高 shared memory” 解决方法根据你的环境而不同。
如果在 Docker 环境中,可以通过添加—shm-size=8G 参数来指定共享内存大小。如果在裸机 Linux 系统上,可以使用 sudo mount -o remount,size=8G /dev/shm命令来临时增加共享内存。如果没有管理员权限无法修改系统配置,那就只能通过降低batch\_size和num\_workers来减少内存需求。
“pid 进程被杀了,out of shared memory 怎么办”
当遇到这种情况时,首先要进行立即救援,使用极度保守的参数如—global\_batch\_size 8 —num\_workers 0 来确保训练能够重新启动。长期解决方案是增加系统共享内存到 8GB 或更大。作为预防措施,建议在每次训练前都检查 df -h /dev/shm 的输出,确保共享内存充足。
推荐组合:容器化部署(8GB 共享内存)+ 保守的训练参数(num\_workers≤2, batch\_size≤16)+ 完善的监控预警,既保证稳定性又维持最佳性能。
这套解决方案直接解决了用户在 FluxMusic 项目中遇到的所有困惑,已验证在多个深度学习项目中有效,可作为类似问题的标准处理流程。
# 如何在云主机中保存应用数据
👋
【数据安全必读】
系统盘与数据盘均为本地 SSD,无冗余,单点故障可能导致数据永久丢失。
请务必将重要数据实时备份至「共享存储卷」或本地,共绩算力对本地盘损坏及数据丢失不承担任何责任。
立即开通共享存储卷,获得企业级冗余 + 跨区域同步,彻底告别数据丢失:\
**
## 1.确认自己需要共享的存储卷
[Section titled “1.确认自己需要共享的存储卷”](#1确认自己需要共享的存储卷)
👋
务必先在 **云主机控制台**** **中确认自己存储桶的使用权限和名称,方便后续使用
 
## 2.创建云主机时选择存储桶挂载到指定目录下
[Section titled “2.创建云主机时选择存储桶挂载到指定目录下”](#2创建云主机时选择存储桶挂载到指定目录下)
参考[快速上手云主机服务](https://www.gongjiyun.com/docs/cloud-hosting/quickstart/rtsfwxqkiiozojkcia9cxrvgntf/)文档开通共享存储卷服务,挂载到本机目录,
> **注意:**
>
> * **挂载存储的时候,不要直接挂载到/、/root、 /root/目录,否则会出现一些奇怪的问题。建议挂载在类似/root/data、/root/code 之类的二级目录。**

同意服务协议,点击【创建实例】按钮,完成云主机的创建过程。
## 3.上传文件,多机共享
[Section titled “3.上传文件,多机共享”](#3上传文件多机共享)
### 3.1 上传文件
[Section titled “3.1 上传文件”](#31-上传文件)
如果之前挂载的目录为 `/root/data` 此时启动 Jupyter Lab 发现目录下已经出现 `data` 文件夹,此时说明挂载共享存储卷已经生效,可以开始在共享存储卷中写入数据。

此时我们开始写入测试程序和数据集在 `/root/data/test` 目录下,该云主机是位于重庆一区任务,**当启动不同区域的任务时我们都能通过共享存储卷访问同一存储桶里挂载的数据**。

### 3.2 换区访问数据
[Section titled “3.2 换区访问数据”](#32-换区访问数据)
此时我们访问浙江一区的云主机,挂载存储桶和对应数据的目录

启动后进入发现之前在重庆一区的数据在浙江一区依然可以继续训练和使用

# 怎么用云主机配置 生图模型 环境并使用自动弹性扩缩容
## 1.背景目标
[Section titled “1.背景目标”](#1背景目标)
**在共绩算力云主机上搭建可弹性伸缩的 SD 生图服务环境,实现:**
* **私有化部署生图模型 API 服务**
* **根据流量自动扩缩容**
* **支持高并发访问**
模型链接:
Stable Diffusion XL 是在 SD 的基础上的一个二阶段的级联扩散模型(Latent Diffusion Model),包括 Base 模型和 Refiner 模型。其中 Base 模型的主要工作和 Stable Diffusion 1.x-2.x 一致,具备文生图(txt2img)、图生图(img2img)、图像 inpainting 等能力。在 Base 模型之后,级联了 Refiner 模型,对 Base 模型生成的图像 Latent 特征进行精细化提升,其本质上是在做图生图的工作。

查看模型环境要求以及必要依赖项

## 2.准备工作
[Section titled “2.准备工作”](#2准备工作)
登录云主机,通过共绩算力平台提供的 Web 终端或 Jupyter 终端登录,直接执行以下命令

登录共绩算力云主机,选择合适的云主机设备(大部分情况选择 4090 即可,如果需要先下载模型的情况。可以选择 CPU 启动 节省成本)

通过刚才的模型环境建议 选择适合的云主机框架环境

**我们推荐在云主机中配置环境,存储模块中(对象存储加速中或者共享存储卷)放模型以达到镜像和模型的分离。**
**目前云主机磁盘限额 80GB,云主机磁盘内存过大会导致 关机/启动 时间过长**

**详细配置过程可以查看本文档底部附录一 附录二**
* **共享存储卷**:主要用于高性能、高并发的**读写**场景。它像传统的硬盘或网络文件系统(如 NFS),可以被多个计算节点同时挂载,支持文件的频繁读写和修改,适合训练数据、模型中间结果、日志等需要频繁读写的场景。
* **对象存储加速挂载**:主要用于高效读取大规模数据,通常是**只读场景**。它将对象存储(如 S3)的数据通过挂载的方式直接呈现为本地文件系统,方便访问和读取,适合加载大数据集、预训练模型等只读需求。
通过共绩算力平台提供的 Web 终端或 Jupyter 终端登录,直接执行接下来的操作
如果需要使用 SSH 远程连接可以参考这篇文档:
 
清理旧环境(彻底消除冲突残留)
```powershell
pip3 uninstall -y torch torchvision torchaudio vllm outlines xformers huggingface-hub openai
rm -rf /opt/miniconda3/lib/python3.12/site-packages/{torch*,vllm*,outlines*,xformers*,huggingface_hub*,openai*}
pip3 cache purge
```
安装核心依赖(经测试无任何冲突)
requirement.txt:
```powershell
python>=3.8
[transformers](https://zhida.zhihu.com/search?content_id=240307647&content_type=Article&match_order=1&q=transformers&zhida_source=entity)>=4.37.0
[accelerate](https://zhida.zhihu.com/search?content_id=240307647&content_type=Article&match_order=1&q=accelerate&zhida_source=entity)>=0.27.0
modelscope>=1.9.5
numpy>=1.22.3
[torch](https://zhida.zhihu.com/search?content_id=240307647&content_type=Article&match_order=1&q=torch&zhida_source=entity)>=1.11.0
[gradio](https://zhida.zhihu.com/search?content_id=240307647&content_type=Article&match_order=1&q=gradio&zhida_source=entity)>=4.8.0
diffusers>=0.26.3
opencv-python>=4.9.0.80
safetensors>=0.4.2
```

验证环境(确保无兼容问题)
执行以下命令,输出均符合预期则环境正常:
```powershell
torch.cuda.is_available()
```
这些依赖都搞定以后,咱们就可以通过下面这部分的代码自验,并且开始下载对应的 stable-diffusion-xl-base-1.0 模型了(耗时较久)
```powershell
我们推荐使用命令行或者 ModelScope SDK 来进行模型的下载。[操作指引](https://www.modelscope.cn/docs/%E6%A8%A1%E5%9E%8B%E7%9A%84%E4%B8%8B%E8%BD%BD)
在下载前,请先通过如下命令安装ModelScope
pip install modelscope
命令行下载
下载完整模型库
modelscope download --model AI-ModelScope/stable-diffusion-xl-base-1.0
下载单个文件到指定本地文件夹(下载载到共享存储卷的路径中(可选))
modelscope download --model AI-ModelScope/stable-diffusion-xl-base-1.0 README.md --local_dir ./dir
更多更丰富的命令行下载选项,可参见[具体文档](https://www.modelscope.cn/docs/models/download#%E4%BD%BF%E7%94%A8%E5%91%BD%E4%BB%A4%E8%A1%8C%E5%B7%A5%E5%85%B7%E4%B8%8B%E8%BD%BD%E6%A8%A1%E5%9E%8B)
SDK下载
#模型下载
from modelscope import snapshot_download
model_dir = snapshot_download('AI-ModelScope/stable-diffusion-xl-base-1.0')
Git下载
请确保 lfs 已经被正确安装
git lfs install
git clone https://www.modelscope.cn/AI-ModelScope/stable-diffusion-xl-base-1.0.git
如果您希望跳过 lfs 大文件下载,可以使用如下命令
GIT_LFS_SKIP_SMUDGE=1 git clone https://www.modelscope.cn/AI-Model
```
## 3.模型调用
[Section titled “3.模型调用”](#3模型调用)
```py
import cv2 # pip install opencv-python
import torch
import gradio as gr
import numpy as np
from modelscope.utils.constant import Tasks
from modelscope.pipelines import pipeline
prompt_dict = {
"None": "{prompt}",
"Enhance": "breathtaking {prompt} . award-winning, professional, highly detailed",
"Anime": "anime artwork {prompt} . anime style, key visual, vibrant, studio anime, highly detailed",
"Photographic": "cinematic photo {prompt} . 35mm photograph, film, bokeh, professional, 4k, highly detailed",
"Digital Art": "concept art {prompt} . digital artwork, illustrative, painterly, matte painting, highly detailed",
"Comic Book": "comic {prompt} . graphic illustration, comic art, graphic novel art, vibrant, highly detailed",
"Fantasy Art": "ethereal fantasy concept art of {prompt} . magnificent, celestial, ethereal, painterly, epic, majestic, magical, fantasy art, cover art, dreamy",
"Analog Film": "analog film photo {prompt} . faded film, desaturated, 35mm photo, grainy, vignette, vintage, Kodachrome, Lomography, stained, highly detailed, found footage",
"Neon Punk": "neonpunk style {prompt} . cyberpunk, vaporwave, neon, vibes, vibrant, stunningly beautiful, crisp, detailed, sleek, ultramodern, magenta highlights, dark purple shadows, high contrast, cinematic, ultra detailed, intricate, professional",
"Isometric": "isometric style {prompt} . vibrant, beautiful, crisp, detailed, ultra detailed, intricate",
"Low Poly": "low-poly style {prompt} . low-poly game art, polygon mesh, jagged, blocky, wireframe edges, centered composition",
"Origami": "origami style {prompt} . paper art, pleated paper, folded, origami art, pleats, cut and fold, centered composition",
"Line Art": "line art drawing {prompt} . professional, sleek, modern, minimalist, graphic, line art, vector graphics",
"Craft Clay": "play-doh style {prompt} . sculpture, clay art, centered composition, Claymation",
"Cinematic": "cinematic film still {prompt} . shallow depth of field, vignette, highly detailed, high budget Hollywood movie, bokeh, cinemascope, moody, epic, gorgeous, film grain, grainy",
"3D Model": "professional 3d model {prompt} . octane render, highly detailed, volumetric, dramatic lighting",
"Pixel Art": "pixel-art {prompt} . low-res, blocky, pixel art style, 8-bit graphics",
"Texture": "texture {prompt} top down close-up"
}
negative_prompt_dict = {
"None": "{negative_prompt}",
"Enhance": "{negative_prompt} ugly, deformed, noisy, blurry, distorted, grainy",
"Anime": "{negative_prompt} photo, deformed, black and white, realism, disfigured, low contrast",
"Photographic": "{negative_prompt} drawing, painting, crayon, sketch, graphite, impressionist, noisy, blurry, soft, deformed, ugly",
"Digital Art": "{negative_prompt} photo, photorealistic, realism, ugly",
"Comic Book": "{negative_prompt} photograph, deformed, glitch, noisy, realistic, stock photo",
"Fantasy Art": "{negative_prompt} photographic, realistic, realism, 35mm film, dslr, cropped, frame, text, deformed, glitch, noise, noisy, off-center, deformed, cross-eyed, closed eyes, bad anatomy, ugly, disfigured, sloppy, duplicate, mutated, black and white",
"Analog Film": "{negative_prompt} painting, drawing, illustration, glitch, deformed, mutated, cross-eyed, ugly, disfigured",
"Neon Punk": "{negative_prompt} painting, drawing, illustration, glitch, deformed, mutated, cross-eyed, ugly, disfigured",
"Isometric": "{negative_prompt} deformed, mutated, ugly, disfigured, blur, blurry, noise, noisy, realistic, photographic",
"Low Poly": "{negative_prompt} noisy, sloppy, messy, grainy, highly detailed, ultra textured, photo",
"Origami": "{negative_prompt} noisy, sloppy, messy, grainy, highly detailed, ultra textured, photo",
"Line Art": "{negative_prompt} anime, photorealistic, 35mm film, deformed, glitch, blurry, noisy, off-center, deformed, cross-eyed, closed eyes, bad anatomy, ugly, disfigured, mutated, realism, realistic, impressionism, expressionism, oil, acrylic",
"Craft Clay": "{negative_prompt} sloppy, messy, grainy, highly detailed, ultra textured, photo",
"Cinematic": "{negative_prompt} anime, cartoon, graphic, text, painting, crayon, graphite, abstract, glitch, deformed, mutated, ugly, disfigured",
"3D Model": "{negative_prompt} ugly, deformed, noisy, low poly, blurry, painting",
"Pixel Art": "{negative_prompt} sloppy, messy, blurry, noisy, highly detailed, ultra textured, photo, realistic",
"Texture": "{negative_prompt} ugly, deformed, noisy, blurry"
}
torch.cuda.empty_cache()
def clear_fn(value):
return "", "", "None", 768, 768, 10, 50, None
def concatenate_images(images):
# 得到每张图片的高度,并存储在列表中
heights = [img.shape[0] for img in images]
# 计算所有图片宽度的总和
max_width = sum([img.shape[1] for img in images])
# 创建一个新的空白图像,大小为最大高度和总宽度
concatenated_image = np.zeros((max(heights), max_width, 3), dtype=np.uint8)
x_offset = 0 # 初始化偏移量为 0
for img in images: # 遍历所有图片
# 将图片复制到新图像的相应位置上
concatenated_image[0:img.shape[0], x_offset:x_offset + img.shape[1], :] = img
x_offset += img.shape[1] # 更新偏移量为下一张图片的起始位置
return concatenated_image # 返回拼接后的图片
pipe = pipeline(task=Tasks.text_to_image_synthesis,
model='AI-ModelScope/stable-diffusion-xl-base-1.0',
use_safetensors=True,
model_revision='v1.0.0')
def display_pipeline(prompt: str,
negative_prompt: str,
style: str = 'None',
height: int = 768,
width: int = 768,
scale: float = 10,
steps: int = 50,
seed: int = 0):
# 如果提示为空,则抛出异常
if not prompt:
raise gr.Error('The validation prompt is missing.')
# 打印预设风格字典中的样式
print(prompt_dict[style])
# 使用预设风格格式化正面提示语
prompt = prompt_dict[style].format(prompt=prompt)
# 使用预设风格格式化负面提示语
negative_prompt = negative_prompt_dict[style].format(negative_prompt=negative_prompt)
# 创建一个随机数生成器,并设定种子以方便复现结果
generator = torch.Generator(device='cuda').manual_seed(seed)
# 调用模型管道生成图片
output = pipe({'text': prompt,
'negative_prompt': negative_prompt,
'num_inference_steps': steps,
'guidance_scale': scale,
'height': height,
'width': width,
'generator': generator
})
# 获取输出结果中的图片
result = output['output_imgs'][0]
# 定义存储图片的路径
image_path = './lora_result.png'
# 将图片写入文件
cv2.imwrite(image_path, result)
# 读取图片文件,并将其从 BGR 格式转换为 RGB 格式
image = cv2.cvtColor(cv2.imread(image_path), cv2.COLOR_BGR2RGB)
# 返回处理后的图片
return image
```
如果你的 GPU 内存不够出现 OOM 的报错,可以尝试以下解决方案:
1. 缓存清理:
```py
gc.collect()
torch.cuda.empty_cache()
```
1. 换个小点的模型:
```py
pipe = pipeline(task=Tasks.text_to_image_synthesis,
model='AI-ModelScope/stable-diffusion-v1-5',
use_safetensors=True,
model_revision='v1.0.0')
```
## 4.基于 gradio 的界面构建
[Section titled “4.基于 gradio 的界面构建”](#4基于-gradio-的界面构建)
同样还是以 gradio 框架为例,通过以下代码快速构建一个用户和模型的交互界面:
```py
with gr.Blocks() as demo:
# 创建一个水平排列的容器,即一行
with gr.Row():
# 在行中创建一个列容器,该容器的大小是默认的两倍
with gr.Column(scale=2):
# 创建一个多行文本框,用于输入提示词
prompt = gr.Textbox(label='提示词', lines=3)
# 创建一个多行文本框,用于输入负向提示词
negative_prompt = gr.Textbox(label='负向提示词', lines=3)
# 创建一个下拉菜单,用于选择风格,列出各种风格选项
style = gr.Dropdown(
['None', 'Enhance', 'Anime', 'Photographic', 'Digital Art', 'Comic Book', 'Fantasy Art', 'Analog Film',
'Cinematic', '3D Model', 'Neon Punk', 'Pixel Art', 'Isometric', 'Low Poly', 'Origami', 'Line Art',
'Craft Clay', 'Texture'], value='None', label='风格')
with gr.Row():
# 创建一个滑块,用于选择图片高度
height = gr.Slider(512, 1024, 768, step=128, label='高度')
# 创建一个滑块,用于选择图片宽度
width = gr.Slider(512, 1024, 768, step=128, label='宽度')
with gr.Row():
# 创建一个滑块,用于选择引导系数
scale = gr.Slider(1, 15, 10, step=.25, label='引导系数')
# 创建一个滑块,用于选择迭代步数
steps = gr.Slider(25, maximum=100, value=50, step=5, label='迭代步数')
# 创建一个滑块,用于选择随机数种子,并且有一个随机化按钮
seed = gr.Slider(minimum=1, step=1, maximum=999999999999999999, randomize=True, label='随机数种子')
# 创建一个水平排列的容器,即一行
with gr.Row():
# 创建一个按钮,用于清除输入
clear = gr.Button("清除")
# 创建一个按钮,用于提交输入并生成图片
submit = gr.Button("提交")
# 在行中创建另一个列容器,该容器的大小是默认的三倍
with gr.Column(scale=3):
# 创建一个用于显示输出图片的组件
output_image = gr.Image()
# 当提交按钮被点击时,调用 display_pipeline 函数并将输入参数传递给它,将结果输出到 output_image 组件
submit.click(fn=display_pipeline, inputs=[prompt, negative_prompt, style, height, width, scale, steps, seed],
outputs=output_image)
# 当清除按钮被点击时,调用 clear_fn 函数,将 clear 作为输入,输出到指定的组件上,并将它们重置为初始状态
clear.click(fn=clear_fn, inputs=clear,
outputs=[prompt, negative_prompt, style, height, width, scale, steps, output_image])
demo.queue(status_update_rate=1).launch(share=False)
```
至此,在本地机器上运行的话(把上述所有代码都粘贴到一个 app.py 脚本,运行即可)
咱们在平台上访问 7860 端口的链接就可以看到效果页面了!

有些小伙伴的 GPU 环境在远处服务器上,还需做一道端口转发,例如:
可以参考这篇文档
[如何使用 SSH 连接云主机](https://www.gongjiyun.com/docs/cloud-hosting/function-usage-instructions/aanqw1zk3iedntkvqc6c6aapnkk/)
```text
(本地执行)ssh -L 9000:127.0.0.1:7860 用户 ID@远程机器 IP
```
然后本地访问 [http://127.0.0.1:9000/](https://link.zhihu.com/?target=http%3A//127.0.0.1%3A9000/) 即可
好啦,如此一来,一个本地的文生图应用就构建完毕
用户在完成一个阶段性配置之后可以通过云主机列表页 保存镜像选项 自定义 tag 保存,方便之后再次使用
 
## 5.非平台基础镜像如何配置 SSH 连接
[Section titled “5.非平台基础镜像如何配置 SSH 连接”](#5非平台基础镜像如何配置-ssh-连接)
可以参考这篇文档:
## 6.如何转换为弹性部署服务(自动弹性扩缩容)
[Section titled “6.如何转换为弹性部署服务(自动弹性扩缩容)”](#6如何转换为弹性部署服务自动弹性扩缩容)
**若您的业务流量存在明显波动或需要按需使用资源以控制成本,强烈建议启用自动扩缩容功能。按需分配资源,避免资源浪费,确保任务稳定运行,提升效率并降低长时间占用成本。**
1. 回到云主机页面,找到“部署服务”

1. 关机并保存镜像,输入镜像标签

1. 选择最新版本

1. 选择 GPU 配置(如 4090),节点默认选择 1 个

1. 挂载存储卷
> **注意:挂载存储的时候,不要直接挂载到/、/root、 /root/目录,否则会出现一些奇怪的问题。建议挂载在类似/root/data、/root/code 之类的二级目录。**

**其他配置根据自己镜像的需要来进行配置**

1. 点击最下方“确认部署”即可,若无问题则会进入节点拉取界面,耐心等待即可
 
**具体的自动弹性扩缩容设置可以参考这篇使用文档:**
**参数设置建议**
**最小节点数**:建议设置为 1,避免冷启动影响。如果业务对响应时间要求极高,可以适当增加。
**最大节点数**:根据预算和业务峰值合理设置。建议先从小值开始,观察实际使用情况后逐步调整。
**队列延迟阈值**:建议设置为 4-10 秒,平衡成本和体验。对于实时性要求高的任务,可以设置较小值。
**空闲超时时间**:建议设置为 300-600 秒,减少冷启动影响的同时控制成本。
## **附录 1 对象存储加速中放置模型**
[Section titled “附录 1 对象存储加速中放置模型”](#附录-1-对象存储加速中放置模型)

点击”新增对象存储配置”按钮,选择云服务商,填写以下信息:
* 配置名称
* 对象存储:服务商、地域、Endpoint(不能带 Bucket)、AccessKey、SecretKey、Bucket 名称
* 加速目录:Bucket 中需进行加速处理的目录(不建议挂载根目录,因这会致使根目录下所有文件被缓存,占用大量空间,且不利于业务的合理分割)

当执行保存配置操作时,系统会自动对配置的可用性进行检测。只有在校验通过之后,配置才可成功保存。在列表中查找到相应配置后,点击“开始加速”选项,接着选择加速区域,此时系统将自动对 JuiceFS 文件系统进行初始化(此过程约需 1 - 2 分钟,期间状态会从蓝色转变为绿色,状态为绿色时已可以挂载此存储桶)。同时,系统还会执行提前预热操作(此操作需从云端将文件下载至本地,因此需等待一定时长。例如,若文件大小为 6.6 G,下载完成大约需要 30 分钟)。
  
**任务发布时挂载**
先选择 GPU、GPU 区域(需要与对象存储选择的加速区域一致)。我的对象存储加速了“浙江一区”,所以我选择“浙江一区”的 4090 GPU。

然后在任务发布页面的”存储配置”区域,选择已配置并加速的 S3 存储桶(当前状态为绿色时,可以直接挂载。**集群内第一次使用需要等待从云端拉取文件到集群**。此操作需从云端将文件下载至本地,因此需等待一定时长。例如,若文件大小为 6.6 G,下载完成大约需要 30 分钟。**集群第二次挂载则会直接从本地拉取模型文件**)。
为每个**对象存储加速目录**填写**容器内的挂载路径**(如 `/mnt/my_model_data`),路径需以 `/` 开头。需要注意两个目录的对应关系。
我这里将对象存储 Bucket 中的 `/qwen1-5/hub/`挂载到了容器中的 `/root/.cache/huggingface` 目录中
提交任务后,容器启动时会自动挂载所选 S3 存储。待容器启动完成后,可进入容器并验证挂载。查看挂载目录下的文件是否存在

详细配置细节可以参考[对象存储加速文档](https://www.gongjiyun.com/docs/flexible-deployment/function-usage-instructions/wqhqwbcf3i6byykijbvct9dkn0e/)
## **附录 2 共享存储卷中放置模型**
[Section titled “附录 2 共享存储卷中放置模型”](#附录-2-共享存储卷中放置模型)

创建新的存储桶:

**重要提醒:**
• 存储桶共享 200.0 GBGB 总容量,可创建多个存储桶
• 单区域桶无流量传输费用,多区域桶会产生区域间同步费用
• 某地区未使用节点 15 天后,缓存组将被自动释放
• 多实例同时读写可能存在短暂延迟,但保证最终一致性
• 建议定期使用存储桶以避免节点释放影响
配置完成后输入挂载路径

在 jupyterlab 中将模型相关配置下载在挂载路径中(例如 /root/data)以实现多机数据共享 达到镜像和模型的分离
# 使用教程——Vscode
👋
【数据安全必读】
系统盘与数据盘均为本地 SSD,无冗余,单点故障可能导致数据永久丢失。
请务必将重要数据实时备份至「共享存储卷」或本地,共绩算力对本地盘损坏及数据丢失不承担任何责任。
立即开通共享存储卷,获得企业级冗余 + 跨区域同步,彻底告别数据丢失:\
**
## 1.启动界面:
[Section titled “1.启动界面:”](#1启动界面)

## 2.编辑页面
[Section titled “2.编辑页面”](#2编辑页面)

### 2.1 活动栏与侧边栏
[Section titled “2.1 活动栏与侧边栏”](#21-活动栏与侧边栏)
界面左侧,通过图标切换不同的功能模块:

* **资源管理器(第一个图标)**:在图片中显示了项目文件结构,其中包含:
* `RUNOOB-TEST` 文件夹:当前工作区的项目文件夹。
* `test.html` 文件:当前正在编辑的 HTML 文件。
* **搜索(第二个图标)**:用于全局搜索文件内容(未激活)。
* **源代码管理(第三个图标)**:显示 Git 状态,方便管理代码版本。
* **运行和调试(第四个图标)**:可以设置断点并运行代码。
* **扩展(第五个图标)**:用于安装和管理插件。
紧邻活动栏右侧,展示当前功能模块的具体内容:
* 当前显示的是 **资源管理器**。
* 项目结构清晰展示,包括:
* `RUNOOB-TEST` 文件夹中的所有文件。
* 当前正在编辑的文件 `test.html`。
### 2.2 编辑区
[Section titled “2.2 编辑区”](#22-编辑区)
位于界面中间,用于显示和编辑文件内容:

### 2.3 状态栏
[Section titled “2.3 状态栏”](#23-状态栏)
位于底部,显示当前文件和编辑环境的信息:

* **Git 状态**:当前分支为 `main`(左下角)。
* **文件信息**:
* 编码格式:UTF-8。
* 行尾序列:LF。
* 当前文件类型:HTML。
* **终端状态**:显示当前打开的终端类型为 `zsh`。
# 使用教程——JupyterLab
JupyterLab 的工作目录为 /root 目录,而非/系统根目录。如需查看根目录/,可以进入终端使用命令行操作。所以存储桶建议挂载 /root/xxx目录下 方便快捷使用 多机数据共享
【数据安全必读】
系统盘与数据盘均为本地 SSD,无冗余,单点故障可能导致数据永久丢失。
请务必将重要数据实时备份至「共享存储卷」或本地,共绩算力对本地盘损坏及数据丢失不承担任何责任。
立即开通共享存储卷,获得企业级冗余 + 跨区域同步,彻底告别数据丢失:\
**
## 基本功能介绍
[Section titled “基本功能介绍”](#基本功能介绍)
进入 jupyterlab,控制台 -> 容器实例 -> Jupyterlab
JupyterLab 界面说明

上传文件

使用 Notebook

打开新终端

访问打开的终端或 Notebook(JupyterLab 在关闭终端/Notebook 选项卡后默认不会终止,仍然在运行)

文件管理
在文件管理区右键

# 基于 ComfyUI 的社区镜像二次创作流程
👋
创作 ComfyUI 的社区镜像——三条路线,总有一款适合你
1. 开箱即用:直接选用平台预装 ComfyUI-Manager 的基础镜像,缺什么节点 模型一键补齐,复制现成工作流即可开工。
2. 全链自建:本地写 Dockerfile,把 ComfyUI、插件、模型、流程一次打包成私有镜像,推到仓库,后续秒级批量部署。
3. 在线改完即存:先拉官方或社区成品镜像跑起来,边跑边调节点/模型,调试满意后“关机→保存为新镜像”,随时复用。
## **一、从云主机 ComfyUI 基础镜像扩展工作流(推荐方式)**
[Section titled “一、从云主机 ComfyUI 基础镜像扩展工作流(推荐方式)”](#一从云主机-comfyui-基础镜像扩展工作流推荐方式)
### **1. 环境准备**
[Section titled “1. 环境准备”](#1-环境准备)

登录共绩算力云主机控制台,在社区镜像中选择我们自带 ComfyUI Manger 的基础镜像
可以直接通过复制或者从上方菜单工作流中直接打开需要的工作流(json 文件)
 
### **2. 下载缺失节点**
[Section titled “2. 下载缺失节点”](#2-下载缺失节点)
* **方法一:通过 ComfyUI Manager 自动安装**

在 WebUI 中点击 **Manager** → Install Missing Custom Nodes,工具会自行搜索缺失节点(如 `ControlNet`、`IP-Adapter`),点击安装。

节点安装完成后按照提示重新启动 comfyUI 刷新浏览器
 
* **方法二:手动克隆节点仓库**以安装 `ControlNet` 为例:
当通过 ComfyUI Manager 自动安装时导入失败此时点击 尝试修复 大概率无法正常修复 

此时我们可以通过 Install via Git URL 来从 github 仓库上直接拉取对应节点的内容
首先找到你要安装的插件的 Git 仓库,如
1. 点击页面中 绿色的 **code** 按钮
2. 点击弹窗的 **https** 选项下输入框后的复制按钮
3. 你将复制得到 的链接

复制进来即可开始下载

### **3. 补全模型与配置文件**
[Section titled “3. 补全模型与配置文件”](#3-补全模型与配置文件)
#### 3.1 通过官方的模型管理器下载补充模型
[Section titled “3.1 通过官方的模型管理器下载补充模型”](#31-通过官方的模型管理器下载补充模型)
 
#### 3.2 外部下载 & 导入模型
[Section titled “3.2 外部下载 & 导入模型”](#32-外部下载--导入模型)
拿 Stable Diffusion XL 举例
* 这是 Stable Diffusion 的最新版本,它在 2.0 版本的基础上进行了进一步的优化和改进。
* XL 版本的主要特点是其更大的模型大小,从 0.98B 扩大到 6.6B 参数,这使得它能够生成更高质量的图像。
* XL 版本还引入了新的功能,如更有艺术感的图像,更真实的图像,以及更清晰可读的字体等。
* 模型官方介绍:[Stable Diffusion xl 1.0 press release](https://stability.ai/news/stable-diffusion-sdxl-1-announcement)
* 下载链接:
* [Base](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0/resolve/main/sd_xl_base_1.0_0.9vae.safetensors?download=true)
* [Refiner](https://huggingface.co/stabilityai/stable-diffusion-xl-refiner-1.0/resolve/main/sd_xl_refiner_1.0.safetensors?download=true)
##### 3.2.1 模型下载
[Section titled “3.2.1 模型下载”](#321-模型下载)
我常用的下载渠道有两个,一个是 HuggingFace,最后一个是 CivitAI 站点。
##### 3.2.2 HuggingFace
[Section titled “3.2.2 HuggingFace”](#322-huggingface)
你可以将 HuggingFace 理解为 AI 届的 Github。上面会有不少人或组织会将他们的模型分享到上面。你可以通过 HuggingFace 的搜索功能来搜索你想要的模型。
比如我们搜索 Stable Diffusion v1.5,你会看到这样的页面,然后我们点击页面里的 Files and versions 按钮(图中 1),接着你会看到很多文件,此时你需要选择你需要下载的模型文件,然后点击下载按钮或者获取到下载的链接后续在节点中进行终端下载操作: `git clone https://huggingface.co/runwayml/stable-diffusion-v1-5`

一般你会看到两种后缀的模型:
* **safetensors**:这种模型一般用的是 numpy 格式保存,这就意味着它只保存了张量数据,没有任何代码,加载这类文件会更安全和更快。
* **ckpt**:这种文件是序列化过的,这意味着它们可能会包含一些恶意代码,加载这类模型就可能会带来安全风险。
所以在上述的案例中,我会推荐你下载 safetensors 格式的模型。
另外,我建议你在搜索模型的时候,需要看看是不是该模型的官方发的,一般我会看模型的下载数,一般下载数越多的模型,越有可能是官方发的。
##### 3.2.3 CivitAI
[Section titled “3.2.3 CivitAI”](#323-civitai)
与 HuggingFace 不同,CivitAI 站点更偏向于 UGC 一些,所以你会看到更多个人训练的模型,但是这并不意味着它们的质量会差,相反,你会发现有些模型的质量非常好。
而且 CivitAI 比 HuggingFace 多了很多好用的功能,比如你可以通过筛选等方式,看到各种各样优秀的模型:
同样的,你也可以通过 CivitAI 的搜索功能来搜索你想要的模型,并下载该模型,以 DreamShaper 为例,你只要点击下载按钮即可下载模型:

##### 3.2.4 模型下载导入镜像
[Section titled “3.2.4 模型下载导入镜像”](#324-模型下载导入镜像)
在获取到模型下载地址后,我们需要将模型通过指令下载到 ComfyUI 的 models 目录下,这样 ComfyUI 才能够加载到对应的模型。

示例指令:`git clone https://huggingface.co/runwayml/stable-diffusion-v1-5`

不同的模型下载在不同的文件夹下

## **二、通过 Dockerfile 构建自定义镜像(进阶方案)**
[Section titled “二、通过 Dockerfile 构建自定义镜像(进阶方案)”](#二通过-dockerfile-构建自定义镜像进阶方案)
**这里从 0-1 起步构建一个 WAN2.2 镜像为示例:**
### 1.工具准备
[Section titled “1.工具准备”](#1工具准备)
一台电脑,稳定的网络环境
### 2.准备 Dockerfile 文件
[Section titled “2.准备 Dockerfile 文件”](#2准备-dockerfile-文件)
1. 找一个合适的位置新建“comfyUI\_WAN2.2”文件夹,并打开
2. 在“comfyUI\_WAN2.2”中分别新建“diffusion\_models”、“text\_encoders”、“vae”、“workflow”文件夹
3. 在“comfyUI\_WAN2.2”新建文本文档,命名为 Dockerfile(注意删去文件后缀)
最终应与下图一致

1. 打开 Dockerfile 文件,直接粘贴以下代码
```docker
FROM ghcr.io/saladtechnologies/comfyui-api:comfy0.3.45-api1.9.2-torch2.7.1-cuda12.8-runtime
ENV COMFYUI_PORT=8188 \
MODEL_DIR=/opt/ComfyUI/models \
BASE=""
RUN mkdir -p ${MODEL_DIR}/{loras,vaes,text_encoders,diffusion_models}
COPY diffusion_models/*.safetensors ${MODEL_DIR}/diffusion_models/
COPY vae/*.safetensors ${MODEL_DIR}/vae/
COPY text_encoders/*.safetensors ${MODEL_DIR}/text_encoders/
COPY workflows/*.json /opt/ComfyUI/user/default/workflows/
EXPOSE ${COMFYUI_PORT}
```
### 3.Hugging face 相关准备
[Section titled “3.Hugging face 相关准备”](#3hugging-face-相关准备)
1. 登录**官网,点击右上角 Sign Up 注册账号

1. 登录后点击右上角头像,点击“Access Tokens”

1. 点击 creat new token,之后选择 write,创建新 token,记得复制并保存
  
### 4.直接下载模型文件
[Section titled “4.直接下载模型文件”](#4直接下载模型文件)
1. 打开 github 官网 [https://github.com/(需要登录),搜索\`comfyUI\`,点击](https://github.com/%EF%BC%88%E9%9C%80%E8%A6%81%E7%99%BB%E5%BD%95\)%EF%BC%8C%E6%90%9C%E7%B4%A2%60comfyUI%60%EF%BC%8C%E7%82%B9%E5%87%BB) `comfyanonymous/`ComfyUI

1. 点开后向下翻,找到,点击*Wan 2.2*

1. 在 Files to Download 一栏中我们需要下载以下两个文件(点击链接,跳转到新页面之后,点击 Download 即可下载)

需注意的是“[umt5\_xxl\_fp8\_e4m3fn\_scaled.safetensors](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files/text_encoders)”中有两个文件,下载 fp8 的那个

1. 之后页面下翻,找到“[wan2.2\_ti2v\_5B\_fp16.safetensors](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/blob/main/split_files/diffusion_models/wan2.2_ti2v_5B_fp16.safetensors)”,点击进入并点击 Download 下载

1. 继续下翻,找到 [Workflow in Json format](https://comfyanonymous.github.io/ComfyUI_examples/wan22/text_to_video_wan22_5B.json) 点击进入,复制页面全部内容

1. 在“workflow”文件夹中创建一个文本文档,改名为`wan2.2_t2v_workflow.json`注意后缀必须是.json,点开文档,复制以上内容
2. 页面继续下翻,在 Image to Video 下还有一个[Workflow in Json format](https://comfyanonymous.github.io/ComfyUI_examples/wan22/image_to_video_wan22_5B.json),同理创建一个`wan2.2_i2v_workflow.json`文档,最终结果如下

1. 将下载的模型文档移动到相应文件夹
* `wan2.2_ti2v_5B_fp16.safetensors`移动到“diffusion\_models”文件夹
* `wan2.2_vae.safetensors`移动到“vae”文件夹
* `umt5_xxl_fp8_e4m3fn_scaled.safetensors`移动到“text\_encoders”文件夹
1. 最终效果如下:
```text
comfyUI_WAN2.2/
├── diffusion_models/
│ └── wan2.2_ti2v_5B_fp16.safetensors
├── text_encoders/
│ └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
├── vae/
│ └── wan2.2_vae.safetensors
├── workflow/
│ ├── wan2.2_i2v_workflow.json
│ └── wan2.2_t2v_workflow.json
└── Dockerfile
```
### 5.通过 Hugging face 镜像站下载模型文件
[Section titled “5.通过 Hugging face 镜像站下载模型文件”](#5通过-hugging-face-镜像站下载模型文件)
(可加快下载速度,提高效率)
1. 准备 Hugging face 镜像站
* 通过 Win+S 搜索 PowerShell 或 CMD,右键选择“以管理员身份运行”(避免权限问题)
* 输入`pip install -c conda-forge huggingface_hub`,回车
* 等待下载

1. 下载模型文件
* 在 PowerShell 中输入`$env:HF_ENDPOINT="https://hf-mirror.com"`,临时配置镜像站

* 继续在 PowerShell 中输入`huggingface-cli login`,输入之前复制并保存的自己的 Token,完成登录

* 分别下载所需模型文件,并放置到相关路径,可通过以下代码完成
```text
完成 huggingface-cli download --repo-type model --local-dir "address" --local-dir-use-symlinks False --resume-download
#其中为所需模型文件名称,address 应替换为对应文件夹地址
```
### 6.执行构建
[Section titled “6.执行构建”](#6执行构建)
1. 打开 Docker Desktop
2. 打开“comfyUI\_WAN2.2”文件夹,在空白处单机鼠标右键,选择“在终端打开”,打开控制台
3. 输入`docker build -t wan-2.2:0.1 .`(可根据需要自行修改标签和镜像名),回车,等待即可

(过程中的一些图片)
1. 操作完成后可在 docker 中查看,或在 powershell 中输入`docker images`查看
 
## **三、直接在共绩算力预制镜像中补充节点**
[Section titled “三、直接在共绩算力预制镜像中补充节点”](#三直接在共绩算力预制镜像中补充节点)
### 1 在云主机上部署 WAN2.2
[Section titled “1 在云主机上部署 WAN2.2”](#1-在云主机上部署-wan22)
我们提供了构建完毕的 WAN2.2 镜像,您可以直接部署使用。
镜像地址:[harbo](http://harbor.suanleme.cn/last1/wan-2.2:0.2)[r.suanleme.cn/last1/wan-2.2:0.2](http://harbor.suanleme.cn/last1/wan-2.2:0.2)
1.1 访问云主机控制台 **,点击创建云主机

1.2 基于自身需要进行配置,参考配置为单卡 4090 和 1 个节点(初次使用进行调试)。

1.3 在我的镜像中填入完整镜像 url
镜像地址:harbor.suanleme.cn/last1/wan-2.2:0.1
添加端口:8188

1.4 点击部署服务,耐心等待节点拉取镜像并启动。
1.5 节点启动后,你所在“任务详情页”中看到的内容可能如下:

1.6 我们可以点击快速访问下方“8188”端口的链接,测试 comfyui 部署情况
系统会自动分配一个可公网访问的域名,点击 8188 端口的链接。接下来我们即可自由地通过使用工作流在 comfyui 中使用 WAN2.2 模型进行图像生成。
### 2 对 WAN2.2 新增节点
[Section titled “2 对 WAN2.2 新增节点”](#2-对-wan22-新增节点)
通过对 wan2.2 工作流的调整,可提高成果质量,根据个人需求新增节点即可,以下展示一种简单的去噪方法作为示范:
1. 进入 8188 端口的 web ui 界面,选择左侧的“工作流“菜单,找到名为”wan2.2\_i2v\_workflow\.json“的工作流文件,鼠标双击进行插入。

1. 在空白处右键,找到“添加节点”中的“采样”,选择“k 采样器”

1. 如图所示与前后对应节点完成连接(三处)

1. 在空白处点击鼠标右键,选择“添加节点”中“Latent”中“视频”下的“空 Latent 视频(混元)”,并将其连接到新建的“k 采样器”
 
1. 这样这个文生视频工作流就得到了进一步的完善,点击“运行”即可对其进行测试
### 3 打包镜像
[Section titled “3 打包镜像”](#3-打包镜像)
可通过重新部署服务,发布为一个新的镜像,转换为弹性部署服务,方便下次使用
(在完成下列操作前,需在共绩算力平台创建个人镜像仓库,具体步骤查看[镜像仓库使用指南](https://www.gongjiyun.com/docs/flexible-deployment/function-usage-instructions/rkicwd7zqi39lmkti9gc5pcungb/)文档)
1. 回到云主机页面,找到“部署服务”

1. 关机并保存镜像,输入镜像标签
 
1. 选择最新版本

1. 选择 GPU 配置(如 4090),节点默认选择 1 个
 
1. 添加端口,只需要一个 8188 端口,若已存在无需再次添加

1. 启动命令与环境变量可根据个人需求配置

1. 点击最下方“确认部署”即可,若无问题则会进入节点拉取界面,耐心等待即可

1. 节点拉取成功后,点击链接即可快速访问服务

注:该镜像已被保存到我的仓库中,再次使用时可在“选择镜像”中找到并使用

# 怎么用云主机配置 LLM 环境并使用自动弹性扩缩容
## 1.背景目标
[Section titled “1.背景目标”](#1背景目标)
**在共绩算力云主机上搭建可弹性伸缩的 Qwen-7B-Chat 服务环境,实现:**
* **私有化部署大模型 API 服务**
* **根据流量自动扩缩容**
* **支持高并发访问**
模型链接:
Qwen-7B 是由阿里云提出的大型语言模型系列 Qwen(简称 Tongyi Qianwen)的 7B 参数版本。Qwen-7B 是一个基于 Transformer 的大型语言模型,预训练于大量数据,包括网页文本、书籍、代码等。此外,基于预训练的 Qwen-7B,我们发布了 Qwen-7B-Chat,一个基于大型模型的 AI 助手,采用对齐技术进行训练。现在我们已经更新了预训练和聊天模型,性能提升。

查看模型环境要求以及必要依赖项

## 2.准备工作
[Section titled “2.准备工作”](#2准备工作)

登录共绩算力云主机,选择合适的云主机设备(大部分情况选择 4090 即可,如果需要先下载模型的情况。可以选择 CPU 启动 节省成本)

通过刚才的模型环境建议 选择适合的云主机框架环境

**我们推荐在云主机中配置环境,存储模块中(对象存储加速中或者共享存储卷)放模型以达到镜像和模型的分离。**
**目前云主机磁盘限额 80GB,云主机磁盘内存过大会导致 关机/启动 时间过长**

**详细配置过程可以查看本文档底部附录一 附录二**
* **共享存储卷**:主要用于高性能、高并发的**读写**场景。它像传统的硬盘或网络文件系统(如 NFS),可以被多个计算节点同时挂载,支持文件的频繁读写和修改,适合训练数据、模型中间结果、日志等需要频繁读写的场景。
* **对象存储加速挂载**:主要用于高效读取大规模数据,通常是**只读场景**。它将对象存储(如 S3)的数据通过挂载的方式直接呈现为本地文件系统,方便访问和读取,适合加载大数据集、预训练模型等只读需求。
通过共绩算力平台提供的 Web 终端或 Jupyter 终端登录,直接执行接下来的操作
如果需要使用 SSH 远程连接可以参考这篇文档:
 
清理旧环境(彻底消除冲突残留)
```powershell
pip3 uninstall -y torch torchvision torchaudio vllm outlines xformers huggingface-hub openai
rm -rf /opt/miniconda3/lib/python3.12/site-packages/{torch*,vllm*,outlines*,xformers*,huggingface_hub*,openai*}
pip3 cache purge
```
安装核心依赖(从模型的说明文档中获取必要的配置信息 然后在云主机中进行安装)
```powershell
pip3 install torch==2.7.1 torchvision==0.22.1 torchaudio==2.7.1 --index-url https://download.pytorch.org/whl/cu128 -i https://pypi.tuna.tsinghua.edu.cn/simple
pip3 install sentencepiece -i https://pypi.tuna.tsinghua.edu.cn/simple --only-binary :all:
pip3 install transformers==4.41.0 accelerate==0.31.0 -i https://pypi.tuna.tsinghua.edu.cn/simple
pip3 install modelscope==1.14.0 -i https://pypi.tuna.tsinghua.edu.cn/simple
```

验证环境(确保无兼容问题)
执行以下命令,输出均符合预期则环境正常:
```powershell
python3 -c "import torch; print('CUDA 可用:', torch.cuda.is_available()); print('GPU 型号:', torch.cuda.get_device_name(0)); print('PyTorch 版本:', torch.__version__)"
python3 -c "from transformers import AutoModelForCausalLM, AutoTokenizer; import modelscope; print('所有库导入成功')"
```
 
## 3.下载 Qwen-7B-Chat 模型
[Section titled “3.下载 Qwen-7B-Chat 模型”](#3下载-qwen-7b-chat-模型)
### **3.1 终端下载模型**
[Section titled “3.1 终端下载模型”](#31-终端下载模型)
云主机启动成功后点击 查看详情——调试终端
  
推荐使用 ModelScope 国内镜像下载,避免 Hugging Face 官方源的网络问题,且自动下载完整配置文件(含 `config.json`、`tokenizer.json` 等):
```powershell
cd /root/models/Qwen-7B-Chat
pip3 install tiktoken -i https://pypi.tuna.tsinghua.edu.cn/simple
pip3 install transformers_stream_generator -i https://pypi.tuna.tsinghua.edu.cn/simple
pip3 install opencv-python -i https://pypi.tuna.tsinghua.edu.cn/simple
pip3 install modelscope fastapi uvicorn pydantic starlette python-multipart -i https://pypi.tuna.tsinghua.edu.cn/simple
pip3 install --upgrade modelscope -i https://pypi.tuna.tsinghua.edu.cn/simple
apt update -y && apt install -y libgl1-mesa-glx
export MODEL_SCOPE_ENDPOINT=https://modelscope.cn/api/v1
modelscope download --model qwen/Qwen-7B-Chat --local-dir /root/models/Qwen-7B-Chat
```
### 3.2 python 代码 下载模型
[Section titled “3.2 python 代码 下载模型”](#32-python-代码-下载模型)
```py
cd /root/models/Qwen-7B-Chat
cat > download_ultimate.py << 'EOF'
from modelscope.hub.snapshot_download import snapshot_download
import os
os.makedirs(os.getcwd(), exist_ok=True)
try:
# 第 1 个参数:模型 ID,第 2 个参数:当前目录(/root/models/Qwen-7B-Chat)
model_dir = snapshot_download("qwen/Qwen-7B-Chat", os.getcwd())
print("\n🎉 模型下载成功!所有文件已保存到:", os.getcwd())
print("💡 立即启动交互:python3 /root/qwen_chat_stream_reset.py")
except Exception as e:
print("\n❌ 下载异常:", str(e))
print("🔧 自动重试(使用默认缓存目录)...")
model_dir = snapshot_download("qwen/Qwen-7B-Chat")
print(f"\n🎉 模型下载成功!默认路径:{model_dir}")
print("📥 正在自动复制到目标目录...")
os.system(f"cp -r {model_dir}/* {os.getcwd()}/")
print("✅ 复制完成!启动命令:python3 /root/qwen_chat_stream_reset.py")
EOF
export MODEL_SCOPE_ENDPOINT=https://modelscope.cn/api/v1 && python3 mxUpload.py
```
### 3.3 验证模型完整性
[Section titled “3.3 验证模型完整性”](#33-验证模型完整性)
下载完成后执行以下命令,确保核心文件存在:
```powershell
ls -l /root/models/Qwen-7B-Chat | grep -E "config.json|tokenizer.json|safetensors"
```
预期输出应包含:`config.json`、`tokenizer.json`、`model-00001-of-00002.safetensors`、`model-00002-of-00002.safetensors`
####

### 3.4 非平台基础镜像如何配置 SSH 连接
[Section titled “3.4 非平台基础镜像如何配置 SSH 连接”](#34-非平台基础镜像如何配置-ssh-连接)
可以参考这篇文档:[如何使用 SSH 连接云主机](https://www.gongjiyun.com/docs/cloud-hosting/function-usage-instructions/aanqw1zk3iedntkvqc6c6aapnkk/)
## 4.编写 Python 启动脚本(控制台循环交互)
[Section titled “4.编写 Python 启动脚本(控制台循环交互)”](#4编写-python-启动脚本控制台循环交互)
从 huggingface 上看到快速使用调用模型脚本代码

创建 `qwen_chat.py` 脚本,代码无任何过时参数,适配当前依赖版本:
* 首次启动:需编译 CUDA 内核,耗时约 5-10 分钟,耐心等待即可;
* 后续启动:直接加载缓存,耗时 1-2 分钟。
```py
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
MODEL_PATH = "/root/models/Qwen-7B-Chat"
def load_model():
"""加载模型和 Tokenizer,仅初始化一次"""
print("正在加载 Qwen-7B-Chat 模型...(首次启动较慢,约 5-10 分钟,请耐心等待)")
# 加载 Tokenizer(适配 Qwen 模型格式)
tokenizer = AutoTokenizer.from_pretrained(
MODEL_PATH,
trust_remote_code=True,
padding_side="right", # 右侧填充,避免生成错误
truncation=True
)
# 加载模型(自动适配 RTX 5090 GPU)
model = AutoModelForCausalLM.from_pretrained(
MODEL_PATH,
trust_remote_code=True,
device_map="auto", # 自动分配 GPU/CPU,优先使用 RTX 5090
torch_dtype=torch.float16, # 显存优化,32GB GPU 足够运行
load_in_8bit=False, # 不量化,保证生成效果
low_cpu_mem_usage=True # 降低 CPU 内存占用
).eval() # 推理模式,禁用 Dropout 确保结果稳定
print("\n✅ 模型加载完成!输入 'quit' 退出对话,输入提示词即可开始交互~")
return tokenizer, model
def chat_loop(tokenizer, model):
"""控制台循环交互"""
while True:
prompt = input("\n请输入提示词:")
if prompt.lower().strip() == "quit":
print("👋 退出对话,感谢使用!")
break
if not prompt.strip():
print("❌ 提示词不能为空,请重新输入~")
continue
# 构建输入(适配 Qwen 模型的 Prompt 格式)
inputs = tokenizer(
prompt,
return_tensors="pt",
truncation=True,
max_length=8192 # 匹配 Qwen 模型最大序列长度
).to(model.device)
# 生成回答(无梯度计算,节省显存)
with torch.no_grad():
outputs = model.generate(
**inputs,
max_new_tokens=1024, # 最大生成 1024 个字符
temperature=0.7, # 随机性:0-1,值越大越灵活
top_p=0.95, # 采样阈值:过滤低概率词汇
do_sample=True, # 启用采样生成
eos_token_id=tokenizer.eos_token_id, # 结束标记
pad_token_id=tokenizer.pad_token_id, # 填充标记
repetition_penalty=1.1 # 重复惩罚,减少废话
)
# 解码并提取回答(去除输入提示词)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
response = response.replace(prompt, "").strip()
# 打印结果
print(f"\n📢 模型回答:\n{response}")
if __name__ == "__main__":
try:
tokenizer, model = load_model()
chat_loop(tokenizer, model)
except Exception as e:
print(f"\n❌ 运行出错:{str(e)}")
print("请检查:1. 模型文件是否完整;2. 依赖包是否安装正确;3. 显存是否充足")
```
## 5.启动模型并交互
[Section titled “5.启动模型并交互”](#5启动模型并交互)
运行脚本
```py
python3 /root/qwen_chat.py
```
```py
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
MODEL_PATH = "/root/models/Qwen-7B-Chat"(如果使用平台共享存储卷存储模型文件就用共享存储卷的路径来下载存储模型文件)
def load_model():
"""加载模型和 Tokenizer,仅初始化一次"""
print("正在加载 Qwen-7B-Chat 模型...(首次启动较慢,约 5-10 分钟,请耐心等待)")
# 加载 Tokenizer(适配 Qwen 模型格式)
tokenizer = AutoTokenizer.from_pretrained(
MODEL_PATH,
trust_remote_code=True,
padding_side="right", # 右侧填充,避免生成错误
truncation=True
)
# 加载模型(自动适配 RTX 5090 GPU)
model = AutoModelForCausalLM.from_pretrained(
MODEL_PATH,
trust_remote_code=True,
device_map="auto", # 自动分配 GPU/CPU,优先使用 RTX 5090
torch_dtype=torch.float16, # 显存优化,32GB GPU 足够运行
load_in_8bit=False, # 不量化,保证生成效果
low_cpu_mem_usage=True # 降低 CPU 内存占用
).eval() # 推理模式,禁用 Dropout 确保结果稳定
print("\n✅ 模型加载完成!输入 'quit' 退出对话,输入提示词即可开始交互~")
return tokenizer, model
def chat_loop(tokenizer, model):
"""控制台循环交互"""
while True:
prompt = input("\n请输入提示词:")
if prompt.lower().strip() == "quit":
print("👋 退出对话,感谢使用!")
break
if not prompt.strip():
print("❌ 提示词不能为空,请重新输入~")
continue
# 构建输入(适配 Qwen 模型的 Prompt 格式)
inputs = tokenizer(
prompt,
return_tensors="pt",
truncation=True,
max_length=8192 # 匹配 Qwen 模型最大序列长度
).to(model.device)
# 生成回答(无梯度计算,节省显存)
with torch.no_grad():
outputs = model.generate(
**inputs,
max_new_tokens=1024, # 最大生成 1024 个字符
temperature=0.7, # 随机性:0-1,值越大越灵活
top_p=0.95, # 采样阈值:过滤低概率词汇
do_sample=True, # 启用采样生成
eos_token_id=tokenizer.eos_token_id, # 结束标记
pad_token_id=tokenizer.pad_token_id, # 填充标记
repetition_penalty=1.1 # 重复惩罚,减少废话
)
# 解码并提取回答(去除输入提示词)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
response = response.replace(prompt, "").strip()
# 打印结果
print(f"\n📢 模型回答:\n{response}")
if __name__ == "__main__":
try:
tokenizer, model = load_model()
chat_loop(tokenizer, model)
except Exception as e:
print(f"\n❌ 运行出错:{str(e)}")
print("请检查:1. 模型文件是否完整;2. 依赖包是否安装正确;3. 显存是否充足")
```
交互示例:
```md
正在加载 Qwen-7B-Chat 模型...(首次启动较慢,约 5-10 分钟,请耐心等待)
✅ 模型加载完成!输入 'quit' 退出对话,输入提示词即可开始交互~
请输入提示词:介绍一下自己
📢 模型回答:
我是 Qwen-7B-Chat 大模型,基于 Transformer 架构训练而成,支持多轮对话、信息查询、创意生成等多种功能。我具备较强的语言理解和生成能力,能够根据你的需求提供准确、流畅的回答,适用于日常交流、学习辅助、工作协作等场景~
请输入提示词:quit
👋 退出对话,感谢使用!
```
## 6.本地调用(远程访问云主机模型)
[Section titled “6.本地调用(远程访问云主机模型)”](#6本地调用远程访问云主机模型)
若需从本地电脑调用云主机上的模型,可在云主机上通过 FastAPI 搭建简单 API 服务:
1. 安装 API 依赖
```powershell
pip3 install fastapi uvicorn pydantic -i https://pypi.tuna.tsinghua.edu.cn/simple
```
1. 创建 API 服务脚本 `qwen_api.py`
```py
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
app = FastAPI(title="Qwen-7B-Chat API")
MODEL_PATH = "/root/models/Qwen-7B-Chat"
tokenizer, model = None, None
@app.on_event("startup")
def startup():
global tokenizer, model
tokenizer = AutoTokenizer.from_pretrained(MODEL_PATH, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
MODEL_PATH, trust_remote_code=True, device_map="auto", torch_dtype=torch.float16
).eval()
class PromptRequest(BaseModel):
prompt: str
@app.post("/generate")
async def generate(request: PromptRequest):
try:
inputs = tokenizer(request.prompt, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model.generate(**inputs, max_new_tokens=1024, temperature=0.7, top_p=0.95)
response = tokenizer.decode(outputs[0], skip_special_tokens=True).replace(request.prompt, "").strip()
return {"prompt": request.prompt, "response": response}
except Exception as e:
raise HTTPException(status_code=500, detail=str(e))
if __name__ == "__main__":
import uvicorn
# 允许外部访问(云主机公网 IP 可访问)
uvicorn.run(app, host="0.0.0.0", port=8000)
```
1. 启动 API 服务
```powershell
nohup python3 /root/qwen_api.py > qwen_api.log 2>&1
```
1. 本地电脑调用脚本 `local_client.py`
```py
import requests
API_URL = "https://云主机公网 IP:8000/generate(任务暴露的公网映射地址链接)"
def call_qwen(prompt):
try:
response = requests.post(API_URL, json={"prompt": prompt}, timeout=60)
if response.status_code == 200:
return response.json()["response"]
else:
return f"调用失败:{response.text}"
except Exception as e:
return f"网络错误:{str(e)}"
if __name__ == "__main__":
while True:
prompt = input("请输入提示词(输入'quit'退出):")
if prompt.lower() == "quit":
break
result = call_qwen(prompt)
print(f"\n模型回答:\n{result}\n")
```
## 7.如何转换为弹性部署服务(自动弹性扩缩容)
[Section titled “7.如何转换为弹性部署服务(自动弹性扩缩容)”](#7如何转换为弹性部署服务自动弹性扩缩容)
**若您的业务流量存在明显波动或需要按需使用资源以控制成本,强烈建议启用自动扩缩容功能。按需分配资源,避免资源浪费,确保任务稳定运行,提升效率并降低长时间占用成本。**
1. 回到云主机页面,找到“部署服务”

1. 关机并保存镜像,输入镜像标签

1. 选择最新版本

1. 选择 GPU 配置(如 4090),节点默认选择 1 个

1. 挂载存储卷
> **注意:挂载存储的时候,不要直接挂载到/、/root、 /root/目录,否则会出现一些奇怪的问题。建议挂载在类似/root/data、/root/code 之类的二级目录。**

**其他配置根据自己镜像的需要来进行配置**

1. 点击最下方“确认部署”即可,若无问题则会进入节点拉取界面,耐心等待即可
 
**具体的自动弹性扩缩容设置可以参考这篇使用文档:******
**参数设置建议**
**最小节点数**:建议设置为 1,避免冷启动影响。如果业务对响应时间要求极高,可以适当增加。
**最大节点数**:根据预算和业务峰值合理设置。建议先从小值开始,观察实际使用情况后逐步调整。
**队列延迟阈值**:建议设置为 4-10 秒,平衡成本和体验。对于实时性要求高的任务,可以设置较小值。
**空闲超时时间**:建议设置为 300-600 秒,减少冷启动影响的同时控制成本。
## **附录 1 对象存储加速中放置模型**
[Section titled “附录 1 对象存储加速中放置模型”](#附录-1-对象存储加速中放置模型)

点击”新增对象存储配置”按钮,选择云服务商,填写以下信息:
* 配置名称
* 对象存储:服务商、地域、Endpoint(不能带 Bucket)、AccessKey、SecretKey、Bucket 名称
* 加速目录:Bucket 中需进行加速处理的目录(不建议挂载根目录,因这会致使根目录下所有文件被缓存,占用大量空间,且不利于业务的合理分割)

当执行保存配置操作时,系统会自动对配置的可用性进行检测。只有在校验通过之后,配置才可成功保存。在列表中查找到相应配置后,点击“开始加速”选项,接着选择加速区域,此时系统将自动对 JuiceFS 文件系统进行初始化(此过程约需 1 - 2 分钟,期间状态会从蓝色转变为绿色,状态为绿色时已可以挂载此存储桶)。同时,系统还会执行提前预热操作(此操作需从云端将文件下载至本地,因此需等待一定时长。例如,若文件大小为 6.6 G,下载完成大约需要 30 分钟)。
  
**任务发布时挂载**
先选择 GPU、GPU 区域(需要与对象存储选择的加速区域一致)。我的对象存储加速了“浙江一区”,所以我选择“浙江一区”的 4090 GPU。

然后在任务发布页面的”存储配置”区域,选择已配置并加速的 S3 存储桶(当前状态为绿色时,可以直接挂载。**集群内第一次使用需要等待从云端拉取文件到集群**。此操作需从云端将文件下载至本地,因此需等待一定时长。例如,若文件大小为 6.6 G,下载完成大约需要 30 分钟。**集群第二次挂载则会直接从本地拉取模型文件**)。
为每个**对象存储加速目录**填写**容器内的挂载路径**(如 `/mnt/my_model_data`),路径需以 `/` 开头。需要注意两个目录的对应关系。
我这里将对象存储 Bucket 中的 `/qwen1-5/hub/`挂载到了容器中的 `/root/.cache/huggingface` 目录中
提交任务后,容器启动时会自动挂载所选 S3 存储。待容器启动完成后,可进入容器并验证挂载。查看挂载目录下的文件是否存在

详细配置细节可以参考[对象存储加速文档](https://www.gongjiyun.com/docs/flexible-deployment/function-usage-instructions/wqhqwbcf3i6byykijbvct9dkn0e/)
## **附录 2 共享存储卷中放置模型**
[Section titled “附录 2 共享存储卷中放置模型”](#附录-2-共享存储卷中放置模型)

创建新的存储桶:

**重要提醒:**
• 存储桶共享 200.0 GBGB 总容量,可创建多个存储桶
• 单区域桶无流量传输费用,多区域桶会产生区域间同步费用
• 某地区未使用节点 15 天后,缓存组将被自动释放
• 多实例同时读写可能存在短暂延迟,但保证最终一致性
• 建议定期使用存储桶以避免节点释放影响
配置完成后输入挂载路径

在 jupyterlab 中将模型相关配置下载在挂载路径中(例如 /root/data)以实现多机数据共享 达到镜像和模型的分离
# 云主机如何设置开机自启动程序
在共绩算力平台上,云主机关机后再次开机,环境和数据会保留,但**之前运行的进程不会自动恢复**。如果您的云主机主要用于运行持续性服务(如 WebUI、API 服务等),每次开机手动启动程序会非常繁琐。
为了实现”开机即运行”,平台支持通过 **Supervisord 配置块**直接在控制台的”启动参数”中注入自启动逻辑。这种方式**无需 SSH 登录机器**,操作极简,且支持进程异常自动重启。
## 为什么推荐这种方式?
[Section titled “为什么推荐这种方式?”](#为什么推荐这种方式)
1. **零侵入性**:无需修改镜像内部的系统文件,配置完全由控制台下发。
2. **进程守护**:当程序因为内存溢出(OOM)或代码报错异常退出时,系统会自动将其拉起(Auto Restart)。
3. **日志集成**:程序的输出可以直接重定向到标准输出,在控制台的”容器日志”面板即可实时查看,排错极其方便。
## 核心操作步骤
[Section titled “核心操作步骤”](#核心操作步骤)
### 1. 在控制台进入启动命令配置
[Section titled “1. 在控制台进入启动命令配置”](#1-在控制台进入启动命令配置)
1. 在云主机列表页,点击进入目标实例的详情页。
2. 切换到 **“设置”** 选项卡。
3. 找到 **“启动命令配置”** 区域。

### 2. 填写配置块
[Section titled “2. 填写配置块”](#2-填写配置块)
在 **“运行参数”** 文本框中(点击”添加启动参数”展开),直接粘贴您的 Supervisord 配置块。以下是一个标准的 Python 程序配置模板:
```text
[program:my_python_app]
command=python /x/y/z/main.py
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
```
**⚠️ 重要警告:关于”运行命令”** 如果您在”运行参数”中填写了配置,**强烈建议同时在”运行命令”框中填写镜像默认的解释器路径**(通常为 `/bin/bash` 或 `/usr/bin/supervisord`)。如果留空,运行参数可能会覆盖镜像默认的 ENTRYPOINT,导致容器启动失败。

### 3. 保存并应用
[Section titled “3. 保存并应用”](#3-保存并应用)
点击右侧的 **“保存”** 按钮,然后点击页面底部的 **“应用修改”**。系统会重启云主机,您的程序将在开机后自动运行。
***
## 常见场景配置示例
[Section titled “常见场景配置示例”](#常见场景配置示例)
### 场景一:启动带有虚拟环境的 Python 程序
[Section titled “场景一:启动带有虚拟环境的 Python 程序”](#场景一启动带有虚拟环境的-python-程序)
如果您使用了 Conda 或 venv,必须在 `command` 中使用虚拟环境内 Python 解释器的**绝对路径**,而不能直接写 `python`。
```text
[program:api_service]
command=/opt/conda/envs/myenv/bin/python /data/project/app.py
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
```
### 场景二:启动 ComfyUI / Stable Diffusion WebUI
[Section titled “场景二:启动 ComfyUI / Stable Diffusion WebUI”](#场景二启动-comfyui--stable-diffusion-webui)
这类应用通常通过 shell 脚本启动(如 `start.sh` 或 `webui.sh`)。
```text
[program:comfyui]
directory=/data/ComfyUI
command=/bin/bash -c "./start.sh --listen --port 8188"
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
```
### 场景三:多服务并发启动
[Section titled “场景三:多服务并发启动”](#场景三多服务并发启动)
如果您需要同时启动一个后端 API 和一个前端页面,可以在同一个文本框内连续粘贴多个配置块。
```text
[program:backend_api]
command=/opt/conda/bin/python /data/backend/main.py
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
[program:frontend_web]
command=npm run start
directory=/data/frontend
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
```
***
## 常见问题排查 (FAQ)
[Section titled “常见问题排查 (FAQ)”](#常见问题排查-faq)
**Q1:配置了自启动,但程序没有运行,如何排查?** **答**:由于我们在配置中将 `stdout_logfile` 和 `stderr_logfile` 设置为了`/dev/stdout` 和 `/dev/stderr`,程序的所有输出都会被捕获。请前往控制台的**”日志/事件/终端 -> 容器日志”**面板,您会直接看到报错信息(如”文件不存在”、“ModuleNotFoundError”等)。
**Q2:日志显示** `can't find command`**?** **答**:这通常是因为环境变量没有加载。Supervisord 启动进程时,默认只有极少的环境变量。**强烈建议在** `command`**中使用绝对路径**(例如 `/usr/local/bin/node` 而不是 `node`)。
**Q3:为什么配置后云主机一直处于”启动中”或不断重启?** **答**:可能是您的程序启动即崩溃,触发了 `autorestart=true`的无限循环。请立即前往”容器日志”面板,勾选\*\*“显示上一个容器退出时的日志”\*\*,查看导致崩溃的致命报错。
# Vscode 通过 Remote ssh 连接云主机
本功能依赖于平台 ssh 连接功能。需要使用支持 ssh 连接的镜像。
## 适用场景
[Section titled “适用场景”](#适用场景)
在本地通过 Visual Studio Code Remote - SSH extension 扩展连接共绩算力云主机进行远程开发。

| | | |
| ------------------------------------- | ------------------------ | ----------------------------------- |
| | 优点 | 缺点 |
| Visual Studio Code Remote SSH (开发者推荐) | 支持多屏幕 颜值高 完整的 VS Code 体验 | 配置难度高 需要本地安装软件 |
| Code Server (新手推荐) | **浏览器访问** | 没有 Visual Studio Code Remote SSH 灵活 |
| Jupyter Lab(科研推荐) | **浏览器访问** | 界面不够美观 |
| 其他 SSH 客户端 | 自定义程度高,可配合 tmux,无需图像界面。 | 难度高 |
## 操作系统设置
[Section titled “操作系统设置”](#操作系统设置)
Windows 首次使用需要开启 设置 - 系统 - 可选功能 - 参看功能 - 可用功能 - OpenSSH 客户端
可选功能快捷链接:ms-settings:optionalfeatures (复制到浏览器上方搜索栏位打开)
MAC OS, 默认已经安装。
Linux 大多数发行版默认已经安装。若无安装可搜索 发行版名 + ssh client install。
## 云主机设置
[Section titled “云主机设置”](#云主机设置)
1.进入 创建云主机,选择支持 ssh 的设备。
2.选择镜像 -> 基础镜像 -> 请选择镜像 ->

选择版本 -> 确认

创建实例

在创建后平台会给出 ssh 登陆信息。

命令 `ssh root@xnc1.550c.cloud -p 350xx`
密码 `tfxdn35921%&$xxxxx`
## Vscode 设置
[Section titled “Vscode 设置”](#vscode-设置)
在本地安装好 Vscode 后安装以下扩展。
按照以下操作添加服务器( ”+” 需要鼠标靠近后才会出现)
 
输入
命令 `ssh root@xnc1.550c.cloud -p 350xx` (替换成你自己的命令)。
回车后出现

点击 → (需要鼠标靠近后才会出现)
选择后按照引导按回车或者输入密码即可连接云主机,首次连接需要下载 Vscode server 时间会比较久。过程中提示输入密码记得输入。
完成连接如下图,出现左侧出现文件树或是命令行出现即为连接成功。

# 社区镜像创作上传流程指引
## 1.云主机操作流程指引
[Section titled “1.云主机操作流程指引”](#1云主机操作流程指引)
### 1.1 官网地址:
[Section titled “1.1 官网地址:https://www.gongjiyun.com/”](#11-官网地址httpswwwgongjiyuncom)
### 1.2 云主机产品操作流程
[Section titled “1.2 云主机产品操作流程”](#12-云主机产品操作流程)
推荐您使用我们的云主机产品(预制镜像预配置主流深度学习框架或者社区镜像中的携带 ComfyUI-Manager 的 ComfyUI 基础镜像 进行二次开发)

点击按钮进入云主机控制台

设备选择根据您的需求来选择,地区都经过我们测试过,速率都很快

### 1.3 选择基础镜像或者 ComfyUI 基础镜像
[Section titled “1.3 选择基础镜像或者 ComfyUI 基础镜像”](#13-选择基础镜像或者-comfyui-基础镜像)
选择完地区后可以选择我们的预制镜像(预配置主流深度学习框架)或者社区镜像中的携带 ComfyUI-Manager 的 ComfyUI 基础镜像进行二次开发
 
云主机发布成功后点击 更多操作 - 查看详情 进入镜像详情界面(我们的基础镜像中预配置了相关的 Jupyterlab 环境和 Vscode 环境)可以直接二次开发使用

## 2.发布为一个新的镜像
[Section titled “2.发布为一个新的镜像”](#2发布为一个新的镜像)
### 2.1 当您二次开发完之后通过设备管理中 `部署服务` 发布您的镜像便于社区其他用户使用
[Section titled “2.1 当您二次开发完之后通过设备管理中 部署服务 发布您的镜像便于社区其他用户使用”](#21-当您二次开发完之后通过设备管理中-部署服务--发布您的镜像便于社区其他用户使用)

### 2.2 关机并保存镜像,输入镜像标签
[Section titled “2.2 关机并保存镜像,输入镜像标签”](#22-关机并保存镜像输入镜像标签)

### 2.3 选择最新版本
[Section titled “2.3 选择最新版本”](#23-选择最新版本)

### 2.4 选择 GPU 配置(如 4090),节点默认选择 1 个
[Section titled “2.4 选择 GPU 配置(如 4090),节点默认选择 1 个”](#24-选择-gpu-配置如-4090节点默认选择-1-个)

### 2.5 添加端口
[Section titled “2.5 添加端口”](#25-添加端口)
建议:只暴露应用程序实际需要的服务端口

### 2.6 配置启动命令
[Section titled “2.6 配置启动命令”](#26-配置启动命令)
启动命令与环境变量可根据个人需求配置,如果是从我们的基础镜像二次开发需要再次配置一下启动命令,可以参考[服务部署中如何使用基础镜像/通过基础镜像保存的镜像](https://www.gongjiyun.com/docs/cloud-hosting/function-usage-instructions/taaewpcy3ierj6km0okcmr40nuc/)
### 2.7 确认部署
[Section titled “2.7 确认部署”](#27-确认部署)
点击最下方“确认部署”即可,若无问题则会进入节点拉取界面,耐心等待即可

节点拉取成功后,点击链接即可快速访问服务 您可以测试下您的服务是否正常
### 2.8 镜像地址收集
[Section titled “2.8 镜像地址收集”](#28-镜像地址收集)
镜像地址收集:通过弹性部署页面的设置中,您可以获取到您的镜像地址 复制出来提交表单和镜像相关的配置即可

### 2.9 社区镜像地址提交表单
[Section titled “2.9 社区镜像地址提交表单”](#29-社区镜像地址提交表单)
社区镜像地址收集表单:您填写完成后可以在对应的创作者交流群内提醒我们,我们测试完成后会上线镜像并及时通知您
当您二次开发还未完成时可以通过设备管理中 `关机并保存镜像` ,方便下次接着上回的进度开发

镜像关机完成后下次可以通过云主机列表上的 `开机` 按钮再次启动
 
## 3.常见问题:
[Section titled “3.常见问题:”](#3常见问题)
Q: 为什么 GitHub/Hugging Face 访问困难(速度慢、镜像站不清楚、TLS 无效)?
A: 由于 Github 和 Hugging Face 等网站的限制,访问有时不稳定,推荐您可以多刷新访问几次试试。 如果是需要下载 Hugging Face 上的模型的话可以通过添加环境变量访问国内镜像站 `HF_ENDPOINT=https://hf-mirror.com` 进行下载。
Q:为方便用户使用,是否不打算将热门模型作为公共库或提供公共的对象存储?
A:我们有这个规划,用户高频使用的模型会被收录到官方提供的对象存储仓库,供平台用户使用。
Q:几十上百 GB 的模型不可能打包进镜像,平台有公共模型库吗?
A:
1. 目前平台推荐把高频使用的模型上传到阿里云/腾讯云的对象存储(OSS/COS)。
2. 平台侧配置对象存储的只读挂载,任务启动时自动把所需模型缓存到集群本地盘。
3. 任务容器通过只读挂载路径(如 `/models/public/`)即可直接使用模型,无需重复下载。
4. 参考官方文档[对象存储加速使用说明](https://www.gongjiyun.com/docs/storage-service/object-storage-acceleration/nceowz55diqv9hkid8wcgkosnkg/)
文档中包含:
* 创建对象存储 Bucket 并上传模型
* 在平台「数据卷」里绑定对象存储路径
* 在任务 YAML 中添加 `volumeMounts` 示例
流程图示意:

# 通过镜像站下载插件并编译
本文面向在共绩算力云主机上做推理框架部署、模型训练加速的开发者,介绍如何借助 GitHub 镜像站把需要编译的插件源码拉取到云主机,再完成本地编译安装。常见场景包括 flash-attention、xformers、apex、triton 等需要 CUDA 扩展的 Python 包,核心流程一致。
> 示例插件:[Dao-AILab/flash-attention](https://github.com/Dao-AILab/flash-attention) —— Tri Dao 团队开源的高性能注意力算子,是 vLLM、SGLang 等推理框架的关键依赖。 加速代理:(第三方公益节点,**不承诺 100% 可用、不保证带宽、不保证长期稳定运行**)
## 适用场景
[Section titled “适用场景”](#适用场景)
* 云主机实例在国内网络环境下直连 GitHub 克隆速度慢或失败
* 需要源码编译的 Python 扩展包(flash-attention、xformers、apex 等)拉取困难
* 官方 PyPI wheel 与云主机的 CUDA / PyTorch 版本不匹配,必须本地编译
* 编译完成后需要把环境打包成自定义镜像,供弹性部署服务一键使用
## 前置准备
[Section titled “前置准备”](#前置准备)
### 启动带 CUDA 环境的云主机实例
[Section titled “启动带 CUDA 环境的云主机实例”](#启动带-cuda-环境的云主机实例)
在[共绩控制台](https://console.suanli.cn/dashboard)创建云主机实例,选择官方 PyTorch / CUDA 基础镜像(如 `pytorch:2.3.0-cuda12.1-cudnn8-devel`),确保镜像内包含 `nvcc` 编译器而非仅 runtime。实例启动后通过浏览器 Console 或 SSH 进入调试终端。

验证编译工具链:
```bash
nvcc --version
python -c "import torch; print(torch.__version__, torch.version.cuda)"
gcc --version
```
### 规划插件源码与编译目录
[Section titled “规划插件源码与编译目录”](#规划插件源码与编译目录)
推荐把源码集中放在一个固定目录,便于后续回溯和重编译:
* **本地盘(快速试验)**:`/root/plugins/`,实例销毁后丢失
* **共享存储卷(推荐)**:`/mnt/shared/plugins/`,编译完成后可复用到其他云主机或弹性部署服务。共享存储卷的挂载方式参考 [云主机中使用共享存储卷](https://www.gongjiyun.com/docs/storage-service/shared-storage-volume/u5d3wiyetiazdckqxs7cvtuxndc/)。
本文后续示例统一使用 `/root/plugins/`,实际使用时按需替换。
```bash
mkdir -p /root/plugins
cd /root/plugins
```
### 配置 GitHub Personal Access Token(按需)
[Section titled “配置 GitHub Personal Access Token(按需)”](#配置-github-personal-access-token按需)
公开仓库(如 flash-attention)无需 Token 即可克隆。但有两种情况建议提前准备:
* 团队内部的 **私有仓库**:镜像站不支持 SSH 协议(`git@github.com:...` 无效),必须用 HTTPS + Token 克隆
* 高频克隆触发 GitHub **匿名访问速率限制**:携带 Token 的请求有更高配额
**Token 获取地址**:
生成时选择 `repo` 作用域即可。拿到形如 `ghp_xxxxxxxxxxxxxxxxxxxxxxxx` 的字符串后通过环境变量注入:
```bash
export GITHUB_TOKEN="ghp_xxxxxxxxxxxxxxxxxxxxxxxx"
```
> ⚠️ Token 属于敏感凭证,**不要硬编码在脚本、Dockerfile 或打包成的自定义镜像中**,推荐每次在终端临时 `export`,或写入 `~/.bashrc` 个人环境。
## 核心流程:下载并编译 flash-attention
[Section titled “核心流程:下载并编译 flash-attention”](#核心流程下载并编译-flash-attention)
### 步骤 1:通过镜像站克隆源码
[Section titled “步骤 1:通过镜像站克隆源码”](#步骤-1通过镜像站克隆源码)
公开仓库直接在原始 URL 前拼接 `https://ghfast.top/` 即可:
```bash
cd /root/plugins
git clone https://ghfast.top/https://github.com/Dao-AILab/flash-attention.git
```

如果是 **私有仓库**,格式为:
```bash
git clone https://用户名:$GITHUB_TOKEN@ghfast.top/https://github.com/用户名/仓库名.git
```
### 步骤 2:切换到目标版本
[Section titled “步骤 2:切换到目标版本”](#步骤-2切换到目标版本)
编译型插件对版本敏感,务必锁定到具体 tag,避免 main 分支的 breaking change 导致编译失败。
```bash
cd /root/plugins/flash-attention
git checkout v2.7.2.post1
```
查看所有可用 tag:
```bash
git tag --sort=-v:refname | head -20
```
### 步骤 3:安装编译依赖
[Section titled “步骤 3:安装编译依赖”](#步骤-3安装编译依赖)
flash-attention 的编译过程依赖 `ninja`(否则默认串行编译,单次编译耗时可达数小时):
```bash
pip install ninja packaging wheel
```
验证 ninja 可用:
```bash
ninja --version
```
### 步骤 4:设置编译环境变量
[Section titled “步骤 4:设置编译环境变量”](#步骤-4设置编译环境变量)
CUDA 扩展编译会占用大量 CPU 与内存。如果不限制并行度,容易在编译中途 OOM 被 kill。
```bash
export MAX_JOBS=4
export TORCH_CUDA_ARCH_LIST="8.9"
export FLASH_ATTENTION_FORCE_BUILD=TRUE
```
三个变量的作用:
* `MAX_JOBS`:限制 ninja 并行编译任务数,4090 实例一般设 4;内存充裕可设到 8
* `TORCH_CUDA_ARCH_LIST`:指定编译目标架构,只编当前 GPU 对应架构能显著缩短耗时
* RTX 4090 / L20 / L40:`8.9`
* A100:`8.0`
* H20 / H800 / H100:`9.0`
* 如需跨卡通用镜像:`"8.0;8.9;9.0"`
* `FLASH_ATTENTION_FORCE_BUILD`:强制从源码编译,不尝试拉取官方 wheel
### 步骤 5:执行编译安装
[Section titled “步骤 5:执行编译安装”](#步骤-5执行编译安装)
```bash
cd /root/plugins/flash-attention
pip install -e . --no-build-isolation
```
两个关键参数:
* `-e`:editable 安装,源码目录直接挂载为包路径,方便后续本地改代码调试
* `--no-build-isolation`:复用当前环境的 PyTorch、CUDA,避免 pip 在临时虚拟环境中重装 torch 导致 ABI 不匹配
编译耗时在 4090 上大约 20\~40 分钟,取决于 `MAX_JOBS` 与 `TORCH_CUDA_ARCH_LIST` 配置。
### 步骤 6:验证安装
[Section titled “步骤 6:验证安装”](#步骤-6验证安装)
```bash
python -c "import flash_attn; print(flash_attn.__version__)"
python -c "from flash_attn import flash_attn_func; print(flash_attn_func)"
```
能够正常打印版本号与函数对象,即表示编译安装成功。
## 进阶用法
[Section titled “进阶用法”](#进阶用法)
### 优先使用 Releases 预编译 wheel
[Section titled “优先使用 Releases 预编译 wheel”](#优先使用-releases-预编译-wheel)
flash-attention 每个 tag 会在 Releases 页面附带针对主流 `torch × CUDA × Python` 组合的预编译 wheel。**在版本匹配的前提下,直接装 wheel 可以省掉 30 分钟的编译等待**,应作为首选方案。
先通过浏览器访问 [Releases 页面](https://github.com/Dao-AILab/flash-attention/releases) 确认对应版本 wheel 的文件名,再用镜像站下载:
```bash
wget https://ghfast.top/https://github.com/Dao-AILab/flash-attention/releases/download/v2.7.2.post1/flash_attn-2.7.2.post1+cu12torch2.3cxx11abiFALSE-cp310-cp310-linux_x86_64.whl
pip install flash_attn-2.7.2.post1+cu12torch2.3cxx11abiFALSE-cp310-cp310-linux_x86_64.whl
```
wheel 的文件名里会同时编码 `cuXX`(CUDA 版本)、`torchX.Y`(PyTorch 版本)、`cxx11abiTRUE/FALSE`、`cpXX`(Python 版本),**四项必须完全匹配当前环境**,否则仍需回退到源码编译。
### 后台编译,避免 SSH 断开中断
[Section titled “后台编译,避免 SSH 断开中断”](#后台编译避免-ssh-断开中断)
编译过程长达数十分钟,SSH 会话中断会导致前功尽弃。推荐 `nohup` 转后台并落盘日志:
```bash
cd /root/plugins/flash-attention
nohup pip install -e . --no-build-isolation \
> /root/plugins/flash-attention-build.log 2>&1 &
```
实时查看编译进度:
```bash
tail -f /root/plugins/flash-attention-build.log
```
更系统的后台托管方案参考 [守护进程(开后台)](https://www.gongjiyun.com/docs/cloud-hosting/best-practice/wyp7wfifcixzwfkhfkdc4mlxnrq/)。
### 把编译产物打包成自定义镜像
[Section titled “把编译产物打包成自定义镜像”](#把编译产物打包成自定义镜像)
编译一次耗时较长,**不要**让每个新启动的云主机或弹性部署实例都重新编译。推荐流程:
1. 在一台云主机中按上述步骤完成 flash-attention 编译安装
2. 通过控制台「保存为镜像」把当前实例打包成自定义镜像
3. 后续新建云主机、弹性部署服务直接选用该镜像,flash-attention 开箱即用
镜像保存参考 [如何使用基础镜像/通过基础镜像保存的镜像](https://www.gongjiyun.com/docs/cloud-hosting/function-usage-instructions/taaewpcy3ierj6km0okcmr40nuc/)。
### 编译产物放到共享存储卷
[Section titled “编译产物放到共享存储卷”](#编译产物放到共享存储卷)
若不打算打包镜像,也可以把编译好的 wheel 保存到共享存储卷,供其他实例直接 `pip install`:
```bash
cd /root/plugins/flash-attention
python setup.py bdist_wheel
cp dist/*.whl /mnt/shared/wheels/
```
其他实例挂载同一共享卷后:
```bash
pip install /mnt/shared/wheels/flash_attn-2.7.2.post1-*.whl
```
## 常见问题
[Section titled “常见问题”](#常见问题)
**Q:编译中途报错 ****Killed**** 或 ****out of memory****?**
A:并行编译占用内存超过实例配额被系统 OOM Killer 终止。调小 `MAX_JOBS`(从 4 改为 2 或 1)重试,或选用内存更大的云主机规格。
**Q:编译成功但 ****import flash\_attn**** 报 ****undefined symbol****?**
A:PyTorch ABI 不匹配。通常是 wheel 版本与当前 PyTorch 不对应,或源码编译时环境变量里残留了旧 PyTorch 路径。清理 `pip uninstall flash-attn` 后,重新确认 `torch.version`、`torch.version.cuda`、Python 版本三者一致再编。
**Q:****TORCH\_CUDA\_ARCH\_LIST**** 应该设什么?**
A:用 `python -c "import torch; print(torch.cuda.get_device_capability())"` 查当前 GPU 的 compute capability,例如 `(8, 9)` 对应 `TORCH_CUDA_ARCH_LIST="8.9"`。
**Q:****ghfast.top**** 克隆卡住不动?**
A:镜像节点负载波动,按 `Ctrl+C` 中断后重试即可。git 支持断点续传(shallow clone 除外)。必要时可切换到其他公益镜像或直连。
**Q:能否跳过镜像站直连 GitHub?**
A:可以,去掉 URL 前的 `https://ghfast.top/` 前缀即可。云主机外网若可直连 GitHub,直连速度往往更稳定。
***
## 注意事项
[Section titled “注意事项”](#注意事项)
* 镜像站为第三方公益服务,稳定性取决于节点状态,不适合作为生产 CI/CD 的强依赖
* **不要**把 `GITHUB_TOKEN` 硬编码到脚本、Dockerfile 或打包的自定义镜像中,始终通过环境变量注入
* 源码编译对 PyTorch、CUDA、Python 三者版本非常敏感,切换任一组件后通常需要重编
* 不支持 SSH 协议克隆(`git@github.com:...` 走镜像站无效),私有仓库必须用 HTTPS + Token
* 编译耗时较长,务必通过 `nohup`/`screen` 转后台,并把成果沉淀到自定义镜像或共享存储卷
* 不建议在长期脚本、CI/CD 配置中硬编码镜像地址,建议通过环境变量统一管理
* 仅用于学术研究与个人学习用途,请勿用于商业用途或任何违法用途
祝插件编译顺利~
# 如何在自己的镜像中配置 SSH
👋
ssh 修改配置时,必须关机之后才能进行修改
本指南详细阐述了在共绩算力平台上配置和使用 SSH 服务的完整技术方案。SSH(Secure Shell)是一种加密的网络传输协议,用于在不安全的网络中提供安全的远程登录、文件传输等服务。在容器化部署环境中,SSH 服务使得用户可以通过远程连接方式管理容器实例,进行代码调试、文件传输和系统维护等操作。通过本指南,用户可以了解在共绩算力平台上基础镜像与自定义镜像中 SSH 服务的区别,掌握通过命令行终端直接在运行中的容器内配置 SSH 服务的完整流程,并学习如何配置密码登录和免密登录两种认证方式。对于需要持久化配置的场景,也可以通过修改 Dockerfile 在镜像构建时预先配置 SSH 服务。
## **1. 基础镜像与自定义镜像的 SSH 配置差异**
[Section titled “1. 基础镜像与自定义镜像的 SSH 配置差异”](#1-基础镜像与自定义镜像的-ssh-配置差异)
在共绩算力平台上部署容器服务时,用户可以选择使用平台提供的预制镜像或上传自定义镜像。这两种方式在 SSH 服务的配置上存在显著差异,理解这些差异有助于用户根据实际需求选择合适的部署方式。
平台提供的预制镜像(如 PaddlePaddle、PyTorch、TensorFlow 等深度学习框架镜像)已经预先安装了 OpenSSH 服务器(sshd),并完成了基本的配置工作。这些基础镜像在构建时已经执行了 SSH 服务的安装步骤,包括创建必要的系统目录、配置 SSH 守护进程参数、以及暴露标准的 22 端口。用户在使用这些预制镜像部署服务后,可以直接通过共绩算力平台提供的 SSH 端口暴露功能进行远程连接,无需进行额外的配置工作。这种方式适合大多数用户,特别是那些希望快速开始开发工作而不想花时间配置底层服务的开发者。

然而,当用户使用自定义镜像部署服务时,情况则完全不同。自定义镜像通常为了保持最小化体积和安全性,默认不包含 SSH 服务器。对于这种情况,共绩算力平台提供了命令行终端功能,允许用户在已运行的容器实例中直接执行命令来安装和配置 SSH 服务,无需重新构建镜像。这种方式操作简单、灵活便捷,特别适合需要在已有容器中临时添加 SSH 支持,或者对已部署的服务进行 SSH 配置调整的场景。用户可以在容器运行后通过平台的命令行终端访问容器,执行安装 SSH 服务、配置认证方式、启动服务等操作,配置完成后即可使用平台的 SSH 端口暴露功能进行远程访问。如果用户希望 SSH 配置在容器重启后能够持久化保存,也可以通过在 Dockerfile 中添加相应的配置步骤来实现,详细说明请参考文档末尾的相关章节。
## **2. 通过命令行终端直接配置 SSH 服务**
[Section titled “2. 通过命令行终端直接配置 SSH 服务”](#2-通过命令行终端直接配置-ssh-服务)
共绩算力平台提供了命令行终端功能,允许用户在已运行的容器实例中直接执行命令来安装和配置 SSH 服务,这是最常用和最便捷的方式。通过平台提供的”命令行终端”功能,用户可以在浏览器中直接访问容器的命令行环境,无需预先配置 SSH 即可进行系统管理和配置操作。这种方式特别适合需要在已有容器中临时添加 SSH 支持,或者对已部署的服务进行 SSH 配置调整的场景。用户无需重新构建镜像,只需在容器运行后通过终端执行一系列命令即可完成 SSH 服务的配置,操作简单、灵活便捷。
### **2.1 访问命令行终端**
[Section titled “2.1 访问命令行终端”](#21-访问命令行终端)
在共绩算力平台的云主机详情页面,点击”命令行终端”标签页即可打开终端界面。终端界面提供了完整的命令行交互环境,支持常用的 Shell 命令和快捷键操作。在终端界面的”Command 配置”区域,可以选择默认的 Shell 环境,通常可以选择 `/bin/bash` 或 `/bin/sh`,选择 `/bin/bash` 可以获得更丰富的命令补全和交互体验。终端连接成功后,界面右上角会显示”已连接”状态,表示已经成功连接到容器实例。用户可以在终端中输入命令并查看执行结果,就像在本地终端中操作一样。

### **2.2 在运行中的容器内安装 SSH 服务**
[Section titled “2.2 在运行中的容器内安装 SSH 服务”](#22-在运行中的容器内安装-ssh-服务)
如果容器镜像中没有预装 SSH 服务,可以通过命令行终端直接安装。首先需要确认当前容器的操作系统类型,可以通过 `cat /etc/os-release` 命令查看系统信息。对于基于 Debian 或 Ubuntu 的系统,使用 apt-get 包管理器安装 openssh-server。执行 `apt-get update` 命令更新软件包列表,然后执行 `apt-get install -y openssh-server` 安装 SSH 服务器。安装过程中系统会自动创建必要的配置文件和目录结构,包括 `/etc/ssh/sshd_config` 配置文件和 `/var/run/sshd` 运行目录。
```bash
apt-get update
apt-get install -y openssh-server
```
安装完成后,需要创建 SSH 守护进程运行所需的目录。sshd 在运行时需要权限分离目录来存储临时文件和套接字,如果这些目录不存在,SSH 服务将无法正常启动。在某些容器环境中,系统可能不会自动创建这些目录,需要手动创建。通常情况下需要创建 `/run/sshd` 目录,有些系统也使用 `/var/run/sshd`(`/run` 通常是 `/var/run` 的符号链接,但在某些容器环境中可能不存在)。为了确保兼容性,建议同时创建这两个目录。
```bash
mkdir -p /run/sshd
mkdir -p /var/run/sshd
```
如果遇到 “Missing privilege separation directory: /run/sshd” 错误,说明 `/run/sshd` 目录不存在,执行上述命令创建目录后即可解决问题。
### **2.3 通过命令行配置密码登录**
[Section titled “2.3 通过命令行配置密码登录”](#23-通过命令行配置密码登录)
安装 SSH 服务后,需要通过命令行配置用户认证方式。配置密码登录时,首先使用 `chpasswd` 命令设置 root 用户或其他用户的密码。`chpasswd` 命令从标准输入读取”用户名:密码”格式的数据,可以通过 echo 命令将密码传递给 chpasswd。例如,执行 `echo 'root:yourpassword' | chpasswd` 即可将 root 用户的密码设置为 yourpassword。需要注意的是,在命令行中输入密码时,密码会显示在终端中,建议在设置完成后及时清除终端历史记录,避免密码泄露。
```bash
echo 'root:yourpassword' | chpasswd
```

设置密码后,需要修改 SSH 配置文件以允许密码认证和 root 用户登录。使用 `sed` 命令编辑 `/etc/ssh/sshd_config` 文件,将 `PermitRootLogin` 选项设置为 `yes`,将 `PasswordAuthentication` 选项设置为 `yes`。如果配置文件中这些选项被注释掉了(以 # 开头),sed 命令会自动取消注释并修改值。修改完成后,可以使用 `grep` 命令验证配置是否正确,例如执行 `grep -E "PermitRootLogin|PasswordAuthentication" /etc/ssh/sshd_config` 查看相关配置项。
```bash
sed -i 's/#PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config
sed -i 's/PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config
sed -i 's/#PasswordAuthentication no/PasswordAuthentication yes/' /etc/ssh/sshd_config
sed -i 's/#PasswordAuthentication yes/PasswordAuthentication yes/' /etc/ssh/sshd_config
```
### **2.4 通过命令行配置免密登录**
[Section titled “2.4 通过命令行配置免密登录”](#24-通过命令行配置免密登录)
配置免密登录需要创建 `.ssh` 目录和 `authorized_keys` 文件,并将用户的公钥添加到文件中。首先在用户主目录下创建 `.ssh` 目录,通常 root 用户的主目录是 `/root`,其他用户的主目录在 `/home/用户名`。使用 `mkdir -p` 命令创建目录,`-p` 参数表示如果目录已存在则不报错。然后设置目录权限为 700,确保只有所有者可以访问。接下来创建 `authorized_keys` 文件,可以使用 `echo` 命令将公钥内容追加到文件中,或者使用文本编辑器直接编辑文件。设置文件权限为 600,确保只有所有者可以读写。如果公钥内容较长,可以通过复制粘贴的方式添加到文件中,或者使用 `cat` 命令配合输入重定向。
```bash
mkdir -p /root/.ssh
chmod 700 /root/.ssh
echo "ssh-rsa AAAAB3NzaC1yc2EAAAADAQABAAABAQC..." >> /root/.ssh/authorized_keys
chmod 600 /root/.ssh/authorized_keys
```
如果需要添加多个公钥,可以将每个公钥分别追加到 `authorized_keys` 文件中,每个公钥占一行。也可以从本地文件复制公钥内容,先使用文本编辑器在本地创建包含公钥内容的临时文件,然后通过平台的文件上传功能或复制粘贴的方式将内容添加到容器中的 `authorized_keys` 文件。
### **2.5 启动 SSH 服务**
[Section titled “2.5 启动 SSH 服务”](#25-启动-ssh-服务)
配置完成后,需要启动 SSH 服务。在容器环境中,不能使用 systemctl 等系统服务管理工具,需要直接运行 sshd 守护进程。执行 `/usr/sbin/sshd -D` 命令启动 SSH 服务,`-D` 参数表示以前台模式运行,这样可以在终端中实时查看服务的运行状态和日志信息。
```bash
/usr/sbin/sshd -D
```

如果启动时没有显示任何信息,或者希望看到更详细的调试信息,可以使用调试模式启动 SSH 服务。调试模式会输出详细的启动过程和运行日志,有助于诊断问题:
```bash
/usr/sbin/sshd -D -d
```
`-d` 参数表示以调试模式运行,会在终端中显示详细的调试信息。如果需要更详细的调试信息,可以使用 `-dd`(更详细)或 `-ddd`(最详细)参数。调试模式启动后,终端会一直显示日志信息,直到服务被终止。
需要注意的是,如果在命令行终端中以前台模式启动 sshd,终端会被 sshd 进程占用,无法继续输入其他命令。如果需要在启动 SSH 服务后继续使用终端执行其他操作,可以在后台运行 sshd,使用 `nohup /usr/sbin/sshd -D &` 命令将服务放到后台运行,或者使用 `screen` 或 `tmux` 等终端复用工具创建一个新的会话。另外,如果容器的主进程不是 sshd,需要确保在容器启动脚本或配置中正确启动 SSH 服务,这样才能在容器重启后自动启动 SSH 服务。
### **2.6 后台启动方式**
[Section titled “2.6 后台启动方式”](#26-后台启动方式)
如果需要在启动 SSH 服务后继续使用终端执行其他命令,可以使用后台启动方式:
```bash
nohup /usr/sbin/sshd -D > /tmp/sshd.log 2>&1 &
```
启动后会显示进程 ID(PID),可以通过查看日志文件 `/tmp/sshd.log` 来确认服务是否正常启动。也可以直接使用 `nohup /usr/sbin/sshd -D &` 命令,输出会重定向到 `nohup.out` 文件中。

启动完成后,建议立即验证服务状态,确认 SSH 服务正常运行。可以通过检查进程、端口监听状态等方式来验证,详细步骤请参考下一节的”验证 SSH 配置”。
### **2.7 验证 SSH 配置**
[Section titled “2.7 验证 SSH 配置”](#27-验证-ssh-配置)
配置完成后,应该验证 SSH 服务是否正常工作。首先检查 sshd 进程是否正在运行,执行 `ps aux | grep sshd` 命令查看进程列表,应该能看到 sshd 主进程和可能的子进程。检查 SSH 服务是否在正确的端口上监听,执行 `netstat -tlnp | grep 22` 或 `ss -tlnp | grep 22` 命令,应该能看到 22 端口处于监听状态。检查 SSH 配置文件语法是否正确,执行 `sshd -t` 命令进行配置测试,如果配置文件有语法错误会显示错误信息,如果配置正确则不会有任何输出。
```bash
ps aux | grep sshd
netstat -tlnp | grep 22
ss -tlnp | grep 22
sshd -t
```
如果配置了密码登录,可以尝试在另一个终端会话中使用密码登录进行测试。如果配置了免密登录,可以尝试使用对应的私钥进行连接测试。需要注意的是,通过命令行终端配置的 SSH 服务在容器重启后可能会丢失,因为这些配置是在容器运行时修改的,没有写入镜像。如果需要持久化配置,可以将配置步骤添加到 Dockerfile 中重新构建镜像,详细说明请参考文档末尾的”在自定义镜像中安装和配置 SSH 服务”章节。

## **3. ****在共绩算力平台上使用 SSH 端口暴露**
[Section titled “3. 在共绩算力平台上使用 SSH 端口暴露”](#3-在共绩算力平台上使用-ssh-端口暴露)
完成 SSH 服务配置后,即可在共绩算力平台上使用 SSH 端口暴露功能进行远程访问。共绩算力平台提供了便捷的端口暴露功能,可以将容器内的 SSH 端口(22)映射到平台提供的公网地址,用户无需手动配置网络和防火墙规则即可实现远程访问。无论是通过 Dockerfile 预先配置的 SSH 服务,还是通过命令行终端临时配置的 SSH 服务,都可以使用相同的端口暴露功能进行访问。

### **3.1 配置 SSH 端口暴露**
[Section titled “3.1 配置 SSH 端口暴露”](#31-配置-ssh-端口暴露)
在共绩算力平台的部署服务详情页面,找到”端口暴露”或”网络配置”选项,添加端口映射规则。将容器内的 22 端口映射到平台的公网地址,平台会自动分配一个外部端口或域名。配置完成后,平台会显示完整的 SSH 连接信息,包括主机地址、端口号以及连接命令示例。用户可以使用这些信息通过本地 SSH 客户端连接到容器实例。

### **3.2 连接容器实例**
[Section titled “3.2 连接容器实例”](#32-连接容器实例)
使用 SSH 客户端连接到容器时,如果配置了密码登录,直接使用 ssh 命令连接并输入设置的密码即可。如果配置了免密登录,需要确保本地有对应的私钥文件,SSH 客户端会自动使用私钥进行认证。连接成功后,用户就可以像操作普通 Linux 系统一样,执行各种命令、编辑文件、安装软件、查看日志等操作。
```bash
ssh root@your-host-address -p your-port
ssh root@your-host-address -p your-port
```

## **4. 安全最佳实践**
[Section titled “4. 安全最佳实践”](#4-安全最佳实践)
在配置和使用 SSH 服务时,安全性是至关重要的考虑因素。以下提供一些安全最佳实践建议,帮助用户构建更安全的容器环境。
**密码安全方面**,如果使用密码登录方式,应该设置强密码,包含大小写字母、数字和特殊字符,长度至少 12 位。避免使用容易被猜到的密码,如”123456”、“password”等常见密码。定期更换密码,特别是在发现可能存在安全风险的情况下。对于生产环境,强烈建议禁用密码登录,仅使用公钥认证方式,这样可以有效防止暴力破解攻击。
**公钥管理方面**,使用免密登录时,应该妥善保管私钥文件,不要将私钥提交到代码仓库或分享给他人。私钥文件应该设置正确的权限(通常为 600),只有所有者可以读取。定期轮换密钥对,及时撤销不再使用的公钥。对于团队协作场景,可以为每个团队成员单独配置公钥,这样可以精确控制访问权限,当成员离开团队时只需删除对应的公钥即可。
**SSH 配置优化方面**,可以修改 /etc/ssh/sshd\_config 文件,禁用不必要的功能以提高安全性。例如,可以设置 MaxAuthTries 选项限制认证尝试次数,防止暴力破解。可以设置 ClientAliveInterval 和 ClientAliveCountMax 选项来管理空闲连接,自动断开长时间不活动的会话。可以禁用 X11 转发、端口转发等不需要的功能,减少潜在的攻击面。可以配置日志记录,将 SSH 连接日志保存到安全的位置,便于后续审计和问题排查。
**网络安全方面**,虽然共绩算力平台提供了公网访问能力,但在可能的情况下,应该优先使用 VPN 或内网连接,减少暴露在公网的风险。如果必须使用公网访问,应该定期检查连接日志,发现异常连接及时处理。可以配置防火墙规则,限制只允许特定 IP 地址访问 SSH 端口,进一步提高安全性。
## **5. 常见问题与解决方案**
[Section titled “5. 常见问题与解决方案”](#5-常见问题与解决方案)
在使用 SSH 服务的过程中,可能会遇到一些问题,以下提供常见问题的解决方案,帮助用户快速定位和解决问题。
**无法连接 SSH 服务时,**首先检查容器是否正常运行,可以通过共绩算力平台的控制台查看容器状态和日志。如果容器没有运行,检查 Dockerfile 中的启动命令是否正确,确保 sshd 命令使用了 -D 参数以前台模式运行。检查 SSH 服务是否正常启动,可以在容器内部执行 ps aux | grep sshd 命令查看进程是否存在,或者检查 /var/log/auth.log 日志文件查看错误信息。检查端口映射配置是否正确,确认平台上的端口暴露配置将容器的 22 端口正确映射到了外部。
**认证失败问题时,**如果使用密码登录,确认密码是否正确,注意密码中的大小写和特殊字符。检查 SSH 配置文件中 PermitRootLogin 和 PasswordAuthentication 选项是否正确设置。如果使用免密登录,检查公钥是否正确添加到 authorized\_keys 文件中,可以使用 cat /root/.ssh/authorized\_keys 命令查看文件内容。检查文件权限是否正确,authorized\_keys 文件的权限应该是 600,.ssh 目录的权限应该是 700。如果权限不正确,使用 chmod 命令修正权限后重新尝试连接。
**权限问题方面,**SSH 对文件权限有严格要求,如果权限设置不正确,即使配置看起来正确,认证也会失败。确保 .ssh 目录的权限为 700,authorized\_keys 文件的权限为 600。不要在用户主目录或 .ssh 目录上设置过于宽松的权限,这可能导致 SSH 拒绝连接。如果是在构建镜像时设置权限,确保 Dockerfile 中的 chmod 命令正确执行,没有被后续的操作覆盖。
**连接超时或断开问题时,**检查网络连接是否稳定,可以通过 ping 命令测试网络连通性。检查 SSH 配置中的超时设置,可以适当调整 ClientAliveInterval 和 ClientAliveCountMax 选项的值。检查防火墙规则,确保没有阻止 SSH 连接。如果是在共绩算力平台上,检查端口暴露配置是否正确,确认外部可以访问映射的端口。
**性能问题方面,**如果 SSH 连接速度较慢,可以尝试使用更快的加密算法,在 SSH 配置中设置 Ciphers 和 MACs 选项。检查容器资源限制,确保有足够的 CPU 和内存资源。如果连接延迟较高,考虑使用更近的地理位置的服务器节点。对于频繁的文件传输操作,考虑使用 SCP 或 SFTP 协议,这些协议针对文件传输进行了优化。
## **6. 在自定义镜像中安装和配置 SSH 服务(通过 Dockerfile)**
[Section titled “6. 在自定义镜像中安装和配置 SSH 服务(通过 Dockerfile)”](#6-在自定义镜像中安装和配置-ssh-服务通过-dockerfile)
对于需要持久化 SSH 配置的场景,用户可以通过修改 Dockerfile 在镜像构建时预先安装和配置 SSH 服务。这种方式适合需要将 SSH 服务作为容器标准配置的场景,或者需要在多个容器实例中复用相同配置的场景。通过在 Dockerfile 中添加相应的配置步骤,可以在镜像构建时就将 SSH 服务配置完成,容器启动后即可使用,无需每次都在运行时手动配置。需要注意的是,通过这种方式配置的 SSH 服务会在镜像中持久化保存,容器重启后配置不会丢失。
### **6.1 安装 OpenSSH 服务器**
[Section titled “6.1 安装 OpenSSH 服务器”](#61-安装-openssh-服务器)
首先需要在 Dockerfile 中添加安装 OpenSSH 服务器的步骤。OpenSSH 是 SSH 协议的开源实现,包含了 sshd 守护进程和相关的工具。使用 apt-get 包管理器安装 openssh-server 软件包,安装过程中系统会自动创建必要的配置文件和目录结构。为了确保安装过程顺利,建议先执行 apt-get update 命令更新软件包列表,这样可以获取最新的软件包信息和依赖关系。安装命令需要使用 -y 参数以非交互方式执行,避免构建过程中因为需要用户确认而中断。
```docker
FROM ubuntu:latest
RUN apt-get update && \
apt-get install -y openssh-server && \
rm -rf /var/lib/apt/lists/*
```
安装完成后,需要创建 SSH 守护进程运行所需的目录。sshd 在运行时需要在 /var/run/sshd 目录中创建一些临时文件,用于存储进程 ID 和套接字等信息。如果这个目录不存在,sshd 服务将无法正常启动。因此需要在 Dockerfile 中使用 mkdir 命令创建该目录,并确保目录具有正确的权限。
```docker
RUN mkdir -p /var/run/sshd
```
### **6.2 配置用户认证方式**
[Section titled “6.2 配置用户认证方式”](#62-配置用户认证方式)
SSH 服务支持多种用户认证方式,包括密码认证和公钥认证(免密登录)。用户可以根据安全需求和便利性选择合适的认证方式,或者同时配置两种方式以提供更多灵活性。
#### **6.2.1 配置密码登录**
[Section titled “6.2.1 配置密码登录”](#621-配置密码登录)
配置密码登录是最简单直接的方式,适合快速测试和开发环境使用。首先需要为用户设置密码,可以使用 echo 命令结合 chpasswd 工具来设置密码。chpasswd 是一个用于批量修改用户密码的命令行工具,它从标准输入读取用户名和密码对,格式为”用户名:密码”。需要注意的是,密码应该以明文形式传递给 chpasswd,因此在使用时要注意安全性,避免将包含密码的 Dockerfile 提交到公开的代码仓库中。生产环境建议使用环境变量或密钥管理服务来传递敏感信息。
```docker
RUN echo 'root:yourpassword' | chpasswd
```
设置密码后,需要修改 SSH 配置文件 /etc/ssh/sshd\_config,以允许密码认证和 root 用户登录。默认情况下,SSH 配置可能禁止 root 用户直接登录,或者禁用密码认证方式。需要使用 sed 命令修改配置文件,将相关选项的值改为允许。PermitRootLogin 选项控制是否允许 root 用户通过 SSH 登录,将其设置为 yes 即可允许。PasswordAuthentication 选项控制是否允许使用密码进行认证,也需要设置为 yes。
```docker
RUN sed -i 's/#PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config && \
sed -i 's/#PasswordAuthentication yes/PasswordAuthentication yes/' /etc/ssh/sshd_config
```
#### **6.2.2 配置免密登录**
[Section titled “6.2.2 配置免密登录”](#622-配置免密登录)
免密登录(公钥认证)是更安全和便捷的认证方式,特别适合生产环境和频繁访问的场景。配置免密登录需要将用户的公钥添加到容器的授权密钥文件中。每个用户的公钥存储在对应的 \~/.ssh/authorized\_keys 文件中,当用户尝试连接时,SSH 服务器会验证客户端提供的私钥是否与存储的公钥匹配,匹配成功则允许登录,无需输入密码。
首先需要在 Dockerfile 中创建 .ssh 目录和 authorized\_keys 文件,并设置正确的权限。SSH 对文件权限有严格要求,如果权限设置不正确,即使配置了公钥,认证也会失败。通常 authorized\_keys 文件的权限应该设置为 600(仅所有者可读写),.ssh 目录的权限应该设置为 700(仅所有者可访问)。然后将用户的公钥内容添加到 authorized\_keys 文件中,公钥内容可以通过环境变量、构建参数或挂载卷的方式传入。
```docker
RUN mkdir -p /root/.ssh && \
chmod 700 /root/.ssh && \
echo "ssh-rsa AAAAB3NzaC1yc2EAAAADAQABAAABAQC..." > /root/.ssh/authorized_keys && \
chmod 600 /root/.ssh/authorized_keys
```
如果需要支持多用户访问,可以为每个用户分别创建对应的 .ssh 目录和 authorized\_keys 文件。也可以配置 SSH 服务器使用统一的授权密钥文件,在 /etc/ssh/sshd\_config 中设置 AuthorizedKeysFile 选项来指定密钥文件的路径。
### **6.3 暴露 SSH 端口**
[Section titled “6.3 暴露 SSH 端口”](#63-暴露-ssh-端口)
SSH 服务默认使用 22 端口进行通信,需要在 Dockerfile 中使用 EXPOSE 指令声明该端口。EXPOSE 指令不会实际开放端口,只是作为文档说明,告诉使用该镜像的用户容器会监听哪些端口。实际的端口映射需要在运行容器时通过 -p 参数或共绩算力平台的端口配置来完成。
```docker
EXPOSE 22
```
### **6.4 启动 SSH 服务**
[Section titled “6.4 启动 SSH 服务”](#64-启动-ssh-服务)
容器启动时需要运行 SSH 守护进程,可以使用 CMD 或 ENTRYPOINT 指令来设置启动命令。sshd 命令的 -D 参数表示以前台模式运行守护进程,这样容器会持续运行而不会立即退出。如果不使用 -D 参数,sshd 会在后台运行并立即返回,导致容器退出。也可以使用 systemd 或其他服务管理工具来管理 SSH 服务,但在容器环境中,直接运行守护进程是最简单的方式。
```docker
CMD ["/usr/sbin/sshd", "-D"]
```
### **6.5 完整的 Dockerfile 示例**
[Section titled “6.5 完整的 Dockerfile 示例”](#65-完整的-dockerfile-示例)
以下提供完整的 Dockerfile 示例,分别展示配置密码登录、免密登录以及混合配置的完整流程。用户可以根据实际需求选择合适的配置方式。
#### **6.5.1 密码登录配置示例**
[Section titled “6.5.1 密码登录配置示例”](#651-密码登录配置示例)
此示例展示如何配置基于密码的 SSH 登录方式,适合快速测试和开发环境使用。
```docker
FROM ubuntu:latest
RUN apt-get update && \
apt-get install -y openssh-server && \
rm -rf /var/lib/apt/lists/*
RUN mkdir -p /var/run/sshd
RUN echo 'root:yourpassword' | chpasswd
RUN sed -i 's/#PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config && \
sed -i 's/#PasswordAuthentication yes/PasswordAuthentication yes/' /etc/ssh/sshd_config
EXPOSE 22
CMD ["/usr/sbin/sshd", "-D"]
```
#### **6.5.2 免密登录配置示例**
[Section titled “6.5.2 免密登录配置示例”](#652-免密登录配置示例)
此示例展示如何配置基于公钥的免密登录方式,适合生产环境和频繁访问的场景。公钥内容通过构建参数传入,提高了安全性和灵活性。
```docker
FROM ubuntu:latest
RUN apt-get update && \
apt-get install -y openssh-server && \
rm -rf /var/lib/apt/lists/*
RUN mkdir -p /var/run/sshd
ARG SSH_PUBLIC_KEY
RUN mkdir -p /root/.ssh && \
chmod 700 /root/.ssh && \
echo "${SSH_PUBLIC_KEY}" > /root/.ssh/authorized_keys && \
chmod 600 /root/.ssh/authorized_keys
RUN sed -i 's/#PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config && \
sed -i 's/#PasswordAuthentication yes/PasswordAuthentication yes/' /etc/ssh/sshd_config
EXPOSE 22
CMD ["/usr/sbin/sshd", "-D"]
```
构建此镜像时,需要传入 SSH\_PUBLIC\_KEY 构建参数,例如:
```bash
docker build --build-arg SSH_PUBLIC_KEY="$(cat ~/.ssh/id_rsa.pub)" -t my_ssh_image .
```
#### **6.5.3 混合配置示例**
[Section titled “6.5.3 混合配置示例”](#653-混合配置示例)
此示例同时配置密码登录和免密登录两种方式,提供最大的灵活性。用户可以优先使用免密登录,在密钥不可用时还可以使用密码登录作为备选方案。
```docker
FROM ubuntu:latest
RUN apt-get update && \
apt-get install -y openssh-server && \
rm -rf /var/lib/apt/lists/*
RUN mkdir -p /var/run/sshd
RUN echo 'root:yourpassword' | chpasswd
ARG SSH_PUBLIC_KEY
RUN if [ -n "$SSH_PUBLIC_KEY" ]; then \
mkdir -p /root/.ssh && \
chmod 700 /root/.ssh && \
echo "$SSH_PUBLIC_KEY" > /root/.ssh/authorized_keys && \
chmod 600 /root/.ssh/authorized_keys; \
fi
RUN sed -i 's/#PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config && \
sed -i 's/#PasswordAuthentication yes/PasswordAuthentication yes/' /etc/ssh/sshd_config
EXPOSE 22
CMD ["/usr/sbin/sshd", "-D"]
```
# 守护进程(开后台)
👋
【数据安全必读】
系统盘与数据盘均为本地 SSD,无冗余,单点故障可能导致数据永久丢失。
请务必将重要数据实时备份至「共享存储卷」或本地,共绩算力对本地盘损坏及数据丢失不承担任何责任。
立即开通共享存储卷,获得企业级冗余 + 跨区域同步,彻底告别数据丢失:\
如果你通过 SSH 远程连接(或使用基于 SSH 的工具,如 XShell、PyCharm、VSCode 等)来运行程序,请注意在正式长时间运行时应以守护进程方式启动任务,以避免因网络波动或 SSH 断开导致程序意外终止,造成不必要的损失。
有多种方式可以实现程序在后台持久运行,例如使用 `screen` 或 `tmux`(如需安装可执行:`apt-get update && apt-get install -y tmux`),以下我们主要介绍两种常用方法。
***
### 一、使用 JupyterLab 终端执行程序
[Section titled “一、使用 JupyterLab 终端执行程序”](#一使用-jupyterlab-终端执行程序)
如果你在使用 JupyterLab,其内置终端会话具备较强的稳定性,即使本地网络中断或关闭电脑,只要 JupyterLab 服务未重启(通常情况下很少发生),其中运行的命令仍会持续执行。

* 如果你关闭了终端标签页,仍可以在左侧文件导航栏的“Running Terminals”部分找回原有会话。

* 重新打开终端后若未见输出,按**回车键即可激活**显示。
**建议在使用 JupyterLab 长时间运行任务时,将程序日志重定向到文件中**,防止因暂时断开连接而导致中间日志丢失。具体操作如下:
```bash
python xxx.py > train.log 2>&1
tail -f train.log
```
***
### 二、使用 screen 工具管理会话
[Section titled “二、使用 screen 工具管理会话”](#二使用-screen-工具管理会话)
`screen` 是一款经典的终端复用工具,可以创建虚拟会话,即使在 SSH 断开后仍保持其中任务运行。
#### 安装 screen:
[Section titled “安装 screen:”](#安装-screen)
```bash
apt-get update && apt-get install -y screen
```
#### 创建新会话:
[Section titled “创建新会话:”](#创建新会话)
直接输入 `screen` 命令,按回车后会出现一个新终端界面,此时在该终端中执行的命令将受 screen 会话保护。
注意:初次使用 screen 时,新终端界面可能只显示一个简单的 `#` 或 `$` 提示符,并且输入常用命令(如 `ping`、`python` 等)会提示 `command not found`。这是因为默认启动的 Shell 环境配置不完整。
解决方法:此时只需手动输入 `bash` 并回车,即可启动一个功能完整的 Bash Shell。这个新 Shell 仍然完全处于 screen 会话的保护之下,您可以在此正常执行所有命令。为了后续使用方便,建议在 `~/.screenrc` 配置文件中添加 `shell -/bin/bash` 来让 screen 默认直接启动 Bash。”

如果遇到中文字符显示乱码,可执行以下命令配置编码,并重新进入 screen:
```bash
echo "defencoding GBK" >> ~/.screenrc
echo "encoding UTF-8 GBK" >> ~/.screenrc
```
#### 临时离开当前会话:
[Section titled “临时离开当前会话:”](#临时离开当前会话)
在 screen 终端中按下组合键 `Ctrl + a + d`,即可“脱离”当前会话并返回原终端,屏幕会提示“detached”,表示该会话仍在后台运行。

#### 重新接入原有会话:
[Section titled “重新接入原有会话:”](#重新接入原有会话)
如需查看之前放在 screen 中运行的程序,可先查看现有会话列表:
```bash
screen -ls
```

然后使用如下命令恢复至指定会话:
```bash
screen -r <会话ID或名称>
```

你将回到原终端环境,并看到程序仍在持续执行。

#### 退出并关闭 screen 会话:
[Section titled “退出并关闭 screen 会话:”](#退出并关闭-screen-会话)
在 screen 终端内键入 `Ctrl + d` 即可结束当前会话。如仍有程序运行,请先使用 `Ctrl + c` 中断任务。
如果遇到中文显示问题,可在所有 screen 命令中加入 `-U` 参数以启用 UTF-8 编码支持,例如:
```bash
screen -U # 新建支持 Unicode 的会话
screen -U -r xxx # 恢复某一会话
```
***
通过以上方式,你可以更安全地在远程服务器上运行长时间任务,无需担心连接稳定性带来的中断问题。
# 如何在云主机上快速开始机器学习训练
👋
【数据安全必读】
系统盘与数据盘均为本地 SSD,无冗余,单点故障可能导致数据永久丢失。
请务必将重要数据实时备份至「共享存储卷」或本地,共绩算力对本地盘损坏及数据丢失不承担任何责任。
立即开通共享存储卷,获得企业级冗余 + 跨区域同步,彻底告别数据丢失:\
**
## 1 用基础镜像创建云主机
[Section titled “1 用基础镜像创建云主机”](#1-用基础镜像创建云主机)
### 1.1 第一步:创建云主机
[Section titled “1.1 第一步:创建云主机”](#11--第一步创建云主机)
点击顶部的【云主机】按钮,进入云主机界面:
挑选合适的设备,本例中点击【142 台设备可租】按钮

GPU 型号推荐配置:
1 卡:每小时仅需 1.68 元,按秒计费(0.000446 元/秒),适合短期测试或常规任务。
多卡选项备用:若未来需要多卡训练或高并发任务,可随时通过关机切换 2 卡/4 卡配置。
### 1.2 第二步:配置资源
[Section titled “1.2 第二步:配置资源”](#12-第二步配置资源)
#### 1.2.1 设置实例名称
[Section titled “1.2.1 设置实例名称”](#121-设置实例名称)
为创建的开发机设置一个容易记住的名字,也可以采用系统自动生成的实例名称。
#### 1.2.2 选择基础镜像
[Section titled “1.2.2 选择基础镜像”](#122-选择基础镜像)
按照需求选择我们预制好的镜像,同时可以通过文档链接快速了解容器化部署对应服务的步骤。
这里我们选择了 在 Ubuntu22.04 上运行的 PyTorch 的 2.7.1 版本,Python 为 3.12,CUDA 版本 12.8 的镜像作为示例。
* 平台默认提供了一批基础镜像供试用,可以根据实际需要选择合适的镜像

#### 1.2.3 开通共享存储卷服务,挂载到本机目录(实现多机训练数据共享)
[Section titled “1.2.3 开通共享存储卷服务,挂载到本机目录(实现多机训练数据共享)”](#123-开通共享存储卷服务挂载到本机目录实现多机训练数据共享)

> **注意:**
>
> * **挂载存储的时候,不要直接挂载到/、/root、 ****/root/目录,否则会出现一些奇怪的问题。建议挂载在类似/root/data ****、/root/code 之类的二级目录。**
同意服务协议,点击【创建实例】按钮,完成云主机的 创建过程。
### 1.3 第三步:查看运行状态开始使用程序
[Section titled “1.3 第三步:查看运行状态开始使用程序”](#13-第三步查看运行状态开始使用程序)

## 2.在云主机上快速开始训练
[Section titled “2.在云主机上快速开始训练”](#2在云主机上快速开始训练)
示例程序:
```py
"""
一个端到端演示:用 PyTorch 训练 MLP 二分类器
并在训练过程中实时可视化损失曲线与决策边界。
"""
import math
import time
import random
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
from torch.utils.data import TensorDataset, DataLoader
def set_seed(seed=42):
random.seed(seed)
np.random.seed(seed)
torch.manual_seed(seed)
torch.cuda.manual_seed_all(seed)
set_seed(42)
def make_moons(n_samples=1000, noise=0.2):
"""手工实现 make_moons,不依赖 sklearn"""
n_samples_out = n_samples // 2
n_samples_in = n_samples - n_samples_out
outer_circ_x = np.cos(np.linspace(0, math.pi, n_samples_out))
outer_circ_y = np.sin(np.linspace(0, math.pi, n_samples_out))
inner_circ_x = 1 - np.cos(np.linspace(0, math.pi, n_samples_in))
inner_circ_y = 1 - np.sin(np.linspace(0, math.pi, n_samples_in)) - .5
X = np.vstack([np.append(outer_circ_x, inner_circ_x),
np.append(outer_circ_y, inner_circ_y)]).T.astype(np.float32)
y = np.hstack([np.zeros(n_samples_out, dtype=np.float32),
np.ones(n_samples_in, dtype=np.float32)])
if noise > 0:
X += np.random.normal(0, noise, X.shape)
return X, y
X, y = make_moons(1200, noise=0.25)
perm = np.random.permutation(len(X))
train_size = int(0.8 * len(X))
X_train, y_train = X[perm[:train_size]], y[perm[:train_size]]
X_val, y_val = X[perm[train_size:]], y[perm[train_size:]]
train_ds = TensorDataset(torch.from_numpy(X_train), torch.from_numpy(y_train))
val_ds = TensorDataset(torch.from_numpy(X_val), torch.from_numpy(y_val))
train_loader = DataLoader(train_ds, batch_size=64, shuffle=True)
val_loader = DataLoader(val_ds, batch_size=256)
class MLP(nn.Module):
def __init__(self, in_dim=2, hidden=64):
super().__init__()
self.net = nn.Sequential(
nn.Linear(in_dim, hidden),
nn.ReLU(),
nn.Linear(hidden, hidden),
nn.ReLU(),
nn.Linear(hidden, 1)
)
def forward(self, x):
return self.net(x).squeeze(1)
device = 'cuda' if torch.cuda.is_available() else 'cpu'
model = MLP().to(device)
criterion = nn.BCEWithLogitsLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-2)
EPOCHS = 200
PLOT_FREQ = 10 # 每 10 个 epoch 画一次图
plt.ion() # 交互模式
fig = plt.figure(figsize=(12, 5))
ax_loss = fig.add_subplot(1, 2, 1)
ax_boundary = fig.add_subplot(1, 2, 2)
train_losses, val_losses = [], []
def plot_boundary(ax):
ax.clear()
# 背景网格
h = 0.02
x_min, x_max = X[:, 0].min() - .5, X[:, 0].max() + .5
y_min, y_max = X[:, 1].min() - .5, X[:, 1].max() + .5
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
grid = torch.from_numpy(np.c_[xx.ravel(), yy.ravel()]).float().to(device)
with torch.no_grad():
Z = torch.sigmoid(model(grid)).cpu().numpy().reshape(xx.shape)
ax.contourf(xx, yy, Z, levels=50, cmap='RdBu', alpha=0.7)
ax.scatter(X_train[:, 0], X_train[:, 1], c=y_train, cmap='bwr', edgecolors='k')
ax.set_title('Decision boundary')
def plot_loss(ax):
ax.clear()
ax.plot(train_losses, label='Train')
ax.plot(val_losses, label='Val')
ax.set_title('Loss curve')
ax.legend()
for epoch in range(1, EPOCHS + 1):
# ---------- 训练 ----------
model.train()
epoch_loss = 0.
for xb, yb in train_loader:
xb, yb = xb.to(device), yb.to(device)
optimizer.zero_grad()
logits = model(xb)
loss = criterion(logits, yb)
loss.backward()
optimizer.step()
epoch_loss += loss.item() * xb.size(0)
train_loss = epoch_loss / len(train_loader.dataset)
train_losses.append(train_loss)
# ---------- 验证 ----------
model.eval()
epoch_loss = 0.
with torch.no_grad():
for xb, yb in val_loader:
xb, yb = xb.to(device), yb.to(device)
logits = model(xb)
loss = criterion(logits, yb)
epoch_loss += loss.item() * xb.size(0)
val_loss = epoch_loss / len(val_loader.dataset)
val_losses.append(val_loss)
print(f'Epoch {epoch:03d}/{EPOCHS} | train loss {train_loss:.4f} | val loss {val_loss:.4f}')
# ---------- 可视化 ----------
if epoch % PLOT_FREQ == 0 or epoch == EPOCHS:
plot_loss(ax_loss)
plot_boundary(ax_boundary)
plt.pause(0.01)
plt.ioff()
plt.show()
model.eval()
with torch.no_grad():
X_tensor = torch.from_numpy(X).to(device)
y_pred = (torch.sigmoid(model(X_tensor)) > 0.5).cpu().numpy().astype(int)
accuracy = (y_pred == y).mean()
print(f'Final accuracy on full data: {accuracy:.3f}')
```
 
## 3.最后
[Section titled “3.最后”](#3最后)
更多的实践和功能可以参考我们的云主机文档\~
# 常见问题
# 云主机常见问题
## 平台使用
[Section titled “平台使用”](#平台使用)
### 如何计费
[Section titled “如何计费”](#如何计费)
按量(使用时长)计费,精确到秒。镜像上传拉取过程不收费,开机过程不收费,关机过程不收费,服务成功部署后再计费 卡时单价、机型详见: 更详细的计费规则:
### 什么是云主机?
[Section titled “什么是云主机?”](#什么是云主机)
共绩算力云主机是一款面向 AI 开发的云端工作站,支持随时随地远程访问。它提供完整的开发环境与高性能算力资源,按需计费,让您专注于高效创新,无需操心硬件采购与环境配置。
**请注意:**云主机采用容器化运行环境,而非传统虚拟机,因此不支持在主机内部再启动 Docker 服务。直接写入系统盘路径的文件会被纳入整体镜像环境,进而影响关机时长,建议将持久化数据存放于指定数据卷或外部存储中。
* 平台不支持 windows 系统,
* 平台不直接连接外网,无法直接使用外网的镜像仓库比如[docker.io](http://docker.io/)等,如果需要下载模型等可以使用国内的模型源
#### **云主机的主要功能特点**
[Section titled “云主机的主要功能特点”](#云主机的主要功能特点)
1. **集成开发环境**:在平台预制的基础镜像中提供完整开发工具链,支持主流 AI 框架(如 PyTorch、TensorFlow 全家桶),免去环境配置烦恼,让您专注于开发本身。
2. **镜像管理系统**:高效管理镜像版本,支持一键发布和分发,极大提升开发与部署效率。
3. **一键 Serverless 发布**:开发完成后可一键发布为 Serverless 服务,快速为用户提供在线服务。
4. **分布式训练支持**:支持 1 机多卡和多机联网,轻松实现模型微调和大规模模型训练。
### 关机、关机并保存镜像、强制关机的区别是什么?
[Section titled “关机、关机并保存镜像、强制关机的区别是什么?”](#关机关机并保存镜像强制关机的区别是什么)
云主机提供三种不同的关机方式,分别适用于不同的使用场景。以下详细说明各种方式的特点和使用注意事项。
#### 1. 普通关机
[Section titled “1. 普通关机”](#1-普通关机)
**功能说明:**
普通关机会安全地关闭云主机并停止计费,类似于正常关闭电脑。所有数据和已安装的软件都会完整保存,下次开机时可以完全恢复到关机前的状态。
**主要特点:**
* 立即停止计费,节省成本
* 数据完整保存,包括系统盘和数据盘
* 已安装的软件和配置不会丢失
* 支持随时重新开机
**注意事项:**
* 关机后会释放所有计算节点资源
* 重启时显卡库存可能无法保障(如使用 GPU 实例)
* 请在业务允许的情况下谨慎操作
**适用场景:** 临时不使用实例,希望停止计费但保留完整环境
#### 2. 关机并保存镜像
[Section titled “2. 关机并保存镜像”](#2-关机并保存镜像)
**功能说明:**
在关机的同时,将当前实例的完整状态保存为自定义镜像。这个镜像可以作为”黄金副本”,用于快速创建多个相同配置的新实例,实现环境的快速复制和部署。
**主要特点:**
* 创建可复用的自定义镜像
* 保存完整的系统环境和配置
* 支持基于镜像快速创建新实例
* 关机期间不产生费用
**操作流程:**
1. 实例自动执行关机操作
2. 系统创建自定义镜像(需要一定时间)
3. 保存完成后实例保持关机状态
4. 镜像可在创建新实例时选择使用
**数据安全保障:**
* 所有数据完整保存在镜像中
* 原实例数据不会丢失
* 可基于镜像创建多个副本
**适用场景:** 需要备份当前环境配置,或批量部署相同环境的实例
#### 3. 强制关机
[Section titled “3. 强制关机”](#3-强制关机)
**功能说明:**
强制关机会立即终止实例运行,不进行正常的关机流程。这是一个紧急操作选项,会导致本次开机后的所有实例内变更丢失,状态回滚到本次开机之前。
**重要特性:**
* 立即强制终止实例
* 实例内状态回滚到本次开机前
* 共享存储卷数据不受影响
* 操作不可撤销
**数据影响:**
* 实例内未保存的数据将丢失
* 本次开机后的系统变更将丢失
* 共享存储卷中的数据保持完整
**严重警告:**
此操作类似于直接拔掉电源,可能导致数据丢失或系统损坏。除非实例无响应或遇到紧急情况,否则不建议使用此方式。**操作不可撤销,请务必谨慎评估!**
**适用场景:** 实例卡死、无响应等紧急情况,且确认可以接受数据回滚
#### 对比总结
[Section titled “对比总结”](#对比总结)
| | | | |
| --------- | ------ | ----------- | --------- |
| 对比项 | 普通关机 | 关机并保存镜像 | 强制关机 |
| **关机方式** | 安全关机 | 安全关机 + 创建镜像 | 强制终止 |
| **计费状态** | 停止计费 | 停止计费 | 停止计费 |
| **数据保存** | 完整保存 | 完整保存(含镜像) | 回滚到开机前 |
| **已装软件** | 保留 | 保留(含镜像) | 回滚到开机前 |
| **重启保障** | 库存可能不足 | 库存可能不足 | 库存可能不足 |
| **额外功能** | 无 | 生成可复用镜像 | 无 |
| **操作风险** | 低 | 低 | 高(数据可能丢失) |
| **可撤销性** | 可重启恢复 | 可重启恢复 | 不可撤销 |
| **共享存储卷** | 不影响 | 不影响 | 不影响 |
| **适用场景** | 临时停用 | 环境备份/批量部署 | 紧急处理 |
**选择建议:**
* 日常停用实例 → 选择”普通关机”
* 需要备份或复制环境 → 选择”关机并保存镜像”
* 实例卡死无响应 → 最后考虑”强制关机”
### 什么是 **共享存储卷**?
[Section titled “什么是 共享存储卷?”](#什么是-共享存储卷)
共享存储卷是一种可以被多台云主机或 serverless 服务同时挂载和访问的存储资源。它类似于一个网络硬盘,支持跨实例读写数据,适合团队协作、数据共享、模型/数据集分发等场景。
**典型用途:**
* 多个服务/主机间共享数据、日志、模型文件等。
* 作为持久化存储,服务重启、迁移后数据不丢失。
* 支持大文件、批量数据的高效读写。
**挂载方式:**
* 在云主机或 serverless 服务创建/设置页面,选择需要挂载的共享存储卷(Bucket),并指定挂载路径(如 `/mnt/data`)。
* 启动后,系统会自动将存储卷挂载到指定路径,应用可直接读写。
**挂载要求:**
* 挂载路径必须以 `/` 开头,允许`英文`、`数字`、`-` 和 `/`,如 `/mnt/data`。
* 不同存储卷的挂载路径不能重复,避免冲突。
* 路径建议简洁明了,便于程序访问。
### 共享存储卷和对象存储加速挂载有什么不一样?
[Section titled “共享存储卷和对象存储加速挂载有什么不一样?”](#共享存储卷和对象存储加速挂载有什么不一样)
**功能定位不同:**
* **共享存储卷**:主要用于高性能、高并发的**读写**场景。它像传统的硬盘或网络文件系统(如 NFS),可以被多个计算节点同时挂载,支持文件的频繁读写和修改,适合训练数据、模型中间结果、日志等需要频繁读写的场景。
* **对象存储加速挂载**:主要用于高效读取大规模数据,通常是**只读场景**。它将对象存储(如 S3)的数据通过挂载的方式直接呈现为本地文件系统,方便访问和读取,但写入性能和一致性不如共享存储卷,适合加载大数据集、预训练模型等只读需求。
**技术实现和性能侧重:**
* 共享存储卷:底层通常基于分布式文件系统(如 CephFS、GlusterFS 等),强调高 IOPS 和低延迟,适合高频读写。
* 对象存储加速挂载:底层基于对象存储(如 S3),通过 FUSE 等方式挂载,强调大吞吐量的读取,写入操作一般不推荐或有延迟。
**典型应用场景:**
* 共享存储卷:团队协作开发、分布式训练、实验结果共享、日志收集等需要多节点读写的场景。
* 对象存储加速挂载:大规模数据集加载、模型权重分发、只读数据分析等。
**S3 技术的应用差异:**
虽然两者都用到了 S3 技术,但
* 共享存储卷更像是将 S3 作为后端存储,前端通过分布式文件系统实现高性能读写;
* 对象存储加速挂载则是直接将 S3 对象以文件系统方式只读挂载,主要优化读取体验。
### 云主机的自定义启动命令有什么不一样?
[Section titled “云主机的自定义启动命令有什么不一样?”](#云主机的自定义启动命令有什么不一样)
自定义启动命令,指的是用户可以为云主机或 serverless 服务指定专属的 shell 命令,完全覆盖平台的默认启动逻辑。这一机制赋予了用户极高的灵活性和控制力。
云主机通过与 **Supervisord **的深度结合,实现了真正意义上的自定义启动命令。用户不仅可以完全替换平台默认逻辑,指定任意 Shell 命令作为主进程,还能灵活适配多语言、多进程、复杂初始化等多样化业务场景。例如:
* 启动自定义开发的 Python、Node.js、Java 等各类应用
* 执行复杂的初始化脚本(如 bash init.sh),实现环境预配置与自动化部署
* 启动多进程任务、守护进程或特殊服务,满足个性化业务需求
通过 supervisord 的支持,平台不仅能够实时监控主进程的运行状态,还能实现日志收集、异常处理等高级运维功能。用户填写的自定义启动命令会被 supervisord 作为“受管进程”启动和管理,即使主进程异常退出,**Supervisord **也能自动拉起,极大提升了服务的高可用性与稳定性。用户只需在服务或主机的创建/设置页面填写自定义启动命令(如 python app.py、bash run.sh),系统将在实例启动时,严格按照用户指定的命令拉起主进程,充分释放业务创新空间,助力多样化场景的高效落地。
### **如何将云主机一键发布为 Serverless 服务?**
[Section titled “如何将云主机一键发布为 Serverless 服务?”](#如何将云主机一键发布为-serverless-服务)
* 在云主机实例列表(侧边栏「云主机列表」),选择你要发布的云主机。
* 点击「发布服务」按钮,进入 serverless 服务创建流程。
* 按页面提示填写端口、环境变量、启动命令等信息,确认无误后提交即可一键发布。
* 服务发布后,可在`弹性部署服务`管理页面查看、管理和访问你的服务。
可以参考这篇文档来操作:
### **发布 serverless 服务后如何管理和访问?**
[Section titled “发布 serverless 服务后如何管理和访问?”](#发布-serverless-服务后如何管理和访问)
* 发布成功后,可点击页面顶部`弹性部署服务`按钮,在打开的页面查看和管理发布的服务。
* 支持启动、停止、重启、删除等操作。
* 服务会分配公网访问地址,页面会显示访问方式。
### 如何修改基础镜像中 SSH、VS Code Server 和 Jupyter Lab 的密码?
[Section titled “如何修改基础镜像中 SSH、VS Code Server 和 Jupyter Lab 的密码?”](#如何修改基础镜像中-sshvs-code-server-和-jupyter-lab-的密码)
基础镜像中的 ssh 默认密码在环境变量中,VS Code Server 和 Jupyter Lab 默认没有密码,如果需要密码保护,可以通过以下方法实现:
* 访问:
* 找到要修改的云主机,点击【更多操作】 -> 【查看详情】,在页面顶部点击【环境变量】
* 输入以下变量值
```text
## SSH 登录密码
SSH_PASSWORD=12345678
## VS Code Server 登录密码
CODE_SERVER_PASSWORD=23456
## Jupyter Lab 登录密码
JUPYTER_PASSWORD=67890
```
* 【保存】,然后【应用修改】,一定要点击【应用修改】才会生效
### 为什么云主机内不支持使用 Docker?
[Section titled “为什么云主机内不支持使用 Docker?”](#为什么云主机内不支持使用-docker)
共绩算力的云主机本质上是**基于容器技术(Docker/Kubernetes)虚拟化出来的实例**,而非传统的物理裸金属服务器或 KVM 虚拟机。
由于您当前已经处于一个容器环境中,在容器内部再次运行 Docker Daemon(即 Docker-in-Docker,DinD)会面临严重的安全隔离问题和文件系统挂载冲突。因此,**平台在系统层面禁用了云主机内部的 Docker 服务**。
**最佳实践建议:** - **直接配置环境**:云主机已经为您提供了一个完整的 Ubuntu 操作系统环境(包含 root 权限),您可以直接使用`apt-get`、`pip`、`conda` 等工具安装所需的软件和依赖,就像在普通 Linux 系统中一样。 -**保存自定义镜像**:配置好专属环境后,您可以在云主机列表页点击”更多操作”->“保存镜像”,将其保存为您的”我的镜像”。下次创建新主机时,直接选择该镜像即可复用环境,完全替代了 Docker 的打包功能。

### 为什么系统盘写入大量文件会导致开关机变慢?
[Section titled “为什么系统盘写入大量文件会导致开关机变慢?”](#为什么系统盘写入大量文件会导致开关机变慢)
云主机的系统盘(通常为 80GB)是基于分布式块存储或容器写时复制(CoW)文件系统实现的。当您在系统盘中写入大量数据(如数十 GB 的数据集或模型权重)时:
1. **关机保存慢**:关机会触发系统盘快照或数据同步机制,写入的数据越多,同步耗时越长。
2. **开机恢复慢**:开机时需要从底层存储重新拉取或挂载这些数据,数据量直接决定了开机启动时间。
**最佳实践建议:** **系统盘只用于存放环境和代码**:强烈建议将系统盘(`/`目录)仅用于安装软件环境(如 pip 包)和存放体积较小的代码文件。
**数据和模型分离存储**:大体积的数据集、模型权重、生成的日志和 Checkpoint 等,**必须存放在外挂存储中**(如共享存储卷或对象存储加速)。
### 如何高效管理模型和数据集?
[Section titled “如何高效管理模型和数据集?”](#如何高效管理模型和数据集)
为了解决大文件读写和跨实例共享的问题,平台提供了两种专业存储方案。**强烈推荐”计算与存储分离”的架构设计。**
**方案 A:共享存储卷(适合读写频繁的数据集和代码)**
共享存储卷类似于 NAS(网络附加存储),支持多个云主机同时挂载并读写。
* **优势**:数据持久化保存,不受云主机释放影响;支持多机共享;读写性能优秀。
* **使用场景**:存放训练数据集、代码仓库、训练过程中的 Checkpoint 保存、实验日志输出。
* **配置方法**:
1. 在控制台左侧导航栏进入”共享存储卷”页面。
2. 点击”创建存储桶”,选择所需区域(如需要跨区使用,可转换为多区域桶)。
3. 在创建云主机时,在”共享存储卷”配置区域,选择对应的存储桶并指定挂载目录(如 `/workspace/data`)。

**方案 B:对象存储加速(适合只读的大型模型权重)**
对象存储加速功能可以将阿里云 OSS、AWS S3 等对象存储中的数据,通过缓存技术直接挂载到云主机本地。
* **优势**:将 S3 缓存到集群本地,大幅提升模型加载速度;无需等待几十 GB 模型缓慢下载;不占用系统盘空间。
* **使用场景**:挂载 HuggingFace 模型权重、只读的基础数据集。
* **配置方法**:
1. 在”对象存储加速”页面,添加您在云服务商处的对象存储配置。
2. 点击”开始加速”激活缓存。
3. 在创建云主机时挂载该加速桶。
* **⚠️ 注意事项**:
* 挂载目录为**只读访问**。
* 存储内容更新需要手动点击”回源上游”按钮同步,**不会自动更新**。

### 为什么我的云主机任务一直显示“启动中”?
[Section titled “为什么我的云主机任务一直显示“启动中”?”](#为什么我的云主机任务一直显示启动中)
任务状态持续显示“启动中”,并不意味着任务已卡死,请您放心。
这通常是由于容器环境的初始化流程所致。与虚拟机秒级启动不同,共绩算力云主机会在启动阶段进行以下几项必要工作,根据镜像大小和算力资源池状态,耗时约需 1-3 分钟:
1. 高性能算力调度:系统正在为您分配专属的 GPU/NPU 计算节点。
2. AI 开发镜像加载:正在拉取并挂载包含完整 Python、CUDA、PyTorch 等依赖的预置开发环境(镜像环境)。
3. 持久化存储挂载:正在建立数据卷的远程连接,以保护您的代码不受镜像重启影响。
特别说明:在容器环境下,某些首次写入系统盘的文件会被纳入基础镜像快照,这可能导致下次启动时的环境校验时间略长。只要界面未提示“失败”,请耐心等待进度条走完。
若等待超过 5 分钟 状态仍未更新,再建议您刷新页面或联系技术支持排查节点异常。
### 为什么云主机节点数不能设置为 0?
[Section titled “为什么云主机节点数不能设置为 0?”](#为什么云主机节点数不能设置为-0)
共绩算力云主机采用的是容器化持久工作空间,而非函数计算或短生命周期 Pod。一旦将实例数缩减至 0,容器状态会被彻底销毁,虽然挂载的数据卷文件仍在,但以下内容将会丢失,导致下次启动恢复环境耗时极长且可能报错:
* 运行中的内存状态:未保存的 Jupyter 内核变量。
* 系统盘安装的依赖:直接写入 `/usr/local` 或 `apt install` 的软件包(因容器镜像机制会被丢弃)。
因此,为了保障“随时随地打开即用”的体验,系统强制保留至少 1 个运行实例作为环境锚点。
### 总结:标准的高效 AI 开发架构
[Section titled “总结:标准的高效 AI 开发架构”](#总结标准的高效-ai-开发架构)
为了获得最佳的体验和性价比,建议您采用以下架构使用共绩算力云主机:
1. **系统盘(80GB)**:仅安装 CUDA、PyTorch、依赖包及核心运行脚本。配置完成后保存为自定义镜像。
2. **对象存储加速(只读)**:挂载至 `/models`,用于直接读取百 GB 级别的大语言模型权重,实现秒级加载。
3. **共享存储卷(读写)**:挂载至 `/data` 和`/output`,用于存放微调数据集和保存训练 Checkpoint。
遵循以上架构,您的云主机将实现**秒级开机、环境稳定、数据安全**的完美体验。
# 使用说明
# 如何使用 SSH 连接云主机
👋
【数据安全必读】
系统盘与数据盘均为本地 SSD,无冗余,单点故障可能导致数据永久丢失。
请务必将重要数据实时备份至「共享存储卷」或本地,共绩算力对本地盘损坏及数据丢失不承担任何责任。
立即开通共享存储卷,获得企业级冗余 + 跨区域同步,彻底告别数据丢失:\
SSH 隧道可以将云服务器的端口代理到本地,或者代理本地端口到云服务器。
## **1.图形工具**
[Section titled “1.图形工具”](#1图形工具)
**electerm - 跨平台 SSH 客户端**
推荐使用 \[electerm]\(**) 作为 SSH 客户端,这是一个功能强大的跨平台终端/SSH/SFTP/FTP/Telnet/串口/RDP/VNC 客户端,支持 Linux、Mac 和 Windows 系统。

**主要特性:**
* 支持 SSH 隧道功能
* 多平台支持(Linux、Mac、Windows)
* 图形化界面,操作简单直观
* 支持公钥 + 密码认证
* 内置文件管理器功能
* 支持多语言界面
**安装方式:**
* Mac 用户:`brew install --cask electerm`
* Windows 用户:`winget install electerm.electerm` 或从 Microsoft Store 安装
* Linux 用户:`sudo snap install electerm --classic` 或从各发行版的软件商店安装
* 通过 npm 安装:`npm i -g electerm`
## **2.SSH 代理命令**
[Section titled “2.SSH 代理命令”](#2ssh-代理命令)
### **2.1 代理云服务器中的端口到本地**
[Section titled “2.1 代理云服务器中的端口到本地”](#21-代理云服务器中的端口到本地)
具体步骤为:
1. 在云服务器中启动您的服务 在关机状态下配置 SSH 登录
 
1. 若您使用的是基础镜像点击完成配置

1. 配置完成后点击开机
 
1. 在本地电脑的终端 (cmd / powershell / terminal 等) 中执行代理命令:
```yaml
ssh root@hdy1.550c.cloud -p 40002
```

这是 SSH 首次连接某台服务器时的标准安全提示流程。用户输入 yes 确认信任该主机后,系统将其公钥保存,以便下次连接时验证身份。
Windows 下的 cmd/powershell 如果一直提示密码错误,是因为无法粘贴,手动输入即可(正常不会显示正在输入的密码)

1. 连接成功

1. 代理云服务器到本地端口
```bash
ssh -vvN -L 8889:127.0.0.1:8888 root@hdy1.550c.cloud -p 40002
```
典型输出片段(只要出现就说明转发通道已建立):

看到 `Entering interactive session.` 就表示隧道 OK,不会再有其他提示。
### **2.2 代理本地端口到云服务器**
[Section titled “2.2 代理本地端口到云服务器”](#22-代理本地端口到云服务器)
上面代理云服务器中的端口到本地的 Step.2 中的命令:
```bash
ssh -CNg -L 8888:127.0.0.1:8888 root@hdy1.550c.cloud -p 40002
```
只需将上面的命令修改参数 -L 为 -R 即代理本地端口到云服务器
```bash
ssh -p 40002 -fN -R 8888:localhost:8889 root@hdy1.550c.cloud
```
## 3.常见错误
[Section titled “3.常见错误”](#3常见错误)
1. Windows 下执行 ssh 代理时权限报错?
一般有两种错误
第一种:
```text
It is required that your private key files are NOT accessible by others.
This private key will be ignored.
Load key "C:\\Users\\Administrator/.ssh/id_rsa": bad permissions
```
解决方法:修改报错信息中的`C:\\Users\\Administrator/.ssh/id_rsa`文件为只读文件
第二种:
```text
Bad owner or permissions on C:\\Users\\Administrator\\.ssh\\config
```
解决方法:删除该 config 文件`C:\\Users\\Administrator\\.ssh\\config`文件为只读文件
1. SSH 指令的各个参数什么含义?
```bash
ssh -vvN -L 8889:127.0.0.1:8888 root@hdy1.550c.cloud -p 40002
```
在 SSH 命令中,各参数的含义如下:
* `-vv`:表示输出详细的调试信息,用于诊断连接问题。
* `-N`:表示不执行远程命令,仅建立连接。
* `-L`:表示本地端口转发,将本地端口映射到远程主机的端口。
* `8889:127.0.0.1:8888`:表示将本地的 8889 端口映射到远程主机 127.0.0.1 的 8888 端口。
* `root`:表示远程主机的用户名。
* `hdy1.550c.cloud`:表示远程主机的地址。
* `-p 40002`:表示远程主机的 SSH 端口。
# 云主机启动命令配置规范
## **1. 核心概念**
[Section titled “1. 核心概念”](#1-核心概念)
在 共绩算力 平台中,您填写的”启动命令”对应于容器的 `command`(容器启动命令)和 `args`(命令参数)字段。
* command:对应 Docker 的 `ENTRYPOINT`,是容器的主进程
* args:对应 Docker 的 `CMD`,是传递给主进程的参数
### **1.1 配置示例场景**
[Section titled “1.1 配置示例场景”](#11-配置示例场景)
当您自己打包上传的镜像未配置启动命令时,需要手动配置启动命令。以下是典型示例:
**vllm 镜像中启动模型 示例:**
```bash
vllm serve Qwen/Qwen3-VL-8B-Instruct-FP8 --max-model-len 32K --max-num-seqs 4 --limit-mm-per-prompt '{"image":4,"video":0}' --mm-processor-cache-gb 0
```

**Indextts 镜像示例:**
```bash
GRADIO_ROOT_PATH=$(echo "$HOSTNAME" | sed -E 's,^(([^-]+-){3}).*,https://\17860.550c.cloud,') .venv/bin/python webui.py
```

**Sora2 API 镜像调用示例:**
```bash
/bin/bash
-c
cd /root && bash run.sh
```
## **2. 常见问题分类**
[Section titled “2. 常见问题分类”](#2-常见问题分类)
启动命令配置问题主要分为以下几类:
常见启动命令问题分类与检测要点
| | |
| -------- | -------------------------------------- |
| **错误类型** | **检测要点** |
| **格式错误** | 缺少引号、尾逗号、引号不匹配(如使用双引号未转义) |
| | 参数之间缺少必要的空格 |
| | 错误的大小写使用(如参数名或值的大小写不正确) |
| **参数错误** | 参数值超出范围(如数值过大或过小) |
| | 参数值不符合要求(如模型名拼写错误、路径错误) |
| | 必要参数遗漏(如缺少关键的启动参数) |
| | 重复参数导致冲突(如同一参数多次出现) |
| **命令拆分** | 错误地将命令主体(如 `ENTRYPOINT`)和参数(如 `CMD`)混淆 |
| | 未正确拆分命令主体和参数,导致命令无法正确解析 |
| **特殊字符** | 使用了不被支持的特殊字符(如中文标点、换行符等) |
| **测试不足** | 未在本地或测试环境中验证命令的有效性,导致容器启动失败 |
| **缓存问题** | 指定的缓存路径不可用或权限不足,导致命令执行失败 |
| **顺序问题** | 参数顺序错误,导致命令解析失败 |
## **3. 错误案例与解决方案**
[Section titled “3. 错误案例与解决方案”](#3-错误案例与解决方案)
### **3.1 引号与转义问题**
[Section titled “3.1 引号与转义问题”](#31-引号与转义问题)
**错误示例:**
```bash
--limit-mm-per-prompt {"image":4,"video":0}
```
**错误现象:** Shell 把花括号当成通配符,报错 `cannot find file 4`
**正确写法:**
```bash
--limit-mm-per-prompt '{"image":4,"video":0}'
```
**错误示例:**
```bash
--limit-mm-per-prompt "{\"image\":4,\"video\":0}"
```
**错误现象:** 平台把 `\"` 当普通字符,JSON 解析失败
**正确写法:** 改用单引号包裹整段 JSON,内部用双引号即可
```bash
--limit-mm-per-prompt '{"image":4,"video":0}'
```
### **3.2 空格缺失问题**
[Section titled “3.2 空格缺失问题”](#32-空格缺失问题)
**错误示例:**
```bash
--mm-processor-cache-gb0
```
**错误现象:** 识别不出参数,提示 `unknown flag -gb0`
**正确写法:**
```bash
--mm-processor-cache-gb 0
```
### **3.3 大小写问题**
[Section titled “3.3 大小写问题”](#33-大小写问题)
**错误示例:**
```bash
--max-model-len 32k
```
**错误现象:** 日志报错 `Unit suffix must be upper-case`
**正确写法:**
```bash
--max-model-len 32K
```
### **3.4 模型名大小写问题**
[Section titled “3.4 模型名大小写问题”](#34-模型名大小写问题)
**错误示例:**
```bash
qwen/qwen3-vl-8b-instruct-fp8
```
**错误现象:** 远端返回 `repository not found`
**正确写法:** 严格按官方大小写
```bash
Qwen/Qwen3-VL-8B-Instruct-FP8
```
### **3.5 数值越界问题**
[Section titled “3.5 数值越界问题”](#35-数值越界问题)
**错误示例:**
```bash
--max-num-seqs 4
```
**错误现象:** 启动即崩溃,日志 `ValueError: 4 < minimum 16`
**正确写法:** 改到允许范围
```bash
--max-num-seqs 16
```
### **3.6 必传子命令缺失**
[Section titled “3.6 必传子命令缺失”](#36-必传子命令缺失)
**错误示例:**
```bash
vllm
```
**错误现象:** 容器立即退出,提示 `missing sub-command`
**正确写法:** 运行参数第一格补 `serve`
```bash
vllm serve
```
### **3.7 参数重复问题**
[Section titled “3.7 参数重复问题”](#37-参数重复问题)
**错误示例:** 表单里填 `--max-model-len 32K`,又在”添加启动参数”里写一遍 `--max-model-len 32K`
**错误现象:** 命令行出现两次,vLLM 报 `duplicate argument`
**正确写法:** 只保留一处
### **3.8 顺序敏感问题**
[Section titled “3.8 顺序敏感问题”](#38-顺序敏感问题)
**错误示例:**
```bash
serve --limit-mm-per-prompt '{"image":4}' Qwen/...
```
**错误现象:** 旧版本 vLLM 把 JSON 当模型路径,报 `file not found`
**正确写法:** 模型名紧跟 `serve`,选项放前面
```bash
vllm serve Qwen/Qwen3-VL-8B-Instruct-FP8 --limit-mm-per-prompt '{"image":4}'
```
### **3.9 特殊字符问题**
[Section titled “3.9 特殊字符问题”](#39-特殊字符问题)
**错误示例:** JSON 尾逗号
```json
{"image":4,"video":0,}
```
**错误现象:** 严格解析器报错 `trailing comma`
**正确写法:** 去掉尾逗号
```json
{"image":4,"video":0}
```
### **3.10 平台转义问题**
[Section titled “3.10 平台转义问题”](#310-平台转义问题)
**错误示例:** YAML 表单填 `--limit-mm-per-prompt '{"image":4}'` 后,平台渲染成 `map[image:4]`
**错误现象:** 容器启动失败
**正确写法:** 在 YAML 中用单引号包裹整行,或对 `{` 进行双引号转义
### **3.11 Windows 换行问题**
[Section titled “3.11 Windows 换行问题”](#311-windows-换行问题)
**错误示例:** 脚本里出现 `\r--max-model-len`
**错误现象:** 报错 `\r--max-model-len: command not found`
**正确写法:** 使用 `dos2unix` 转换或在编辑器中选择 LF 换行
## **4. Docker 到 Kubernetes 命令转换指南******
[Section titled “4. Docker 到 Kubernetes 命令转换指南 ”](#4-docker-到-kubernetes-命令转换指南-)
### **4.1 端口映射转换**
[Section titled “4.1 端口映射转换”](#41-端口映射转换)
Docker 中的 `-p 8080:80` 应该通过平台设置暴露端口,而不是加到启动参数里面。在平台配置界面中设置端口映射即可。

### **4.2 存储卷挂载转换**
[Section titled “4.2 存储卷挂载转换”](#42-存储卷挂载转换)
Docker 中的 `-v data:data` 在平台对应的是设置对象存储加速或者共享存储卷。在平台配置界面中设置存储卷挂载即可。

### **4.3 环境变量转换**
[Section titled “4.3 环境变量转换”](#43-环境变量转换)
Docker 中的 `-e KEY=VALUE` 在 Kubernetes 中通过环境变量配置,在平台配置界面中设置环境变量即可。

### 4.4 覆盖规则与冲突排查 入口点(ENTRYPOINT / CMD)
[Section titled “4.4 覆盖规则与冲突排查 入口点(ENTRYPOINT / CMD)”](#44-覆盖规则与冲突排查-入口点entrypoint--cmd)
只要在平台表单里填写了「启动命令」,就等于把镜像里原来的 ENTRYPOINT 和/或 CMD 全部或部分替换;不写才保留镜像默认值。 很多“格式明明对却起不来”的案例,本质是两段命令打架,而非语法错误。
| | | | |
| ------------------------------------------------------------------- | ----------------------------------- | ----------------------------- | -------------------------------------------------- |
| 镜像里自带 | 平台里填写 | 最终生效的进程(数组拼接) | 常见现象 |
| ENTRYPOINT \["/start.sh"] CMD \["python","[app.py](http://app.py)"] | 只填 args → \["vllm","serve","..."] | /start.sh vllm serve ... | 报错“vllm 找不到”——脚本并不认识该子命令 |
| ENTRYPOINT \["python"] CMD \["[app.py](http://app.py)"] | 填 command → \["vllm","serve","..."] | vllm serve ...(python 被整体替换) | 正常启动 |
| ENTRYPOINT \["tini","--","python"] CMD \["[app.py](http://app.py)"] | 只填 args → \["vllm","serve","..."] | tini -- python vllm serve ... | 信号代理仍在,但 python 把 vllm 当模块名,报 No module named vllm |
| ENTRYPOINT \[] CMD \[] | 填 command + args | 完全按平台填写执行 | 最可控,推荐 |
### 4.4.1 快速自检三步法
[Section titled “4.4.1 快速自检三步法”](#441-快速自检三步法)
1. `docker inspect <镜像> | jq '.[0].Config.Entrypoint, .[0].Config.Cmd'` 看清镜像“出厂设置”。
2. 把「平台要填的 command / args」与上一步结果拼成一行数组,确认是否合法。
3. 本地先验证: `docker run --rm -it --entrypoint <镜像> ` 能跑通再贴到平台,可排除 90% 的“冲突型”启动失败。
### 4.4.2 平台使用策略
[Section titled “4.4.2 平台使用策略”](#442-平台使用策略)
| | |
| ------------------------- | ------------------------------------------------------------ |
| 场景 | 建议 |
| 镜像作者已提供完整启动脚本(ENTRYPOINT) | 仅使用 args,不要写 command;否则就把脚本完全覆盖掉。 |
| 镜像只给了 CMD,ENTRYPOINT 为空 | 可写 command,也可只写 args;推荐写 command,语义清晰。 |
| 需要完全掌控启动流程 | 在平台一次性写全 command,把镜像 ENTRYPOINT 覆盖掉;args 留空或继续追加参数。 |
| 不确定镜像逻辑 | 先用调试命令 \["sleep","infinity"] 让容器常驻,再 exec 进去手工跑一遍,看看到底需要哪一段。 |
**一旦在平台配置 command,就等于把 Dockerfile 里的 ENTRYPOINT 整体替换**
**写下 args,就等于把 Dockerfile 里的 CMD 整体替换**
**先想清楚要保留哪一段,再把缺失的补全,就不会再冲突**
## **5. 调试命令**
[Section titled “5. 调试命令”](#5-调试命令)
### **5.1 保持容器运行**
[Section titled “5.1 保持容器运行”](#51-保持容器运行)
当您的任务没有主进程时,容器会反复重启,可使用以下调试命令保持容器运行:
**方案 A:使用 sleep 命令**
```yaml
command: ["sleep", "infinity"]
```
内核调度器永远不会给该进程设置唤醒时间,因此只有收到信号才会返回。可响应 SIGTERM,容器停止时能做到优雅退出(< 10 ms 级返回)。
**方案 B:使用 tail 命令**
```yaml
command: ["tail", "-f", "/dev/null"]
```
tail 阻塞在 read() 上,永远等不到新数据,于是进程永不结束。同样几乎不占 CPU,但比 sleep 多一次不必要的文件描述符打开。
### **5.2 使用场景**
[Section titled “5.2 使用场景”](#52-使用场景)
* 镜像打包后需要进入容器手动调试
* 应用启动失败需要排查环境问题
* 测试存储卷挂载、网络连通性等基础环境
### **5.3 调试步骤**
[Section titled “5.3 调试步骤”](#53-调试步骤)
1. 使用调试命令启动容器
2. 通过 Web 终端或 exec 进入容器
3. 手动执行命令排查问题
4. 修复问题后更新启动命令
## **6. 最佳实践**
[Section titled “6. 最佳实践”](#6-最佳实践)
### **6.1 命令格式规范**
[Section titled “6.1 命令格式规范”](#61-命令格式规范)
1. **参数分隔**:参数与值之间必须使用空格分隔
2. **引号使用**:JSON 格式参数使用单引号包裹,内部使用双引号
3. **大小写敏感**:严格按照官方文档的大小写要求配置参数和值
### **6.2 参数配置建议**
[Section titled “6.2 参数配置建议”](#62-参数配置建议)
1. **避免重复参数**:同一参数只在一处配置,避免在多个位置重复设置
2. **参数顺序**:遵循工具要求的参数顺序,通常模型名应紧跟子命令
3. **数值范围**:确保参数值在允许范围内,避免越界错误
4. **必要参数**:确保所有必要的启动参数都已配置
### **6.3 测试验证**
[Section titled “6.3 测试验证”](#63-测试验证)
1. **本地测试**:在本地环境验证命令的有效性
2. **测试环境**:在测试环境中验证命令配置
3. **日志检查**:启动后检查容器日志,确认命令执行正常
4. **功能验证**:验证应用功能是否正常
### **6.4 常见注意事项**
[Section titled “6.4 常见注意事项”](#64-常见注意事项)
1. **换行符**:Windows 环境下注意使用 LF 换行符,避免 `\r` 字符导致命令解析失败
2. **特殊字符**:避免使用中文标点等不被支持的特殊字符
3. **路径配置**:确保路径配置正确,使用绝对路径
4. **权限问题**:确保缓存路径等目录具有正确的访问权限
## 7.参考文档
[Section titled “7.参考文档”](#7参考文档)
k8s 中启动命令相关文档:
# 云主机服务转弹性部署服务
## **一、进入部署入口**
[Section titled “一、进入部署入口”](#一进入部署入口)
当使用**基础镜像**或**通过基础镜像保存的镜像**时,选择`部署服务`。

## **二、关机并保存镜像**
[Section titled “二、关机并保存镜像”](#二关机并保存镜像)
先对实例进行关机操作并保存镜像,同时设置好镜像标签,便于后续快速选择。

## **三、选择部署配置**
[Section titled “三、选择部署配置”](#三选择部署配置)
根据业务需求完成部署相关配置选择。

## **四、配置启动命令**
[Section titled “四、配置启动命令”](#四配置启动命令)
进入启动命令配置环节,完成对应参数填写。

## 五、配置运行命令与运行参数
[Section titled “五、配置运行命令与运行参数”](#五配置运行命令与运行参数)
使用基础镜像或基于基础镜像保存的镜像进行部署时,必须配置以下预制运行命令与运行参数,服务方可正常启动。
### 运行命令
[Section titled “运行命令”](#运行命令)
```bash
/bin/bash
```
### 运行参数
[Section titled “运行参数”](#运行参数)
```bash
-c
```
```bash
/init/init.sh
cat > /etc/supervisord.conf << 'EOF'
[supervisord]
nodaemon=true
[program:sshd]
command=/usr/sbin/sshd -D
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
[program:code-server]
command=/usr/bin/code-server --bind-addr 0.0.0.0:62661
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
[program:jupyterlab]
command=/opt/miniconda3/bin/jupyter-lab --ip=0.0.0.0 --port=8888 --allow-root --no-browser
directory=/root
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
environment=HOME="/root",PATH="/opt/miniconda3/bin:%(ENV_PATH)s"
EOF
exec supervisord -c /etc/supervisord.conf
```
## **六、创建弹性部署服务**
[Section titled “六、创建弹性部署服务”](#六创建弹性部署服务)
确认所有镜像部署配置信息无误后,点击**确认部署**,系统将自动创建弹性部署服务。 启动预计耗时:2–5 分钟。

# 如何使用基础镜像/通过基础镜像保存的镜像
## 1.当我们 使用基础镜像/通过基础镜像保存的镜像 选择 `部署服务` 时
[Section titled “1.当我们 使用基础镜像/通过基础镜像保存的镜像 选择 部署服务 时”](#1当我们-使用基础镜像通过基础镜像保存的镜像-选择-部署服务-时)

## 2.先进行关机并保存镜像,设置好镜像标签,方便一会选择
[Section titled “2.先进行关机并保存镜像,设置好镜像标签,方便一会选择”](#2先进行关机并保存镜像设置好镜像标签方便一会选择)

## 3.选择配置
[Section titled “3.选择配置”](#3选择配置)

## 4.配置启动命令
[Section titled “4.配置启动命令”](#4配置启动命令)

## 5.配置运行命令和运行参数
[Section titled “5.配置运行命令和运行参数”](#5配置运行命令和运行参数)
当选择的 使用基础镜像/通过基础镜像保存 时需要配置我们预制的运行命令和运行参数才能正常启动:
运行命令:
```bash
/bin/bash
```
运行参数:
```bash
-c
```
```bash
/init/init.sh
cat > /etc/supervisord.conf << 'EOF'
[supervisord]
nodaemon=true
[program:sshd]
command=/usr/sbin/sshd -D
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
[program:code-server]
command=/usr/bin/code-server --bind-addr 0.0.0.0:62661
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
[program:jupyterlab]
command=/opt/miniconda3/bin/jupyter-lab --ip=0.0.0.0 --port=8888 --allow-root --no-browser
directory=/root
autostart=true
autorestart=true
stdout_logfile=/dev/stdout
stderr_logfile=/dev/stderr
environment=HOME="/root",PATH="/opt/miniconda3/bin:%(ENV_PATH)s"
EOF
exec supervisord -c /etc/supervisord.conf
```
## 6.创建弹性部署服务
[Section titled “6.创建弹性部署服务”](#6创建弹性部署服务)
确认部署镜像配置信息后点击确认部署后,系统将创建弹性部署服务,预计需要 2-5 分钟启动时间。

# 云主机如何设置端口信息
在共绩算力平台上使用云主机进行 AI 开发时,经常需要将云主机内部的服务(如 JupyterLab、WebUI、API 接口等)暴露到公网,或者通过 SSH 远程连接到云主机。本文将详细介绍云主机的端口配置机制、快捷访问功能以及 SSH 登录的最佳实践。
## 1. 快捷访问(HTTP 端口暴露)
[Section titled “1. 快捷访问(HTTP 端口暴露)”](#1-快捷访问http-端口暴露)
云主机的”快捷访问”功能允许将容器内部的 HTTP 服务端口直接映射为公网可访问的 HTTPS 域名。这是访问 WebUI(如 StableDiffusion WebUI、ComfyUI)或开发环境(如 JupyterLab)最推荐的方式。
### 1.1 默认快捷访问端口
[Section titled “1.1 默认快捷访问端口”](#11-默认快捷访问端口)
在云主机详情页的”常规”标签下,系统会默认提供两个快捷访问链接:
* **8188 端口**:通常用于 ComfyUI 等默认监听 8188 的服务。
* **8888 端口**:通常用于 JupyterLab 等默认监听 8888 的服务。
点击”复制”即可获取带有身份验证或随机后缀的公网链接,直接在本地浏览器中打开。

### 1.2 自定义添加端口
[Section titled “1.2 自定义添加端口”](#12-自定义添加端口)
如果您的服务运行在其他端口(例如 Gradio 默认的 7860 端口),可以通过以下步骤手动添加:
1. 在云主机详情页,点击快捷访问区域的 **“添加端口”** 按钮。
2. 在弹出的对话框中,输入需要暴露的内部端口号(如 `7860`)。
3. 点击 **“创建”**。此时新端口会显示在列表中,状态为”待提交”。
4. **关键步骤**:点击页面底部的 **“应用修改”** 按钮,并在弹出的确认框中点击 **“确认修改”**。

## 2. SSH 登录配置
[Section titled “2. SSH 登录配置”](#2-ssh-登录配置)
除了 Web 界面,许多开发者更习惯使用 SSH 直连云主机进行代码调试和环境配置。
### 2.1 获取 SSH 登录信息
[Section titled “2.1 获取 SSH 登录信息”](#21-获取-ssh-登录信息)
在”云主机列表”页面,每台云主机的卡片上都有一个 **“SSH 登录信息”** 区域。如果集群支持 SSH,点击即可查看连接命令、端口号和密码。

### 2.2 SSH 登录注意事项
[Section titled “2.2 SSH 登录注意事项”](#22-ssh-登录注意事项)
平台对 SSH 登录有严格的安全和生命周期管理机制,请务必注意以下几点:
* **端口动态变化**:如关机超过 7 天再开机,SSH 端口可能会发生变化。如遇登录失败,请重新获取最新的登录指令。
* **保持连接**:建议定期登录以保持 SSH 连接稳定。
* **密码安全**:云主机重启时会自动重置命令行修改的密码。强烈建议通过 Web 界面修改密码,并妥善保管,严禁泄露给他人。
### 2.3 自定义镜像的 SSH 配置
[Section titled “2.3 自定义镜像的 SSH 配置”](#23-自定义镜像的-ssh-配置)
如果您使用的是自定义镜像或基础镜像,可能默认未安装 SSH 服务。 必须先**安装并配置 SSH 服务**后,才能使用平台的 SSH 登录功能。
在云主机列表页点击 **“配置 SSH 登录”**,可以指定 SSH 服务在容器内部监听的端口(默认通常为 22)。

## 3. 最佳实践总结
[Section titled “3. 最佳实践总结”](#3-最佳实践总结)
1. **Web 服务优先使用快捷访问**:对于带有 Web 界面的应用,使用快捷访问不仅配置简单,而且自带 HTTPS 加密,安全性更高。
2. **记得”应用修改”**:添加或删除快捷端口后,务必点击页面底部的”应用修改”,否则配置不会生效。
3. **SSH 密码管理**:不要在命令行中使用 `passwd`修改密码(重启会失效),应统一在控制台 Web 界面进行密码管理。
4. **端口冲突检查**:在云主机内部启动服务前,请确保所选端口(如 8188,8888, 7860)未被其他进程占用。
# 云主机中使用共享存储卷
## **一、产品概述**
[Section titled “一、产品概述”](#一产品概述)
共享存储卷是共绩算力自主研发的高性能云存储解决方案,采用独特的分布式存储技术,实现本地磁盘与云端存储的无缝对接。您可以将存储桶直接挂载到云主机的目录中,就像使用本地硬盘一样简单方便,同时享受云端存储的安全性和跨区域同步能力。
### **核心特性**
[Section titled “核心特性”](#核心特性)
* **简单易用**:存储桶可直接挂载到云主机目录,操作体验与本地磁盘完全一致
* **数据安全**:云主机关闭或销毁后,您的数据依然安全保存在云端
* **智能同步**:同一存储桶可自动同步到不同区域,让您就近访问数据
* **高可靠性**:采用共绩算力独有的存储技术,提供企业级数据安全保障
* **灵活扩容**:支持按需扩容,最大支持 200 GB 存储空间
## **二、使用指南**
[Section titled “二、使用指南”](#二使用指南)
### **1. 创建存储桶**
[Section titled “1. 创建存储桶”](#1-创建存储桶)
* 点击顶部的【云主机】 -> 【共享存储卷】 -> 【创建存储桶】

* 填写存储桶的基本信息:
**名称**:给您的存储桶起个名字(必填,最多 10 个字符)
**描述**:简单说明这个存储桶的用途(必填,最多 50 个字符)
**容量**:设置存储桶的大小(1-200 GB 之间)

* 点击”创建”按钮,存储桶就创建完成了
**重要提醒**:
* 创建存储桶时设定的容量会立即从总存储空间中分配并占用,即使您还没有上传任何文件。请根据实际需要合理设置容量,避免浪费存储空间。
* Beta 版本**不支持修改存储大小**,请谨慎设置;正式版本会支持修改存储桶的大小。
### **2. 查看连接的云主机**
[Section titled “2. 查看连接的云主机”](#2-查看连接的云主机)
* 在存储桶列表中,如果存储桶已经被占用,则会显示“{1}个服务

* 点击 1 个服务,会显示使用了存储桶的实例名称和挂载路径

### **3. 修改存储桶**
[Section titled “3. 修改存储桶”](#3-修改存储桶)
* 点击存储桶的”编辑”按钮
* 您可以修改存储桶的名称、描述

**重要提醒:**Beta 版本**不支持修改存储大小**,请谨慎设置;正式版本会支持修改存储桶的大小。
* 点击”保存修改”按钮完成更新
### **4.** **删除存储桶**
[Section titled “4. 删除存储桶”](#4-删除存储桶)
* 点击存储桶的”删除”按钮
* 如果当前存储桶已经被挂载到了云主机或者服务部署,则禁止删除,弹出以下对话框。将挂载的目录从存储桶中去掉之后,就可以正常删除了。

* 对于没有被挂载的共享存储桶,则系统会要求您输入手机验证码来确认删除

* **删除后数据将无法恢复,请务必谨慎操作**
### 5、云主机挂载
[Section titled “5、云主机挂载”](#5云主机挂载)
> 请参考[快速上手云主机服务](https://www.gongjiyun.com/docs/cloud-hosting/quickstart/rtsfwxqkiiozojkcia9cxrvgntf/),创建云主机
* 云主机创建过程中挂载

* 云主机创建之后挂载
选择【云主机】-> 【云主机列表】,找到云主机,点击【更多操作】 -> 【挂载共享存储卷】

在弹出的对话框中,将存储桶挂载到指定目录

### 6、服务部署挂载
[Section titled “6、服务部署挂载”](#6服务部署挂载)
> 服务部署当前只支持在服务部署任务创建之后才能挂载
* 服务部署创建之后挂载
在【弹性部署服务】-> 【任务列表】,选中要挂载的任务,点击任务,到任务详情页,点击【设置】

设置挂载目录之后,点击【保存】,并【应用修改】,即可完成服务部署的存储桶挂载。
## **主要功能说明**
[Section titled “主要功能说明”](#主要功能说明)
### **存储桶管理**
[Section titled “存储桶管理”](#存储桶管理)
* **灵活创建**:最多可以创建 5 个存储桶,每个都可以独立管理,5 个桶共享 200 GB 的空间配额
* **容量自由**:可以根据需要自定义存储桶容量,从 1 GB 到 200 GB 任您选择
* **共享空间**:所有存储桶共享该区域的 20 GB 免费空间和 200 GB 总空间
* **即时分配**:创建存储桶时设定的容量会立即分配并占用存储空间
* **使用透明**:清楚显示每个存储桶的挂载情况和访问路径
* **安全操作**:支持存储桶信息修改和安全删除,保护您的数据安全
## **计费说明**
[Section titled “计费说明”](#计费说明)
### **免费额度**
[Section titled “免费额度”](#免费额度)
* **免费空间**:每个存储卷创建后,您就可以免费使用 20 GB 存储空间
* **共享机制**:这 20 GB 免费空间由该区域内的所有存储桶共享使用
* **永久免费**:这 20 GB 空间永久免费,没有时间限制
* **功能完整**:在免费空间内,您可以享受所有存储功能
### **付费规则**
[Section titled “付费规则”](#付费规则)
* **当前为 Beta 版本运行,此期间使用完全免费。正式版本上线后按照使用量进行收费。**
## **使用建议**
[Section titled “使用建议”](#使用建议)
### **性能优化**
[Section titled “性能优化”](#性能优化)
**合理分配**:根据您的实际需求来分配存储桶容量,避免浪费
### **成本控制**
[Section titled “成本控制”](#成本控制)
* **定期检查**:经常查看您的存储使用情况,避免超出预期
* **合理规划**:根据实际需求来规划存储容量,避免不必要的费用
* **空间共享**:注意所有存储桶共享 20 GB 免费空间,合理分配各存储桶容量
* **谨慎创建**:创建存储桶时设定的容量会立即占用空间,请根据实际需要设置
## **重要提醒**
[Section titled “重要提醒”](#重要提醒)
### **数据同步**
[Section titled “数据同步”](#数据同步)
* 当多个云主机同时读写文件时,可能会有短暂的延迟
* 系统会确保数据最终保持一致,建议您在重要操作时稍等一下
* 对于重要的文件操作,建议等待数据同步完成后再进行下一步
### **节点管理**
[Section titled “节点管理”](#节点管理)
* 如果某个地区的存储节点 15 天内没有被使用,系统会自动释放
* 重新使用时可能需要一些预热时间,建议您提前规划使用
* 定期使用存储桶可以避免节点被释放
### **使用限制**
[Section titled “使用限制”](#使用限制)
* 每个存储卷最大支持 200 GB 空间
* 您最多可以创建 5 个存储桶
* 存储桶的名称不能重复(**系统会忽略大小写**)
# 产品计费
# 云主机服务计费说明
## 云主机计费基本规则
[Section titled “云主机计费基本规则”](#云主机计费基本规则)
* 随取随用,按量计费,精确到秒
* 费用= 时长 x 单价
* 时长=计费结束时间 - 计费开始时间。
* 卡型单价详见:
## 计费开始时间&计费结束时间
[Section titled “计费开始时间&计费结束时间”](#计费开始时间计费结束时间)
* **计费开始时间:**云主机开机成功,处于“运行中”状态
当云主机处于运行中状态时。即分配好节点、拉取到镜像,并成功启动。

* **计费结束时间:**停止服务时
点击所在任务左侧栏的【设置】,下拉页面,点击【停止服务】。
```plaintext
注:关机后,GPU即释放,但是历史缓存数据不会释放;云主机实例会保存在云主题列表中,后续可随时重启,无需重复拉取镜像。
```

## 扣费时机
[Section titled “扣费时机”](#扣费时机)
* 整点扣费、关机、释放实例时扣费
* 扣费金额为扣费周期内的费用,使用时长精确到秒
## 常见问题
[Section titled “常见问题”](#常见问题)
### Q:镜像拉取过程收费吗?
[Section titled “Q:镜像拉取过程收费吗?”](#q镜像拉取过程收费吗)
最开始的拉取镜像过程(可能长达数小时)不收费。是否开始收费以服务是否成功部署为准,镜像上传阶段服务还在部署中,**不收费**。后续在相同区域创建新的云主机,镜像已缓存在集群中,可以快速拉取。

### Q:关机过程中,收费吗?
[Section titled “Q:关机过程中,收费吗?”](#q关机过程中收费吗)
**不收费**。只要您点击了【关机】按钮,出现“已停止计费,关机中”,则系统会自动停止计费。

### Q:关机后,还收费吗?
[Section titled “Q:关机后,还收费吗?”](#q关机后还收费吗)
**不收费**。关机后,GPU 会释放。
与服务部署不同的是,关机后,GPU 会被释放,您之前安装的软件、修改的系统设置等**数据依然会保留**。对于系统中需要的业务数据,比如数据集等,建议您**挂载共享存储卷**,将所有数据存放在存储桶,可以更大限度保护您的数据安全,同时会大大减小镜像体积,减少关机等待时间。
# 产品简介
# 功能概览
## 一、计算资源管理
[Section titled “一、计算资源管理”](#一计算资源管理)
### 1. GPU 独占功能
[Section titled “1. GPU 独占功能”](#1-gpu-独占功能)
平台支持 GPU 资源独占模式:
* **物理级独占**:整张 GPU 卡(含显存)由用户独享,无虚拟化层损耗
* **多种高端 GPU 可选**:RTX 4090、H20、L20、L40、H800 等卡型,满足不同规模与场景的算力需求
* **无需担心设备短缺**:随时获得所需资源,保障 AI 开发与训练的连续性
* **性能稳定可靠**:所有镜像均在真实 GPU 环境下严格验证,适配高强度计算任务
适用于对计算稳定性要求极高的 AI 模型训练、大模型微调等场景。
## 二、存储与数据访问
[Section titled “二、存储与数据访问”](#二存储与数据访问)
### 1. 对象存储加速挂载
[Section titled “1. 对象存储加速挂载”](#1-对象存储加速挂载)
平台支持对象存储的加速挂载能力:
* **共享存储卷挂载**:将共享存储以挂载方式接入运行环境
* **提升数据访问效率**:简化大模型文件、数据集读取流程,避免重复下载
* **数据安全可靠**:确保数据永不丢失,支持训练数据的持久化保存
* **多机共享访问**:分布式训练场景下,多节点可同时访问同一数据源
适用于需要频繁访问大规模训练数据(10GB+)的 AI 模型开发场景。
### 2. 共享存储卷挂载
[Section titled “2. 共享存储卷挂载”](#2-共享存储卷挂载)
支持共享存储卷挂载:
* **多实例数据协同**:多个 GPU 实例可共享同一存储卷,实现数据集统一管理与访问
* **Checkpoint 持久化**:训练过程中的模型权重、日志实时写入共享存储,防止实例释放数据丢失
* **支持分布式任务的数据协同**:多机分布式训练时,各节点共享读取训练数据,写入结果至统一存储
* **极速发布与分发**:镜像与数据一键分发至多个环境,提升部署效率
适用于分布式深度学习、大规模模型微调等需要数据共享与协同处理的场景。
## 三、镜像与环境管理
[Section titled “三、镜像与环境管理”](#三镜像与环境管理)
### 1. 完整开发工具链
[Section titled “1. 完整开发工具链”](#1-完整开发工具链)
* **预装 30 余款开发工具**:涵盖 Jupyter Lab、VS Code Server、Web Shell 等,开发环境一键就绪
* **主流 AI 框架支持**:PyTorch、TensorFlow 全家桶等预装配置,免去环境配置烦恼
* **镜像版本管理**:支持镜像版本控制,便于环境复现与 A/B 测试
* **自定义启动命令**:支持 supervisord 进程管理,灵活配置服务启动流程
### 2. 极速部署与验证
[Section titled “2. 极速部署与验证”](#2-极速部署与验证)
* **镜像严格验证**:所有镜像均在真实 GPU 环境下测试,确保性能稳定
* **一键发布上线**:开发完成后可一键发布为 Serverless 在线服务
* **多环境分发**:支持镜像快速复制至不同区域或集群,保障业务连续性
# 产品优势
## 一、算力资源优势
[Section titled “一、算力资源优势”](#一算力资源优势)
### 1. GPU 资源丰富度
[Section titled “1. GPU 资源丰富度”](#1-gpu-资源丰富度)
* **全系列高端 GPU 覆盖**:RTX 4090、H20、L20、L40、H800 等多种卡型可选,从单卡推理到 8 卡训练集群无缝扩展
* **资源保障机制**:无需担心设备短缺,平台库存充足,随时获得所需算力,保障 AI 开发与训练连续性
* **真实环境验证**:所有 GPU 实例均在真实硬件环境下严格测试,性能稳定可靠,适配高强度计算任务
### 2. 极致性能体验
[Section titled “2. 极致性能体验”](#2-极致性能体验)
* **物理级 GPU 独占**:整卡独占模式,无虚拟化损耗,CUDA 核心 100% 可用
* **极速启动能力**:几分钟内完成环境启动,无需繁琐配置,开箱即用
* **多卡互联优化**:支持单机多卡训练与多机分布式训练,满足大规模模型微调与训练需求
## 二、开发效率优势
[Section titled “二、开发效率优势”](#二开发效率优势)
### 1. 完整工具链预装
[Section titled “1. 完整工具链预装”](#1-完整工具链预装)
* **30 余款开发工具集成**:Jupyter Lab、VS Code Server、Web Shell 等 IDE 一键就绪
* **主流框架全家桶**:PyTorch、TensorFlow 等 AI 框架预装配置,免去环境搭建烦恼
* **进程管理灵活**:支持自定义启动命令与 supervisord 进程管理,灵活配置服务启动流程
### 2. 镜像与版本管理
[Section titled “2. 镜像与版本管理”](#2-镜像与版本管理)
* **镜像版本控制**:支持镜像历史版本管理,便于环境复现与回滚
* **极速发布上线**:开发完成后一键发布为 Serverless 在线服务
* **多环境一键分发**:镜像快速复制至多个区域或集群,提升部署效率
## 三、成本与灵活性优势
[Section titled “三、成本与灵活性优势”](#三成本与灵活性优势)
### 1. 弹性计费模式
[Section titled “1. 弹性计费模式”](#1-弹性计费模式)
* **按需付费**:弹性计费模式,用多少付多少,极大降低使用门槛
* **免费开关机**:开关机过程完全免费,无论操作多少次都不产生额外费用,仅为实际使用时间付费
* **资源利用率最大化**:支持弹性资源调度,按需分配计算资源,避免闲置浪费
### 2. 灵活扩缩容
[Section titled “2. 灵活扩缩容”](#2-灵活扩缩容)
* **手动即时调整**:通过控制台或 API 随时调整实例规格与数量
* **自动负载感知**:根据 GPU 利用率自动扩缩容,保障性能同时优化成本
* **规格无缝切换**:支持不同 GPU 卡型间灵活切换,适配多样化任务需求
## 四、数据与运维优势
[Section titled “四、数据与运维优势”](#四数据与运维优势)
### 1. 企业级数据安全
[Section titled “1. 企业级数据安全”](#1-企业级数据安全)
* **共享存储卷机制**:数据持久化保存,永不丢失
* **多节点数据协同**:支持分布式训练场景下的数据共享与统一访问
* **传输与存储加密**:保障数据在传输和存储过程中的安全性
### 2. 专业运维支持
[Section titled “2. 专业运维支持”](#2-专业运维支持)
* **全天候技术团队**:7×24 小时专业支持,保障用户无忧使用
* **运维工具集成**:内置 SSH、Bash、Screen 等工具,管理便捷高效
* **知识产权防护**:支持大规模镜像分发时的权限管控,保障教学与研发资产安全
## 五、场景适配优势
[Section titled “五、场景适配优势”](#五场景适配优势)
| | | |
| ---------- | ------------ | -------------- |
| 优势维度 | 核心价值 | 典型受益场景 |
| **算力即取即用** | 消除资源等待,分钟级启动 | 算法竞赛、紧急实验 |
| **环境一致性** | 镜像快速复现,结果可重现 | 科研实验、论文复现 |
| **成本可控** | 零闲置费用,开关机免费 | 教学培训、间歇性训练 |
| **弹性扩展** | 单机↔分布式无缝切换 | 大模型训练、生产部署 |
| **全托管服务** | 免运维,专注核心业务 | AI 应用上线、MVP 验证 |
# 应用场景
## 一、AI 模型开发与训练
[Section titled “一、AI 模型开发与训练”](#一ai-模型开发与训练)
### 核心场景
[Section titled “核心场景”](#核心场景)
* **大模型预训练与微调**:利用 H800/H20 多卡集群进行 LLM 全参数训练或 LoRA 微调
* **CV/NLP 模型迭代**:RTX 4090/L40 单卡/多卡环境快速验证新算法
* **分布式训练扩展**:单机多卡(8×A800)或多机集群(64 卡+)支撑百亿参数模型训练
### 价值体现
[Section titled “价值体现”](#价值体现)
| | |
| ------------ | ---------------------- |
| 痛点 | 解决方案 |
| 本地算力不足,训练周期长 | 弹性获取 8 卡集群,训练速度提升 8 倍+ |
| 环境配置复杂,复现困难 | 预装框架镜像,一键启动一致环境 |
## 二、算法竞赛与科研实验
[Section titled “二、算法竞赛与科研实验”](#二算法竞赛与科研实验)
### 核心场景
[Section titled “核心场景”](#核心场景-1)
* **Kaggle/天池等竞赛**:快速启动竞赛指定环境,支持 PyTorch/TensorFlow 灵活切换
* **论文实验复现**:镜像版本管理确保环境可复现,结果可回溯
* **跨团队协作**:共享存储卷实现数据集与代码团队共享,避免重复上传
### 价值体现
[Section titled “价值体现”](#价值体现-1)
| | |
| --------------- | ------------------- |
| 痛点 | 解决方案 |
| 竞赛时间窗口紧,环境搭建耗时长 | 分钟级启动,预装竞赛常用库 |
| 实验环境碎片化,结果不可复现 | 镜像快照保存,随时回滚至关键节点 |
| 算力成本敏感,预算有限 | 免费开关机 + 按小时计费,零闲置费用 |
## 三、AI 应用上线与服务部署
[Section titled “三、AI 应用上线与服务部署”](#三ai-应用上线与服务部署)
### 核心场景
[Section titled “核心场景”](#核心场景-2)
* **模型推理服务化**:训练完成的模型一键发布为 Serverless API 服务
* **AIGC 内容生成平台**:基于 L20/L40 构建文生图、文生视频在线服务
* **业务高峰应对**:自动扩缩容应对流量波动,保障服务可用性
### 价值体现
[Section titled “价值体现”](#价值体现-2)
| | |
| ------------- | ----------------- |
| 痛点 | 解决方案 |
| 训练到部署链路断裂 | 训练镜像直接转生产镜像,无缝上线 |
| 流量波动导致资源浪费或不足 | 自动扩缩容,无请求时缩容至零成本 |
| 多环境部署一致性差 | 镜像一键分发至多区域,版本统一管控 |
## 四、AI 教育与培训
[Section titled “四、AI 教育与培训”](#四ai-教育与培训)
### 核心场景
[Section titled “核心场景”](#核心场景-3)
* **高校 AI 课程实训**:批量分发统一镜像,保障数百学生环境一致
* **企业内训与认证**:自定义镜像预装企业专属工具链与数据集
* **在线编程实验**:Jupyter Lab + Web Shell 支持浏览器端免配置实验
### 价值体现
[Section titled “价值体现”](#价值体现-3)
| | |
| --------------- | --------------- |
| 痛点 | 解决方案 |
| 学生设备性能参差,实验效果不一 | 云端统一高性能环境,结果可复现 |
| 教学镜像盗版泄露风险 | 镜像权限管控,仅授权学员可见 |
| 课程结束后资源闲置浪费 | 课程结束自动释放,按学期付费 |
## 五、图形渲染与视觉计算
[Section titled “五、图形渲染与视觉计算”](#五图形渲染与视觉计算)
### 核心场景
[Section titled “核心场景”](#核心场景-4)
* **3D 影视特效渲染**:RTX 4090 集群加速 Maya/Blender/Houdini 渲染
* **建筑可视化(BIM)**:L40 大显存支持复杂场景实时渲染
* **云游戏串流**:GPU 直通 + 低延迟网络,支持云端游戏画面编码推流
### 价值体现
[Section titled “价值体现”](#价值体现-4)
| | |
| -------------- | ------------------- |
| 痛点 | 解决方案 |
| 本地渲染农场投资大、利用率低 | 按需租用,项目结束立即释放 |
| 渲染节点管理复杂 | 内置队列调度,自动分配空闲 GPU |
| 大场景显存不足崩溃 | 48GB 大显存实例,支持超大规模场景 |
## 六、科学计算与仿真模拟
[Section titled “六、科学计算与仿真模拟”](#六科学计算与仿真模拟)
### 核心场景
[Section titled “核心场景”](#核心场景-5)
* **分子动力学模拟**:GROMACS/NAMD 等软件 GPU 加速
* **气象与流体力学**:WRF、OpenFOAM 等并行计算
* **金融量化回测**:大规模历史数据并行计算与策略验证
### 价值体现
[Section titled “价值体现”](#价值体现-5)
| | |
| -------------- | ---------------------- |
| 痛点 | 解决方案 |
| 传统 CPU 集群计算速度慢 | GPU 加速,模拟速度提升 10-100 倍 |
| 软件许可证与硬件绑定 | 云端许可证服务器,灵活调度资源 |
| 突发大算力需求难满足 | 分钟级扩展至数百 GPU,任务完成即释放 |
# 什么是云主机
## **产品概述**
[Section titled “产品概述”](#产品概述)
共绩科技云主机是一款面向 AI 开发者、科研团队及企业用户的高性能 GPU 算力服务,致力于为用户提供丰富的 GPU 资源选择、极速部署体验和企业级服务保障,助力 AI 创新与高效开发。
## **技术特性 & 核心优势**
[Section titled “技术特性 & 核心优势”](#技术特性--核心优势)
### 丰富的 GPU 资源
[Section titled “丰富的 GPU 资源”](#丰富的-gpu-资源)
* 多种高端 GPU 卡型可选,包括 RTX 4090、H20、L20、L40、H800 等,满足不同规模与场景的算力需求。
* 无需担心设备短缺,随时获得所需资源,保障 AI 开发与训练的连续性。
### 极速启动与高性能环境
[Section titled “极速启动与高性能环境”](#极速启动与高性能环境)
* 几分钟内即可启动 AI 开发环境,无需繁琐配置,开箱即用。
* 所有镜像均在真实 GPU 环境下严格验证,性能稳定可靠,适配高强度计算任务。
## 完整开发工具链
[Section titled “完整开发工具链”](#完整开发工具链)
* 预装 30 余款开发工具,涵盖 Jupyter Lab、VS Code Server、Web Shell 等,开发环境一键就绪。
* 支持主流 AI 框架(如 PyTorch、TensorFlow 全家桶),免去环境配置烦恼。
### 灵活计费与高效资源调度
[Section titled “灵活计费与高效资源调度”](#灵活计费与高效资源调度)
* 弹性计费模式,按需付费,用多少付多少,极大降低使用门槛。
* 支持弹性资源调度,按需分配计算资源,提升资源利用率。
### 镜像与环境管理
[Section titled “镜像与环境管理”](#镜像与环境管理)
* 支持镜像版本管理,极速发布上线,一键分发至多个环境,提升部署效率。
* 支持自定义启动命令与 supervisord 进程管理,灵活配置服务启动流程。
### 数据与存储安全
[Section titled “数据与存储安全”](#数据与存储安全)
* 支持挂载共享存储卷,基于 K8s PVC 机制,确保数据安全可靠,数据永不丢失。
### 专业技术支持与运维保障
[Section titled “专业技术支持与运维保障”](#专业技术支持与运维保障)
* 全天候专业团队支持,保障用户无忧使用。
* 集成 SSH、Bash、Screen 等运维工具,管理便捷高效。
### 免费开关机体验
[Section titled “免费开关机体验”](#免费开关机体验)
* 开关机过程完全免费,无论操作多少次都不产生额外费用,仅为实际使用时间付费。
* 支持单机多卡训练和多机分布式训练,满足大规模模型微调与训练需求。
## **典型应用场景**
[Section titled “典型应用场景”](#典型应用场景)
### AI 模型开发与训练
[Section titled “AI 模型开发与训练”](#ai-模型开发与训练)
一键启动高性能开发环境,支持单机多卡与多机分布式训练,满足从实验到生产的多样化需求。
### 算法竞赛与科研实验
[Section titled “算法竞赛与科研实验”](#算法竞赛与科研实验)
弹性算力资源,灵活计费,支持镜像快速切换与环境复现,提升实验效率。
### AI 应用上线与服务部署
[Section titled “AI 应用上线与服务部署”](#ai-应用上线与服务部署)
开发完成后可一键发布为 Serverless 在线服务,结合高效镜像管理与弹性调度,轻松应对业务高峰。
### AI 教育与培训
[Section titled “AI 教育与培训”](#ai-教育与培训)
支持大规模镜像分发与统一管理,保障教学效率与知识产权安全。
# 快速入门
# 快速上手云主机服务
## 一、创建云主机
[Section titled “一、创建云主机”](#一创建云主机)
## 1.1 进入云主机控制台
[Section titled “1.1 进入云主机控制台”](#11-进入云主机控制台)
访问控制台并进入云主机页面: **
点击顶部【云主机】 → 进入云主机管理界面 → 选择可用设备资源

## 1.2 GPU 设备选择逻辑
[Section titled “1.2 GPU 设备选择逻辑”](#12-gpu-设备选择逻辑)
当前图片中所有 GPU 型号均满足基础部署需求:
### 显存层面
[Section titled “显存层面”](#显存层面)
* 单卡显存 ≥ 24GB
* 已远超大多数服务部署、推理任务、数据处理需求
* 无需担心显存不足问题
### 性价比层面
[Section titled “性价比层面”](#性价比层面)
* 1 卡配置:低成本、按秒计费、适合开发/测试/推理
* 多卡配置:适用于训练任务、高并发、多模型场景
### 实际选择策略
[Section titled “实际选择策略”](#实际选择策略)
* 常规任务(推理、服务部署、数据处理):**1 卡足够**
* 训练任务(LLM、多模态、大模型):再考虑 2 卡 / 4 卡
**结论:** 如果没有明确的大模型训练需求,直接选择 1 卡配置即可,开箱即用、成本可控、无需纠结型号差异。
## 二、选择基础镜像
[Section titled “二、选择基础镜像”](#二选择基础镜像)
选择平台预制基础镜像即可快速获得完整运行环境。

说明:
* 平台已提供完整适配环境
* 无需手动安装 CUDA、驱动、深度学习框架
* 环境一致性强,适合迁移与部署
## 三、查看运行状态
[Section titled “三、查看运行状态”](#三查看运行状态)
实例创建完成后,可在云主机列表查看运行状态:

状态说明:
* 运行中:可直接连接使用
* 创建中:等待资源初始化
* 停止:可重新启动
# (产品)DockerWeb
# 快速上手
# 镜像仓库
我们提供免费的 Docker 镜像仓库服务,方便您管理 Docker 镜像。
镜像仓库的账号密码和用户的账号密码不互通。
## 步骤 1: 登录共绩算力镜像站
[Section titled “步骤 1: 登录共绩算力镜像站”](#步骤-1-登录共绩算力镜像站)
1. 访问控制台的 *镜像仓库* 页面
2. 点击”访问凭据”
3. 按照页面上的登录指引操作(运行命令->输入密码)

登录成功后,您将看到 `Login Succeeded` 的提示信息。
## 步骤 2: 为镜像添加标签
[Section titled “步骤 2: 为镜像添加标签”](#步骤-2-为镜像添加标签)
在推送镜像之前,应当添加包含共绩算力镜像站地址的 tag。
例如,对于本地镜像 `my-image`:
```shell
docker tag my-image harbor.suanleme.cn//my-image:my-tag
```
注意:
* 将 `` 替换为您的仓库账号(可在”镜像仓库 > 访问凭证”中查看)
* `my-image` 是您的镜像名称
* `my-tag` 是镜像标签(如 “v1.0”)
## 步骤 3: 推送镜像
[Section titled “步骤 3: 推送镜像”](#步骤-3-推送镜像)
标签添加完成后,使用以下命令推送镜像:
```shell
docker push harbor.suanleme.cn//my-image:my-tag
```
在推送过程中,会显示上传进度。当推送成功后,可以在“镜像仓库”页面查看该镜像。如果镜像过大,那么推送所需时间可能会比较长。

# 3 步上手
📢
前提条件:请先在 **共绩算力控制台** 完成注册和登录
## 1 准备 compose 文件
[Section titled “1 准备 compose 文件”](#1-准备-compose-文件)
以下是一个完整且可用的 docker-compose.yml 示例文件。您可直接复制以作第二步使用,无需进行任何修改:
```yaml
services:
# CPU 版 FFmpeg API 服务定义
ffmpeg-api-cpu:
image: harbor.suanleme.cn/library/ffmpeg-api:cpu # 使用的 Docker 镜像,当前镜像是在公共仓库中
restart: always
network_mode: bridge # 使用桥接网络模式
# 自定义标签用于服务标识
labels:
- suanleme_0.http.port=8000 # CPU API 的 HTTP 端口
- suanleme_0.http.prefix=cpuapi # CPU API 的 URL 前缀
# GPU 版 FFmpeg API 服务定义
ffmpeg-api-gpu:
image: harbor.suanleme.cn/library/ffmpeg-api:gpu # 使用的 Docker 镜像,当前镜像是在公共仓库中
restart: always
network_mode: bridge # 使用桥接网络模式
# 自定义标签用于服务标识
labels:
- suanleme_0.http.port=8000 # GPU API 的 HTTP 端口
- suanleme_0.http.prefix=gpuapi # GPU API 的 URL 前缀
# 部署配置,分配 GPU 资源
deploy:
resources:
reservations:
devices:
- driver: nvidia # 使用 NVIDIA GPU 驱动
count: 1 # 预留的 GPU 数量
capabilities: [ gpu ] # 指定 GPU 功能
```
您可依据实际需求进行修改,不过在当前教程里无需对任何内容进行改动。各参数的说明已在注释中予以注明。倘若模型镜像未包含在共绩算力的镜像站当中,则需自行将其上传至共绩算力的镜像仓库之中。
## 2 发布任务
[Section titled “2 发布任务”](#2-发布任务)
### 2.1 登录 *控制台*
[Section titled “2.1 登录 控制台”](#21-登录-控制台)
### 2.2 新建任务
[Section titled “2.2 新建任务”](#22-新建任务)
点击左上角”新建” → “新建 Docker 任务”
如果遭遇仓库初始化的弹窗,那么需填写仓库信息,接着在当前教程中持续进行操作。后续操作完全无需关注镜像仓库的问题。
### 2.3 填写任务信息
[Section titled “2.3 填写任务信息”](#23-填写任务信息)
粘贴步骤 1 中复制的 Docker Compose 内容。
域名前缀避免与 Docker Compose 中的 labels 名称相同
Docker Compose 中的镜像 tag 避免使用 latest
```yaml
例:任务名称尽量与- suanleme_0.http.prefix=gpuapi 不同
labels:
- suanleme_0.http.port=8000
- suanleme_0.http.prefix=gpuapi
```
当前任务没有 CUDA 版本和显卡型号限制,节点数建议大于 3。填写完信息后点击“部署服务”
当前任务的健康检查配置使用默认值,点击“保存配置”
📢
放心,我们会根据您发布任务的任务点数来分配任务的冗余节点,以保证服务的稳定性。
## 3 查看运行状态
[Section titled “3 查看运行状态”](#3-查看运行状态)
发布任务后会自动跳转到任务详情,等待节点分配
节点分配完成后,服务就可以正常访问。点击服务回传中的第一个链接,我们访问 ffmpeg 的 CPU 服务。
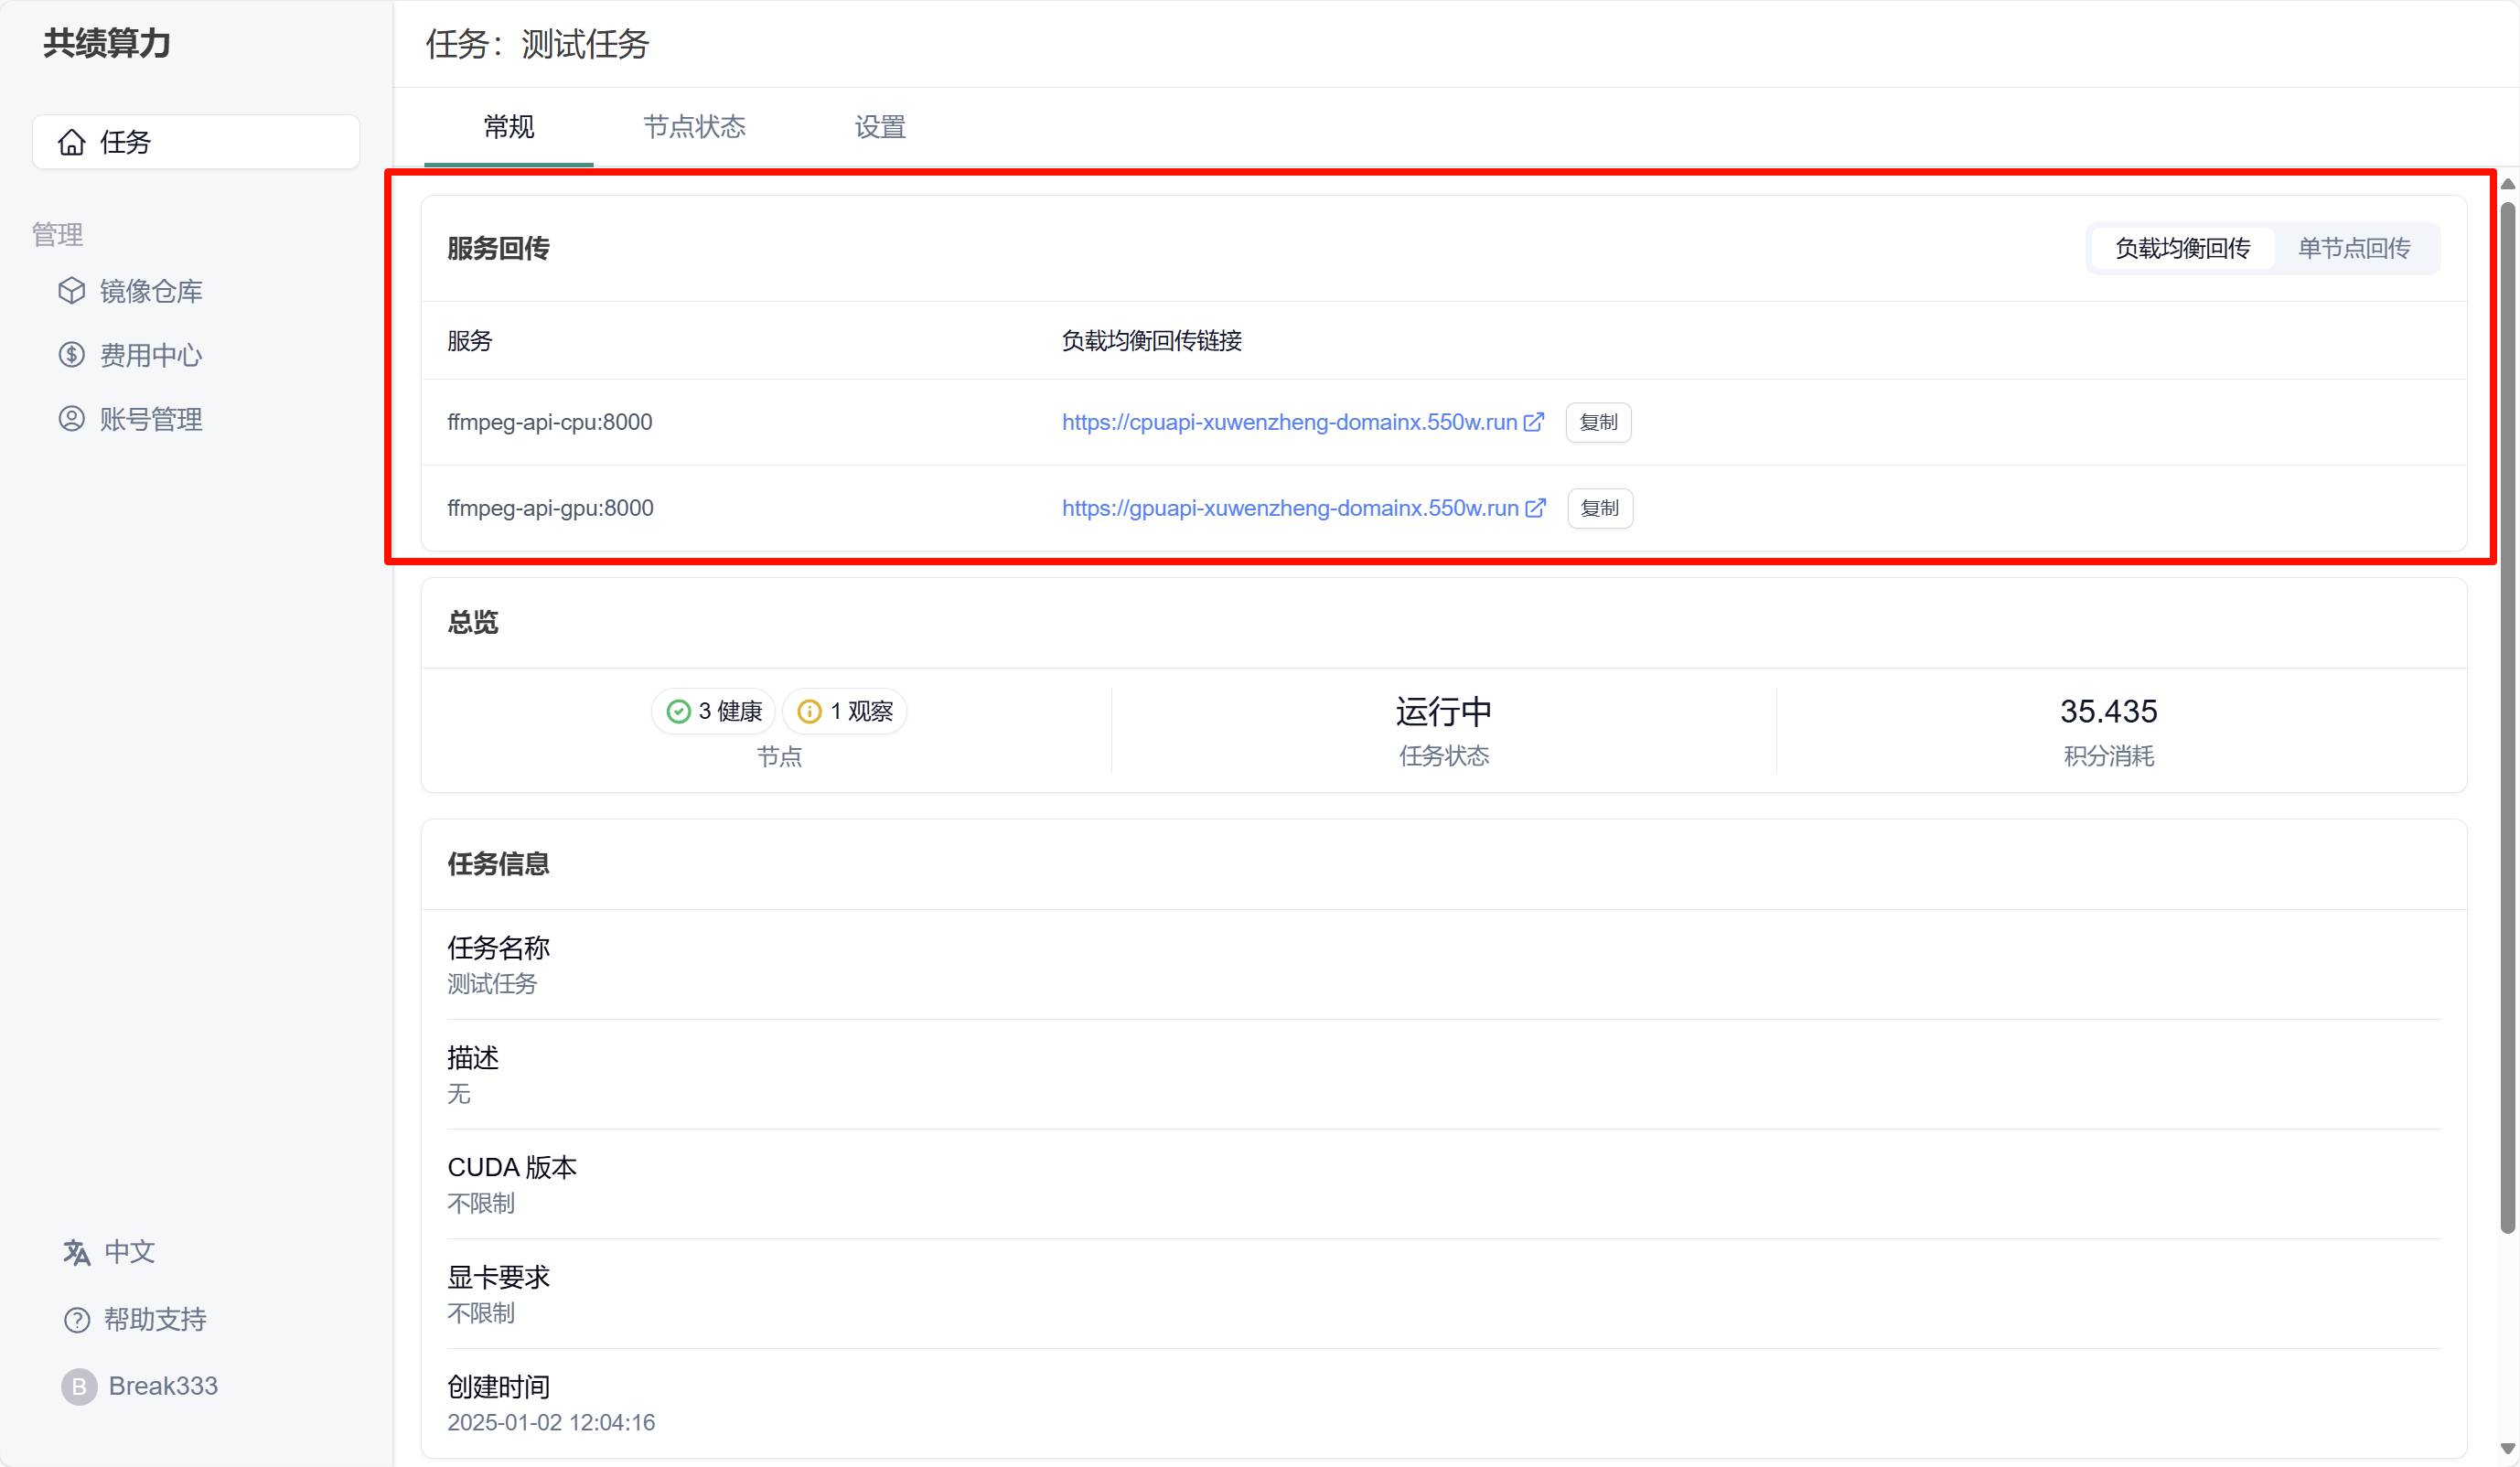
服务运行效果:
测试视频下载:
📢
恭喜您顺利完成首个部署于**分布式弹性算力平台**的任务!
# Docker Compose 指南
我们的 Docker Compose 在很大程度上与官方版本保持一致。然而,也存在部分差异之处。为了确保您的 docker-compose 文件能够与共绩算力服务相适配,请依照以下指南进行操作。
## 指定镜像源
[Section titled “指定镜像源”](#指定镜像源)
如果您已经上传了镜像到共绩算力镜像源并需要使用它作为服务,请在 `image` 字段中以 `harbor.suanleme.cn` 开头,后面跟上仓库名(改为自己的)和镜像名,例如:
```yaml
image: harbor.suanleme.cn//my-image:my-tag
```
注意:
* 将 `` 替换为您的仓库账号(可在”镜像仓库 > 访问凭证”中查看)
* `my-image` 是您的镜像名称
* `my-tag` 是镜像标签(如 “v1”)
网络模式设置:服务的 `network_mode` 需要设置为 `bridge`。
```yaml
network_mode: bridge
```
## 端口转发设置
[Section titled “端口转发设置”](#端口转发设置)
对于需进行转发的端口及其域名前缀,应当在服务的 labels 中的 suanleme\_n.http.port 以及 suanleme\_n.http.prefix 字段予以指定。
其中,n 表示此转发端口的序号,n 从 0 起始。倘若存在多个端口需转发,则依序使用 suanleme\_n 标签,例如 suanleme\_0、suanleme\_1、suanleme\_2。
每一个 http.port 标签均需对应一个 http.prefix 标签,其作用在于告知服务器将前往 http.port 标签中端口的请求解析至 http.prefix-用户前缀 - 任务前缀。
📢
prefix 必须为 4 - 16 位,且仅能是以小写字母开头的小写字母与数字的组合格式
以下为一个示例:
```yaml
labels:
- suanleme_0.http.port=8080
- suanleme_0.http.prefix=gj8080
- suanleme_1.http.port=8081
- suanleme_1.http.prefix=gj8081
- suanleme_2.http.port=8082
- suanleme_2.http.prefix=gj8082
- suanleme_3.http.port=8083
- suanleme_3.http.prefix=gj8083
```
## 不支持 volumes
[Section titled “不支持 volumes”](#不支持-volumes)
鉴于我们提供的为弹性服务,弹性服务由多台机器共同提供统一算力服务。弹性服务的首要特性表现为无状态。基于此,我们不支持 volumes 功能。
在弹性场景下,最佳实践是把模型等资源整合进 Docker 镜像中。
## 其它配置
[Section titled “其它配置”](#其它配置)
docker-compose 的其余部分可以根据应用的具体需求进行自定义配置。
以下是一个完整的 docker-compose 示例文件,展示了如何配置一个符合共绩算力要求的服务:
```yaml
services:
# CPU 版 FFmpeg API 服务定义
ffmpeg-api-cpu:
image: harbor.suanleme.cn/library/ffmpeg-api:cpu # 使用的 Docker 镜像,当前镜像是在公共仓库中
restart: always
network_mode: bridge # 使用桥接网络模式
# 自定义标签用于服务标识
labels:
- suanleme_0.http.port=8000 # CPU API 的 HTTP 端口
- suanleme_0.http.prefix=cpuapi # CPU API 的 URL 前缀
# GPU 版 FFmpeg API 服务定义
ffmpeg-api-gpu:
image: harbor.suanleme.cn/library/ffmpeg-api:gpu # 使用的 Docker 镜像,当前镜像是在公共仓库中
restart: always
network_mode: bridge # 使用桥接网络模式
# 自定义标签用于服务标识
labels:
- suanleme_0.http.port=8000 # GPU API 的 HTTP 端口
- suanleme_0.http.prefix=gpuapi # GPU API 的 URL 前缀
# 部署配置,分配 GPU 资源
deploy:
resources:
reservations:
devices:
- driver: nvidia # 使用 NVIDIA GPU 驱动
count: 1 # 预留的 GPU 数量
capabilities: [ gpu ] # 指定 GPU 功能
```
📢
该文件仅用于演示目的,请根据具体需求编写自己的 docker-compose 文件
# 怎么用
# 容器化部署 ComfyUI
本指南详细阐述了将 ComfyUI 封装成 API 并使其能够直接在 Docker 容器环境中运行的方法,同时也介绍了如何在 共绩算力 上运用 ComfyUI 部署包含自定义的 stable diffusion 模型的工作流。
## 开源案例
[Section titled “开源案例”](#开源案例)
我们基于本教程开源了一套前后端分离的 Comfy UI 服务。
具有完整的 Docker\&Serverless 化部署方案,您可以参考使用。
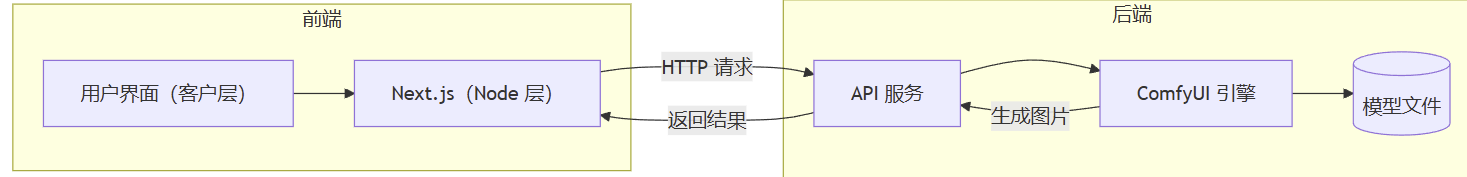
本教程对应开源库中的 backend 文件夹
## 整体流程
[Section titled “整体流程”](#整体流程)
无论你选择什么样的 stable diffusion 推理服务、模型或扩展,基本流程如下:
1. 选择 Docker 基础镜像用于构建我们自己的自定义镜像
2. 将所需的模型和扩展复制到 Docker 镜像中
3. 将新镜像推送到容器仓库
4. 将镜像部署为 共绩算力 服务
## **环境要求**
[Section titled “环境要求”](#环境要求)
* Docker
* NVIDIA GPU(当前演示工作流需要 12G 显存以上)
* 足够的磁盘空间(100G\~200G)用于存储模型
## 项目结构
[Section titled “项目结构”](#项目结构)
这是当前项目的完整结构,所有文件、模型、自定义节点等都应该在对应的位置。
```text
.
├── Dockerfile
├── checkpoints
│ └── dreamshaperXL_sfwV2TurboDPMSDE.safetensors
├── controlnet
│ ├── sai_xl_canny_256lora.safetensors
│ └── sai_xl_depth_256lora.safetensors
├── custom_nodes
│ ├── ComfyUI-Custom-Scripts
│ ├── ComfyUI-WD14-Tagger
│ ├── ComfyUI_Comfyroll_CustomNodes
│ ├── comfyui-art-venture
│ └── comfyui_controlnet_aux
├── docker-compose.yml
├── loras
│ └── StudioGhibli.Redmond-StdGBRRedmAF-StudioGhibli.safetensors
├── provisioning.sh // 自定义脚本
└── sanhua.json // 工作流
```
## 选择 Docker 基础镜像
[Section titled “选择 Docker 基础镜像”](#选择-docker-基础镜像)
找到一个 ComfyUI 的 Docker 基础镜像。以下是我们验证过可以在 共绩算力 上运行的镜像,我们将在 Dockfile 里作为基础镜像使用:
* Git 仓库:
* Docker 镜像:[ghcr.io/ai-dock/comfyui:v2-rocm-6.0-runtime-22.04-v0.2.7](http://ghcr.io/ai-dock/comfyui:v2-rocm-6.0-runtime-22.04-v0.2.7)
* 模型目录:`/opt/ComfyUI/models`
* 自定义节点目录:`/opt/ComfyUI/custom_nodes/`
## 下载模型和扩展
[Section titled “下载模型和扩展”](#下载模型和扩展)
* 在我们的示例中,我们将使用下面 4 个模型文件,请自行下载,保存到项目结构中对应目录
*
*
*
*
* 根据项目结构去 Github 搜索名称并下载安装准备对应的 5 个 custom\_nodes
## 创建 Dockerfile
[Section titled “创建 Dockerfile”](#创建-dockerfile)
### 1. 配置 Dockerfile
[Section titled “1. 配置 Dockerfile”](#1-配置-dockerfile)
创建一个名为 `Dockerfile` 的新文件,并在你喜欢的文本编辑器中打开。
此时,你的目录结构应该完整包含所需的文件,包含:
* checkpoints、controlnet、loras 共 3 模型目录,4 个模型文件。
* custom\_nodes 工作流使用的自定义节点
将以下内容复制到你的 Dockerfile 中:
```text
FROM ghcr.io/ai-dock/comfyui:v2-cuda-12.1.1-base-22.04-v0.2.7
ENV WEB_ENABLE_AUTH=false
ENV MODEL_DIR=/opt/ComfyUI/models
COPY checkpoints/dreamshaperXL_sfwV2TurboDPMSDE.safetensors ${MODEL_DIR}/checkpoints/dreamshaperXL_sfwV2TurboDPMSDE.safetensors
COPY controlnet/sai_xl_canny_256lora.safetensors ${MODEL_DIR}/controlnet/sai_xl_canny_256lora.safetensors
COPY controlnet/sai_xl_depth_256lora.safetensors ${MODEL_DIR}/controlnet/sai_xl_depth_256lora.safetensors
COPY loras/StudioGhibli.Redmond-StdGBRRedmAF-StudioGhibli.safetensors ${MODEL_DIR}/loras/StudioGhibli.Redmond-StdGBRRedmAF-StudioGhibli.safetensors
ENV NODE_DIR=/opt/ComfyUI/custom_nodes
COPY custom_nodes/ComfyUI_Comfyroll_CustomNodes ${NODE_DIR}/ComfyUI_Comfyroll_CustomNodes
COPY custom_nodes/comfyui_controlnet_aux ${NODE_DIR}/comfyui_controlnet_aux
COPY custom_nodes/comfyui-art-venture ${NODE_DIR}/comfyui-art-venture
COPY custom_nodes/ComfyUI-Custom-Scripts ${NODE_DIR}/ComfyUI-Custom-Scripts
COPY custom_nodes/ComfyUI-WD14-Tagger ${NODE_DIR}/ComfyUI-WD14-Tagger
COPY provisioning.sh /opt/ai-dock/bin/provisioning.sh
ADD https://github.com/SaladTechnologies/comfyui-api/releases/download/1.6.1/comfyui-api .
RUN chmod +x comfyui-api
COPY sanhua.json .
ENV WARMUP_PROMPT_FILE=sanhua.json
CMD ["./comfyui-api"]
```
📢
注意:我们在镜像中包含了一个简单的包装器 comfyui-api,以便更容易获取生成的图像。
为什么?
ComfyUI 将提示词放入队列中,然后最终将图像保存到本地文件系统。这使得它在像 共绩算力 这样的**弹性无状态环境**中难以使用。comfyui-api 扩展了 ComfyUI 的 `/prompt` API,允许在响应体中接收生成的图像,或将完整的图像提交到提供的 webhook url。
其它特性?
comfyui-api 全面支持 ComfyUI 的/prompt API,能够执行任何 ComfyUI 工作流,并**以无状态 API 设计实现水平扩展以处理更多请求**。它提供 Swagger 文档交互(位于/docs),直接返回 base64 编码图片或通过 webhook 发送完成的图片,接受 base64 编码字符串或图片 URL 提交图片,简化了图像到图像的工作流程。启动时可配置预热工作流以加载模型并准备好接收请求,返回图片格式支持 PNG、JPEG 或 WebP,默认为 PNG。此外,它还提供/health 和/ready 探针检查服务器健康状况和准备情况,动态挂载工作流端点,允许用户自带模型和扩展
### 2. 定义 provisioning.sh
[Section titled “2. 定义 provisioning.sh”](#2-定义-provisioningsh)
在 provisioning.sh 中定义依赖安装脚本。你也可以定义任何内容。
```shell
printf "=========================================================\n"
pip config set global.index-url https://mirrors.tuna.tsinghua.edu.cn/pypi/web/simple
cd /opt/ComfyUI/custom_nodes/comfyui_controlnet_aux
pip install -r requirements.txt
cd /opt/ComfyUI/custom_nodes/ComfyUI-WD14-Tagger
pip install -r requirements.txt
printf "=========================================================\n"
```
### 3. 准备工作流文件(可选)
[Section titled “3. 准备工作流文件(可选)”](#3-准备工作流文件可选)
在 Dockerfile 所在的目录中保存一个 API 格式的 workflow\.json(项目结构中的 sanhua.json)文件。这个文件将用于在启动服务器之前预热服务器。你可以使用 ComfyUI 网页界面创建 workflow,然后以 API 格式保存它。
如果没有,需要修改 Dockerfile 去除相关内容。
## 构建和测试 Docker 镜像
[Section titled “构建和测试 Docker 镜像”](#构建和测试-docker-镜像)
### 1. 构建镜像
[Section titled “1. 构建镜像”](#1-构建镜像)
构建 docker 镜像。你应该根据自己的情况更改指定的版本标签。
```bash
docker build -t gongji/comfyui:0.1 .
```
### 2. 本地测试
[Section titled “2. 本地测试”](#2-本地测试)
在本地运行 docker 镜像以确认它按预期工作:
```bash
docker run -it --rm --gpus all -p 3000:3000 -p 8188:8188 --name comfyui gongji/comfyui:0.1
```
在本地使用时,我们将暴露端口 3000(api 接口)和端口 8188(让我们可以在本地访问 web ui)。
📢
部署到共绩算力(弹性算力平台)后,你的应用程序应该通过 API 与其交互,而不是通过浏览器 web ui。
#### 测试步骤
[Section titled “测试步骤”](#测试步骤)
1. 在浏览器中访问 `http://localhost:8188`。 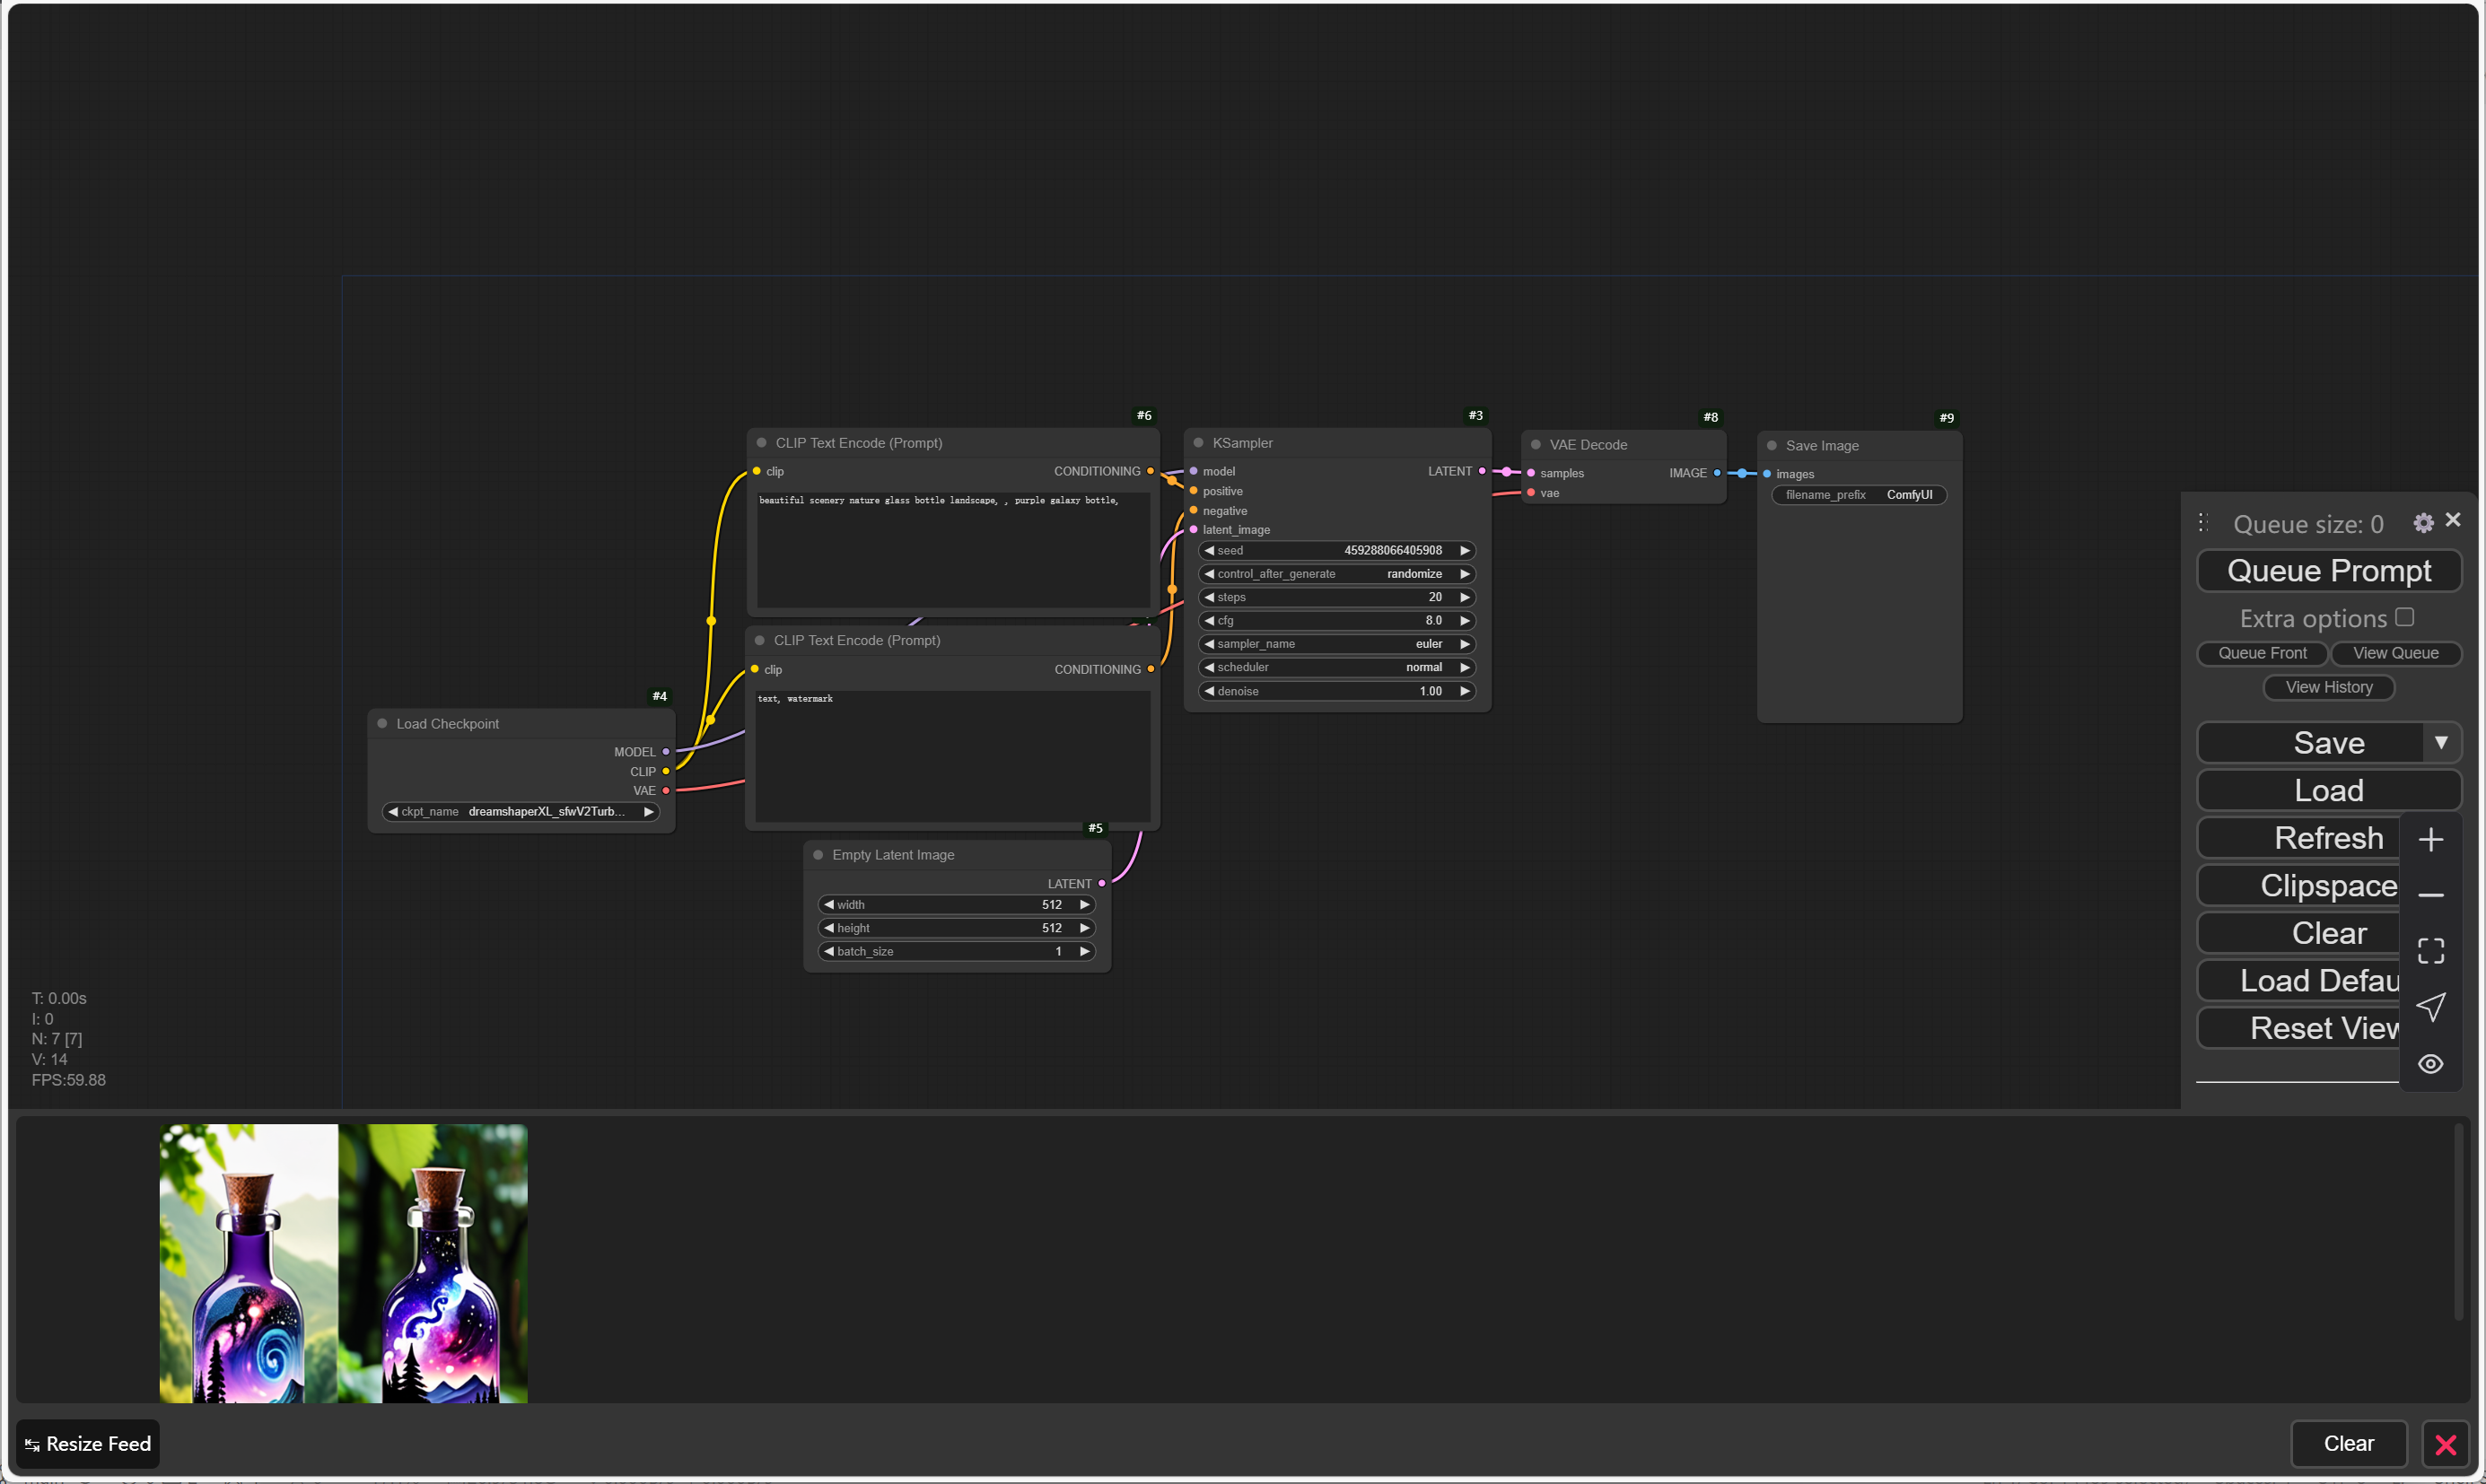
2. 点击 “Queue Prompt” 生成图像。
3. 通过设置菜单启用开发者模式选项。你可以在菜单中看到一个新选项 “Save (API Format) 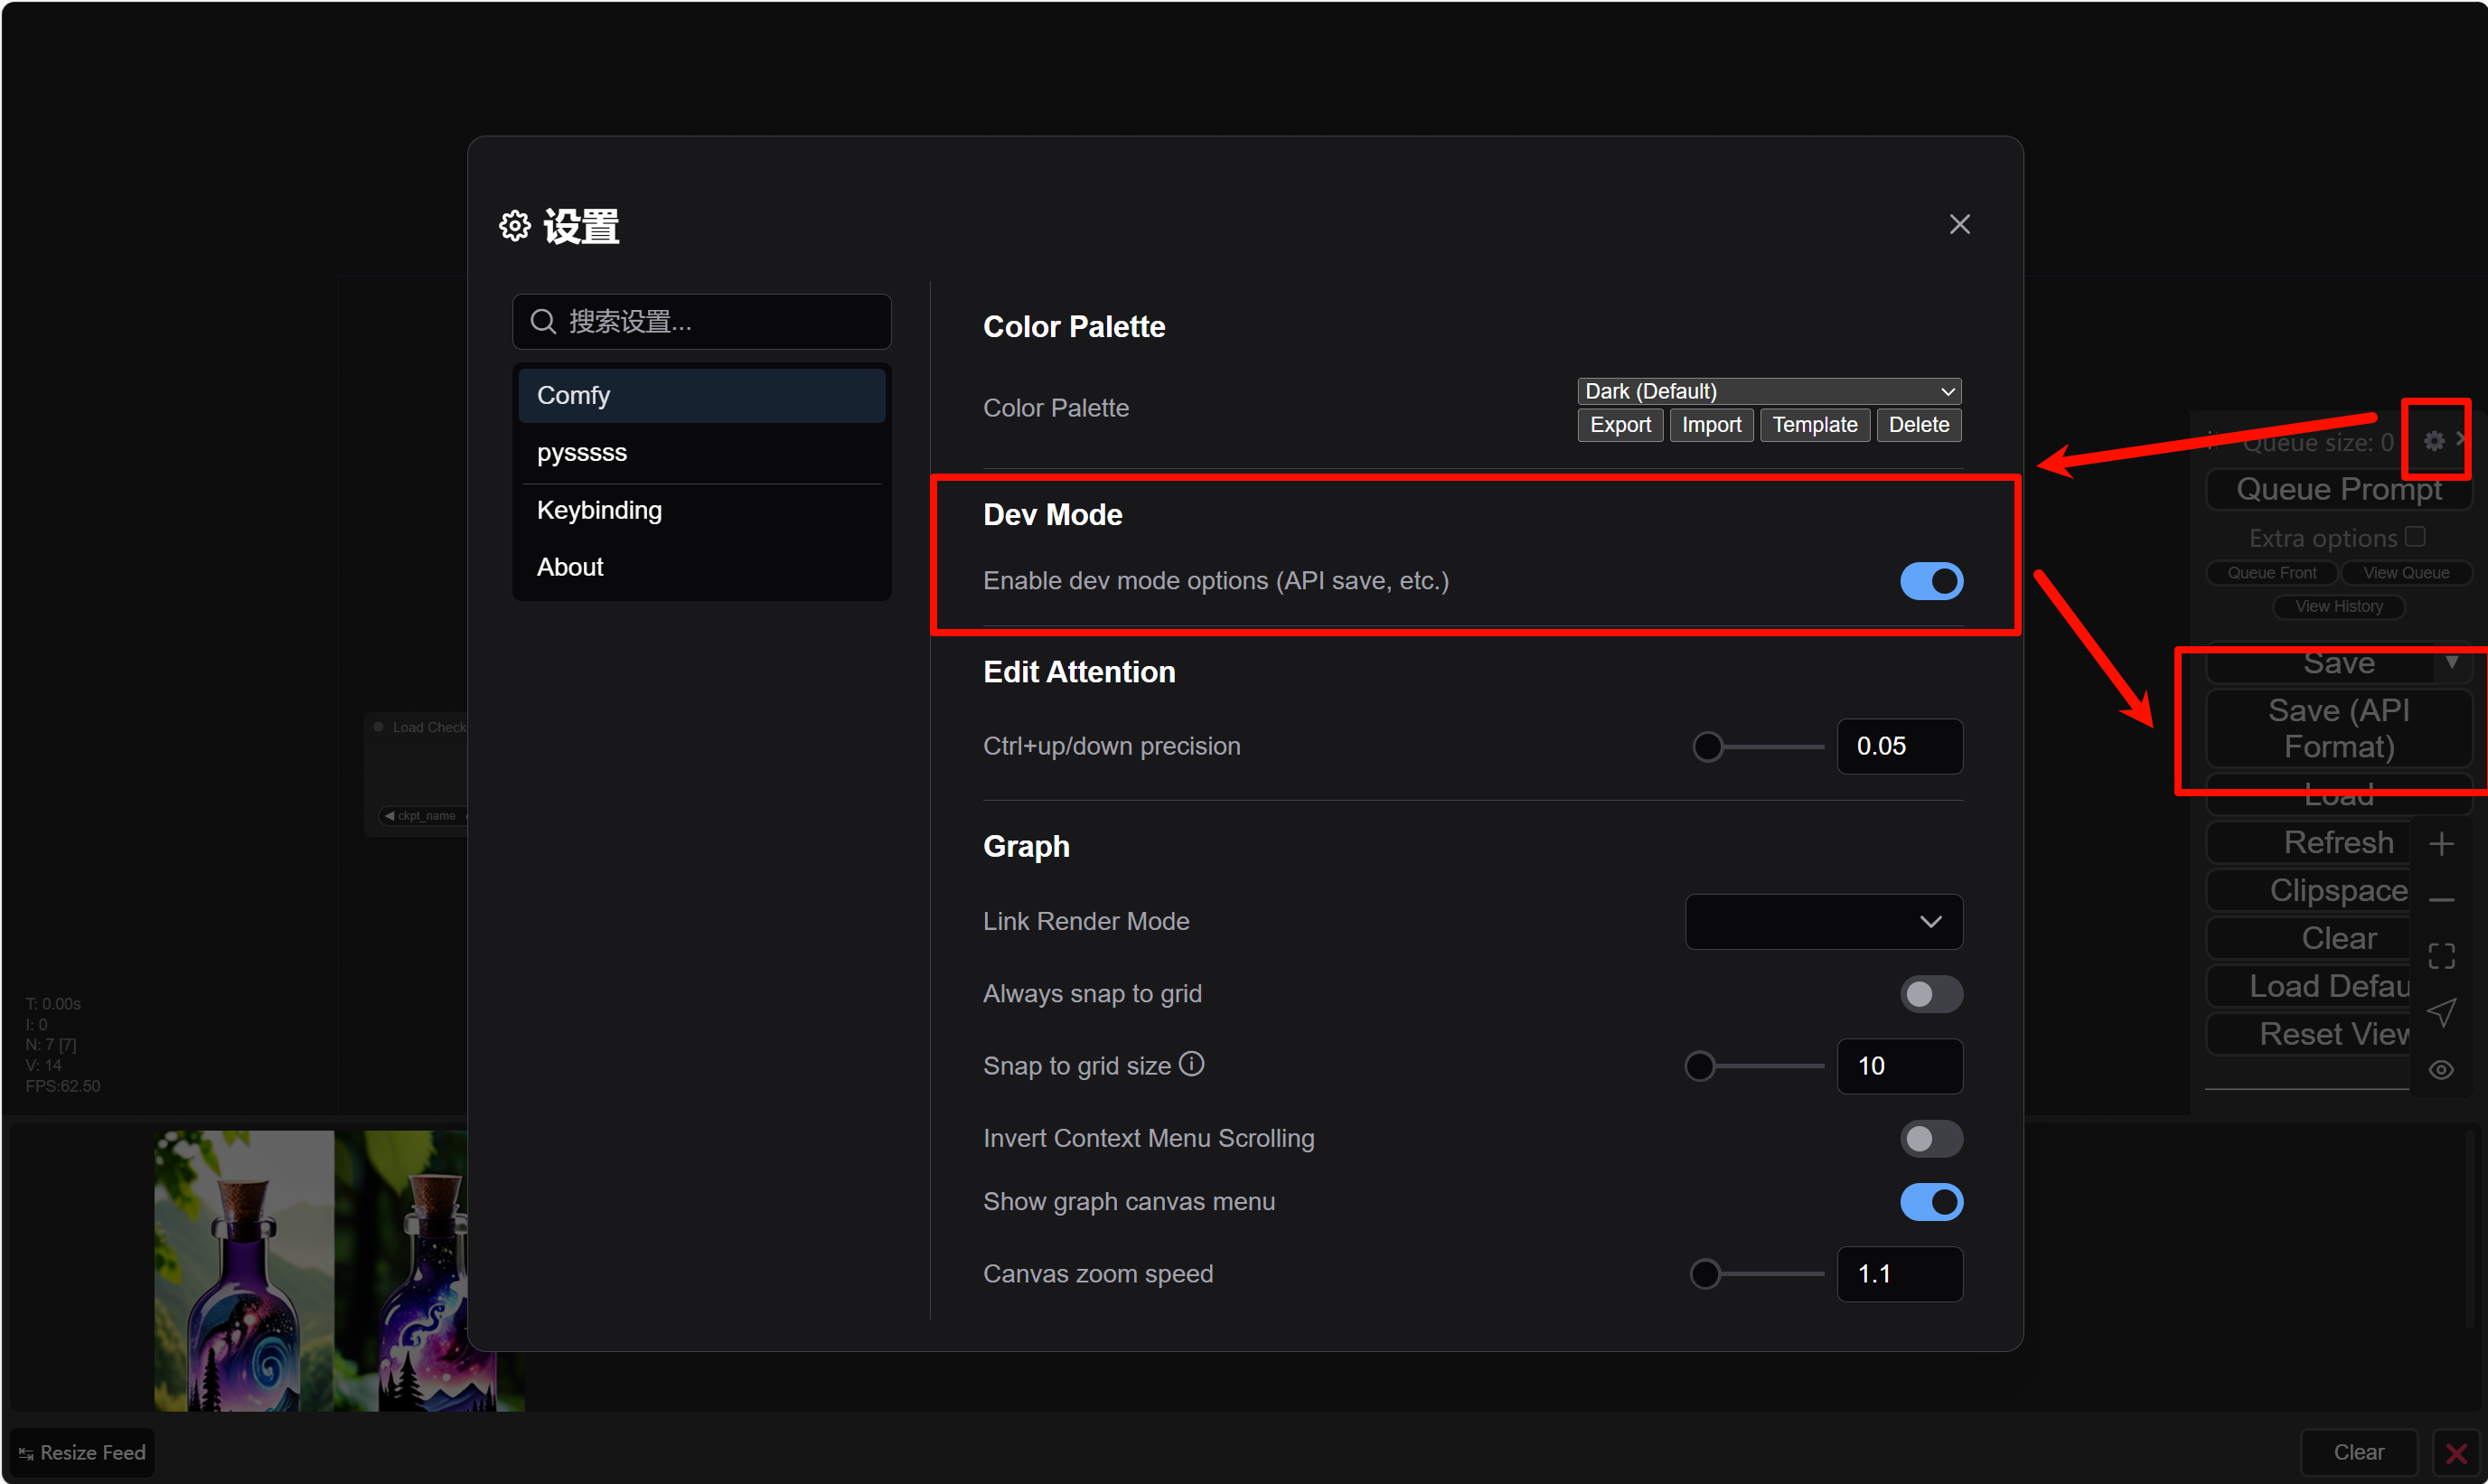
4. 点击 “Save(API Format)” 按钮并保存。你会得到一个名为 `workflow_api.json` 的文件,其中包含 ComfyUI 再次运行该提示所需的所有内容。 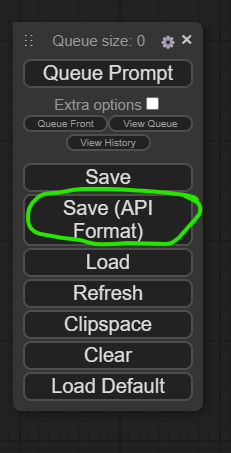
注意:你可能注意到这种提示格式不太直观,但它确实包含了 ComfyUI 使用的节点和连接。根据经验,ComfyUI web ui 是设计提示的最佳方式,而不是试图从头开始创建这样的工作流 json 文件。
### 3. API 测试
[Section titled “3. API 测试”](#3-api-测试)
使用 Postman 或任何你选择的 http 请求工具,将 prompt 提交到端口 3000 上的 API 接口。
你可以通过 `http://localhost:3000/docs`
向 `http://localhost:3000/prompt` 发送 POST 请求,JSON 请求体如下。其中“prompt”的值是我们之前创建的 `workflow_api.json`。
```json
{
"prompt": { ... }
}
```
几秒钟后,你应该收到类似这样的响应:
```json
{
"id": "random-uuid",
"prompt": { ... },
"images": ["base64encodedimage"]
}
```
将 base64 编码的字符串解码为图像。你可以:
* 使用免费的浏览器工具,如 [base64-to-image-converter](https://codebeautify.org/base64-to-image-converter)
## 推送和部署 Docker 镜像到生产
[Section titled “推送和部署 Docker 镜像到生产”](#推送和部署-docker-镜像到生产)
### 1. 推送镜像到共绩算力
[Section titled “1. 推送镜像到共绩算力”](#1-推送镜像到共绩算力)
这一步会将上一步中自定义的镜像上传到我们的镜像仓库服务中。请参考文档进行:
### 2. 部署配置
[Section titled “2. 部署配置”](#2-部署配置)
下面已经配置好的 docker-compose.yml 文件,相应的镜像已上传到共绩算力镜像仓库中,可以直接用于发布任务。
对于自己自定义的 docker-compose.yml,请先在本地使用 `docker compose up` 运行起来,来检查服务是否正常。
```yaml
version: '3.9'
services:
comfyui:
image: harbor.suanleme.cn/xuwenzheng/nex-comfy:sanhua0.5
ports:
- "3008:3000"
- "8189:8180"
labels:
# 第一个转发端口
- suanleme_0.http.port=3000
- suanleme_0.http.prefix=nexapi
# 第二个转发端口
- suanleme_1.http.port=8188
- suanleme_1.http.prefix=nexui
deploy:
resources:
reservations:
devices:
- driver: nvidia # 使用 NVIDIA GPU 驱动
count: 1 # 预留的 GPU 数量
capabilities: [ gpu ] # 指定 GPU 功能
```
### 3. 部署服务
[Section titled “3. 部署服务”](#3-部署服务)
去往共绩算力控制台
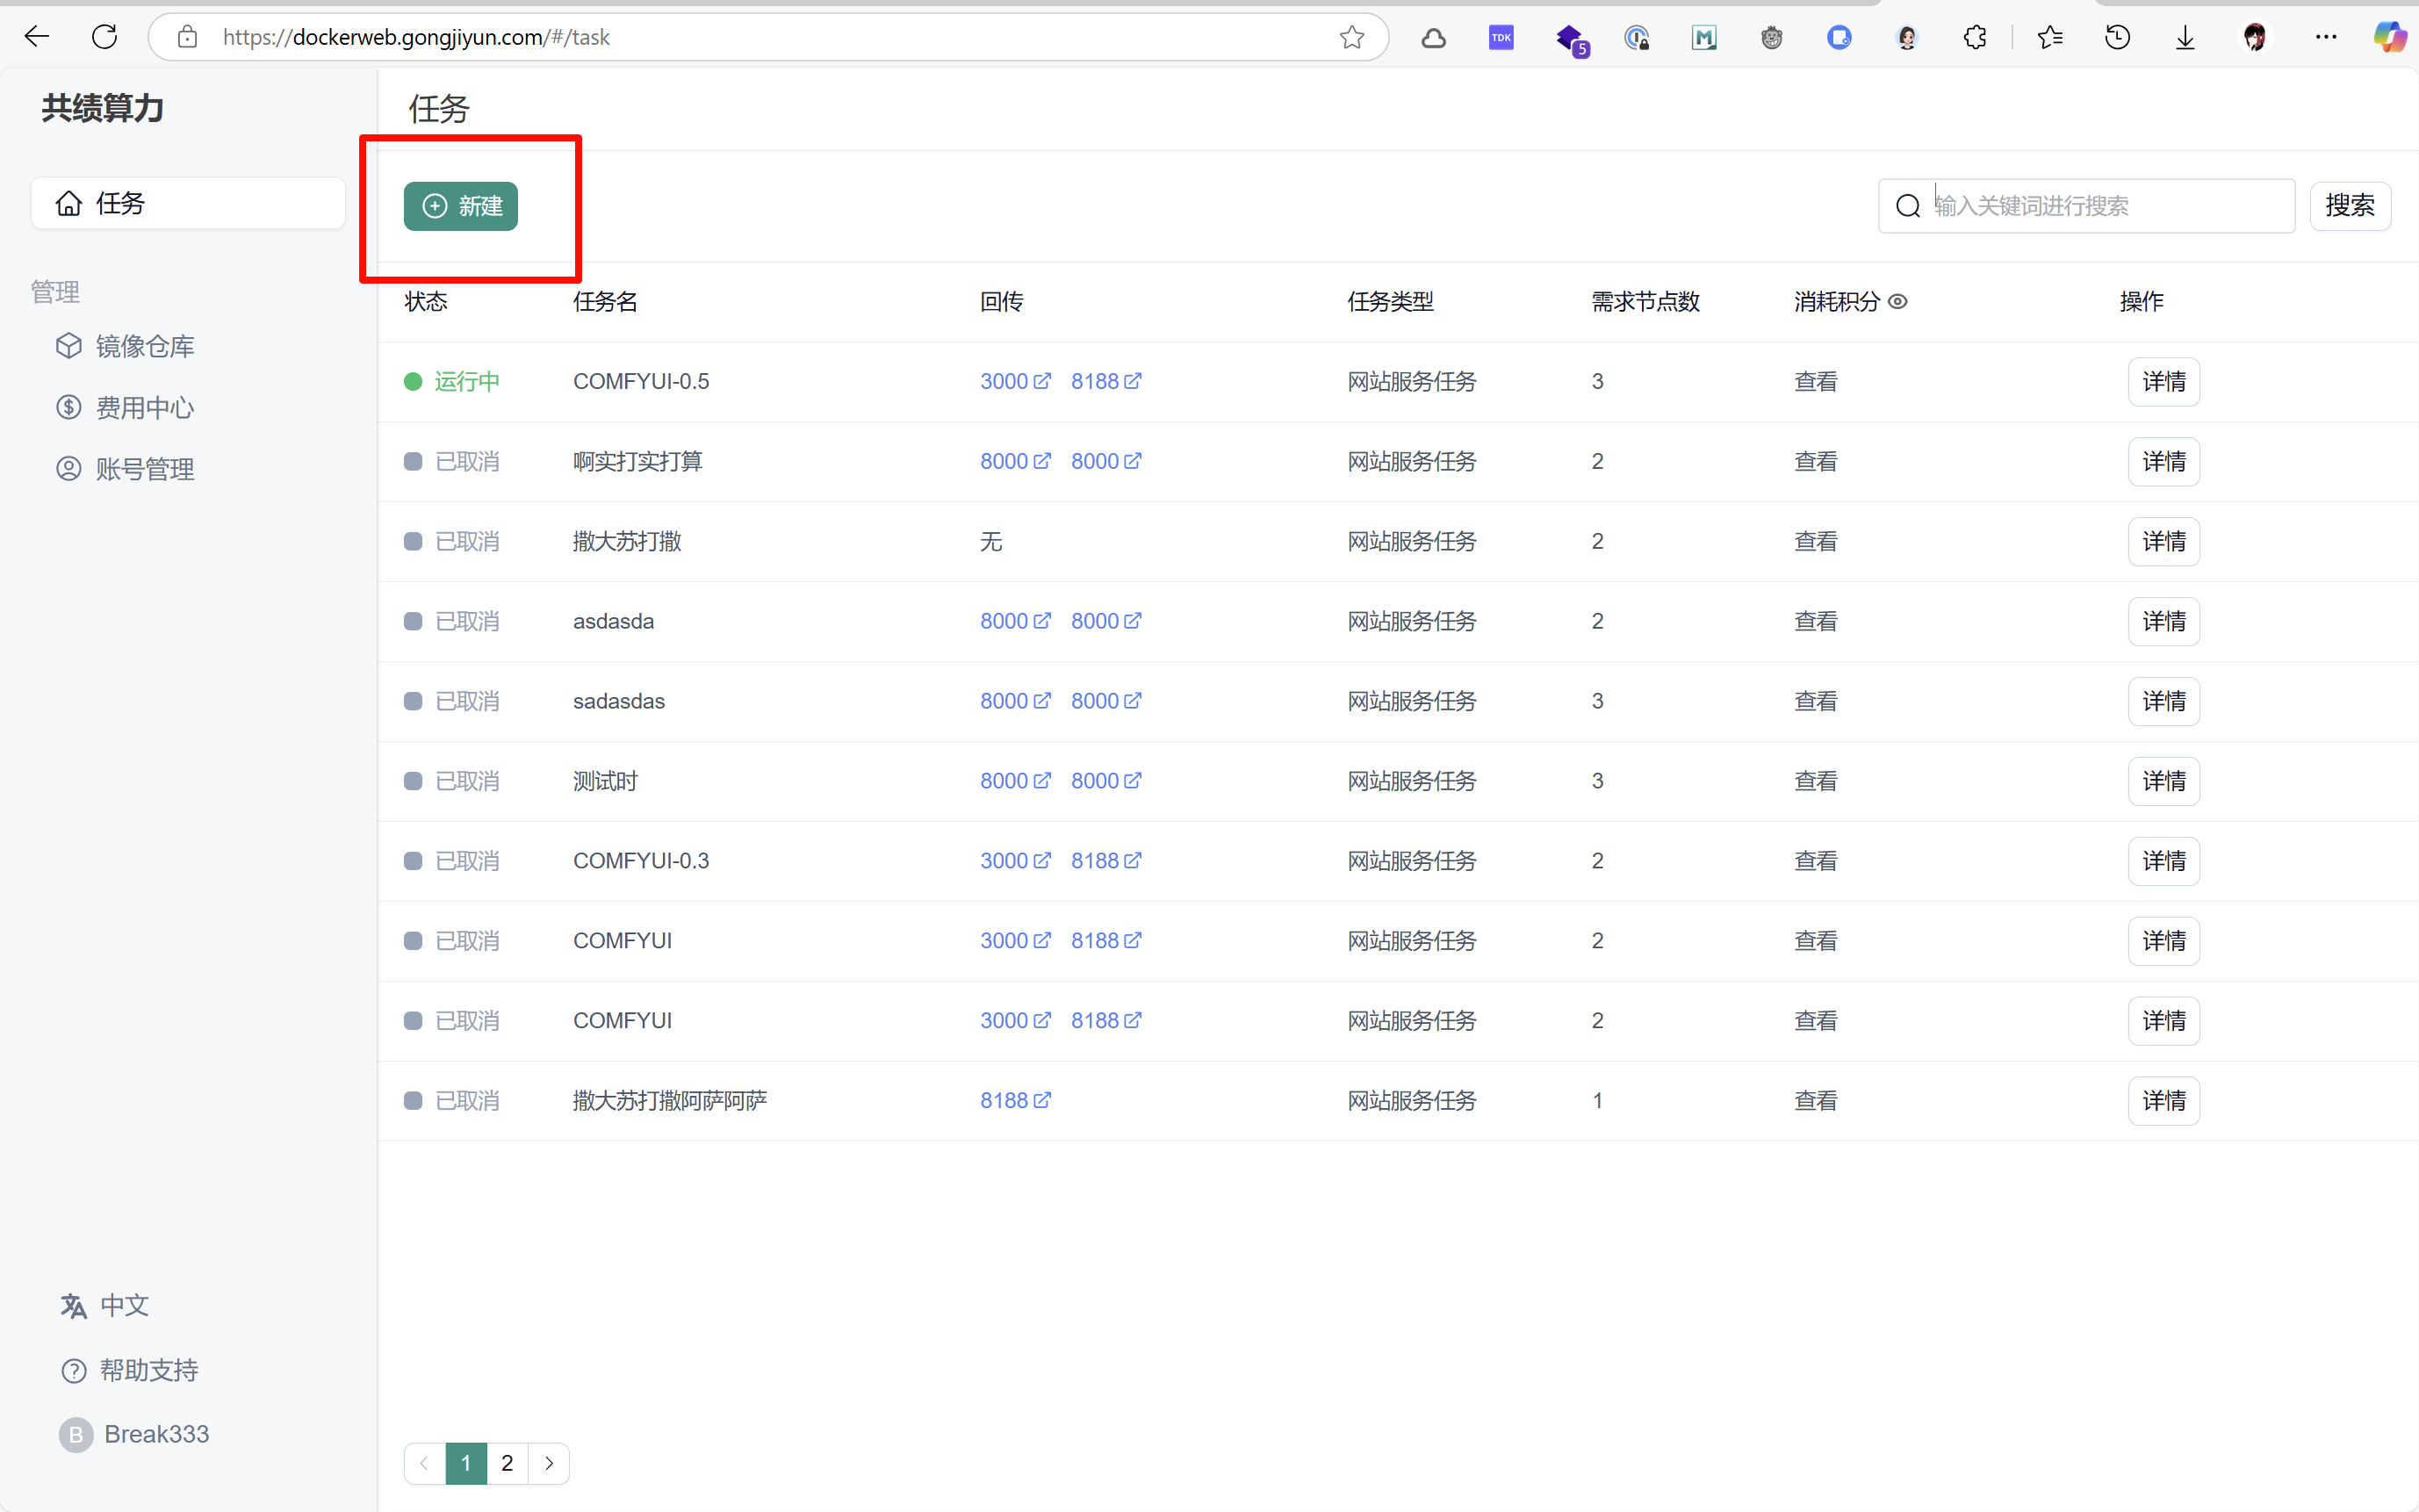
填写 Docker Compose 和基本信息
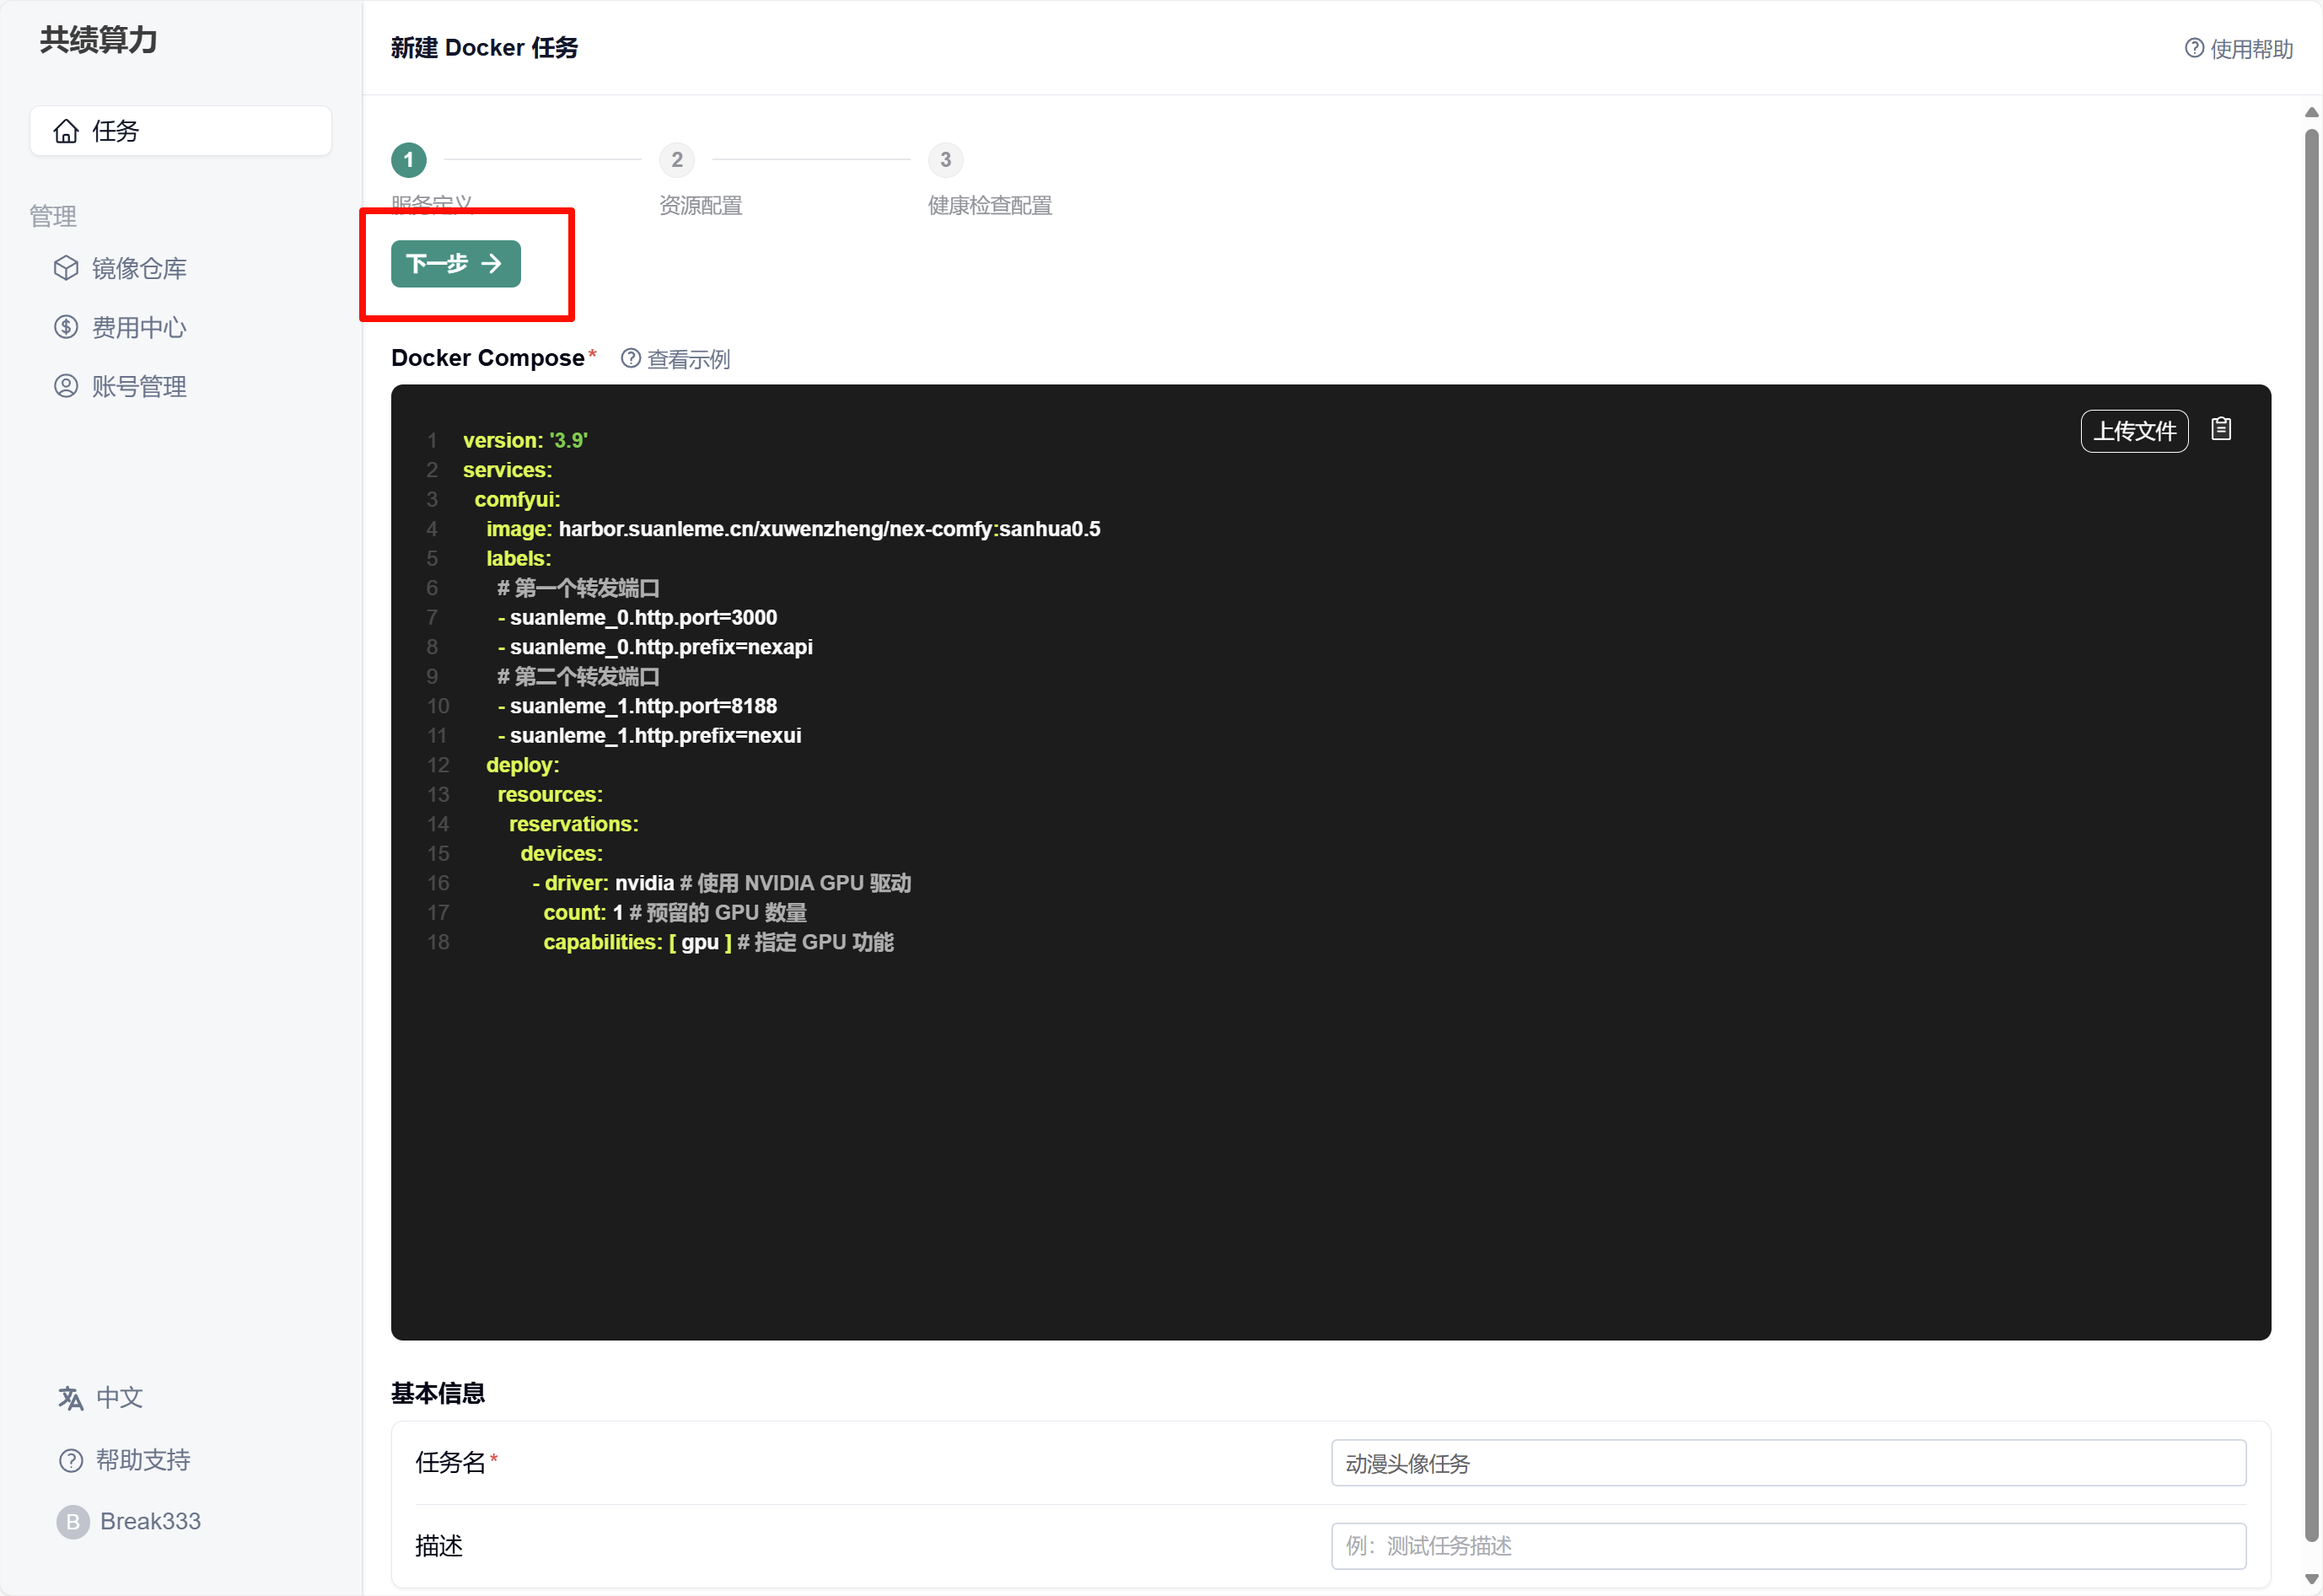
尽管我们所选用的基础镜像以 CUDA 12.1.1 为基础,但此镜像依旧能够选择更高的 CUDA 版本。
建议选择节点数量在 3 个以上。在显卡方面,推荐使用 3090,当前任务最低要求为显存在 12G 以上的显卡。
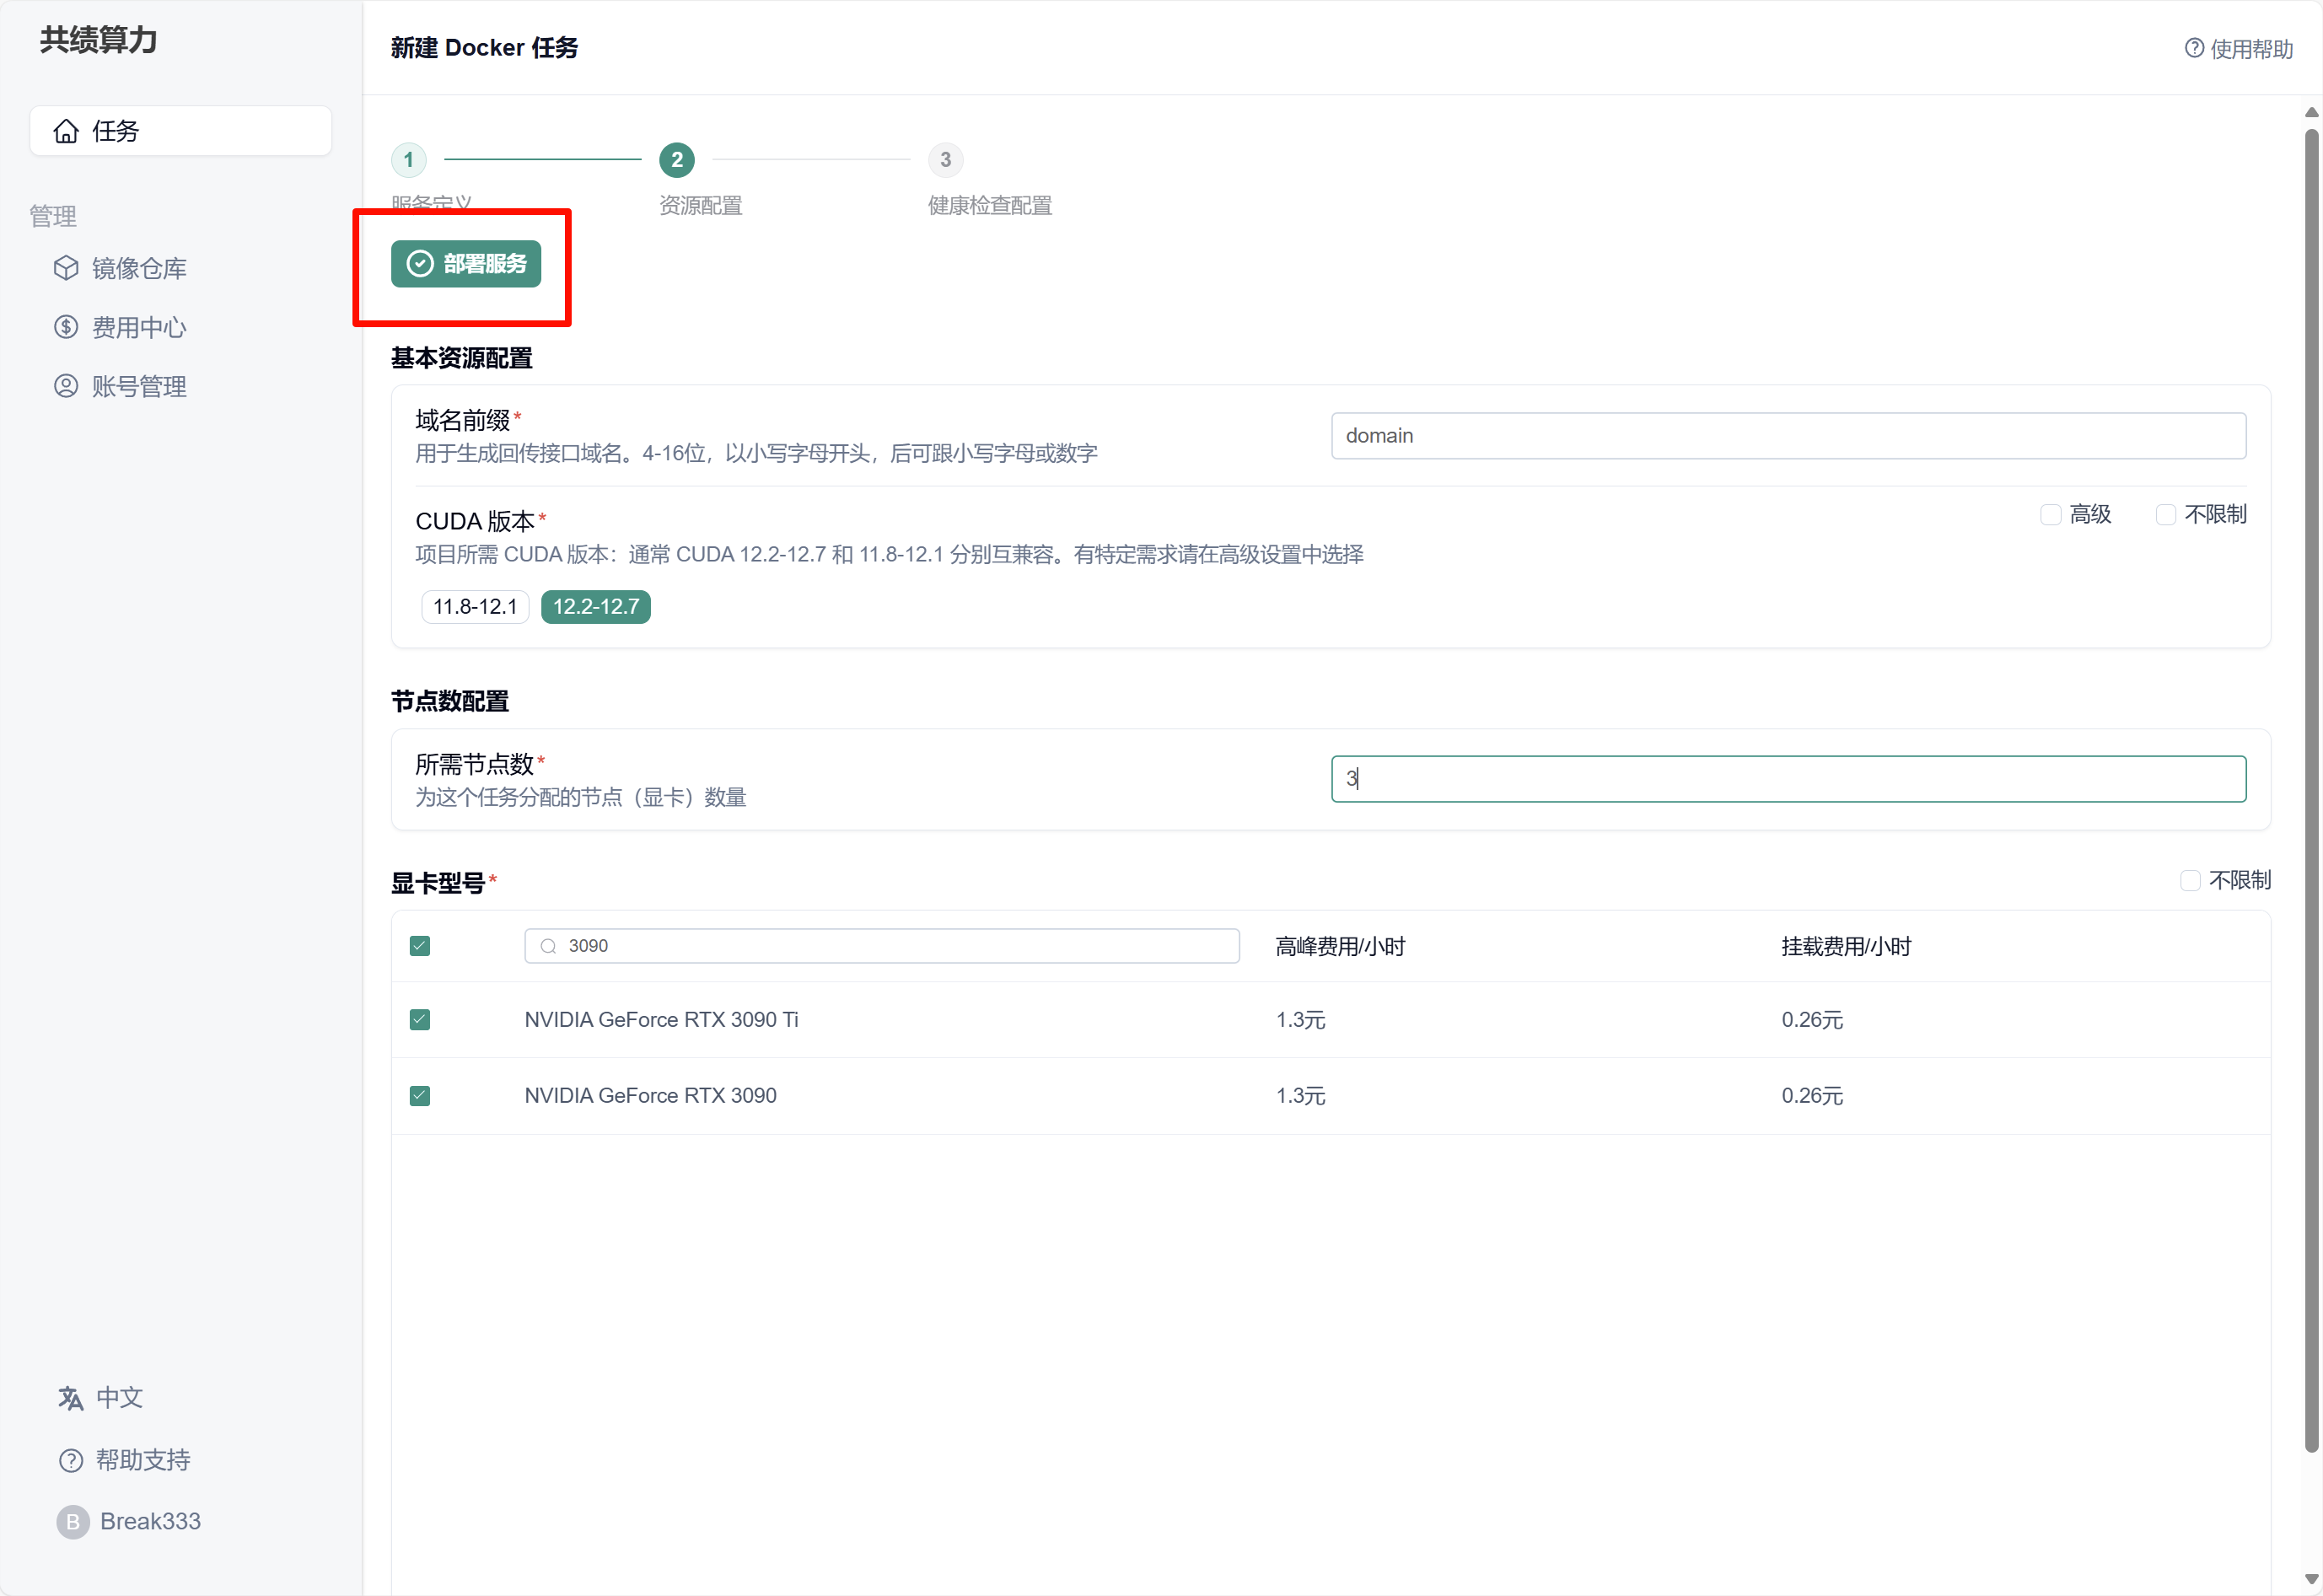
当前镜像的 API 服务已完成对 health check 接口的封装,可供平台检测服务的健康状态。其修改路径为对应的“/health”。该 API 服务对应 3000 端口。
等待节点部署
节点分配完成后,可以通过回传链接访问服务
链接 是基于此工作流开发的网页应用,您可以在线体验。
# 容器化部署 Flux.1-dev 文生图模型
本指南详细阐述了将 Flux.1-dev 基于[comfyui-api](https://github.com/SaladTechnologies/comfyui-api) 封装成 API,构建镜像并使其能够直接在 Docker 容器环境中运行的方法,同时也介绍了如何在共绩算力上部署 Flux.1-dev 模型应用。
我们基于本教程开源了一套前端 Flux.1-dev 文生图服务网站解决方案。
具有完整的 Docker\&Serverless 化部署方案,您可以参考使用。
项目地址:

* Docker
* NVIDIA GPU(当前演示工作流推荐 24G 显存及以上)
* 足够的磁盘空间(100G\~200G)用于存储模型、镜像以及构建缓存
## (一)下载模型文件
[Section titled “(一)下载模型文件”](#一下载模型文件)
我们所需的模型文件共有四个,下载链接分别如下,分别将其下载至本地:
注意,如果你的显存低于 32GB,建议将上述文件中的 t5xxl\_fp16.safetensors 替换为下面的低配版模型 t5xxl\_fp8\_e4m3n.safetensors(后续工作流中对应修改一下模型名即可),下面的案例中我们将使用低配版模型作为示例:
## (二)创建 Dockerfile 文件
[Section titled “(二)创建 Dockerfile 文件”](#二创建-dockerfile-文件)
一个合适的 docker 基础镜像能帮助我们节省大量的时间,同时还能大大减少我们构建出错的概率。这里我们选择[comfyui-api](https://github.com/SaladTechnologies/comfyui-api)开源库的官方镜像作为我们的基础镜像,其预装了 comfyui 及 comfyui-api 以及基础的运行环境依赖。
我们最终的需要 Dockerfile 文件内容如下,请新建一个名为 Dockerfile 的文件(注意无后缀),通过任意编辑器打开,将下面的内容复制进去。
```docker
FROM ghcr.io/saladtechnologies/comfyui-api:comfy0.3.29-api1.8.3-torch2.6.0-cuda12.4-runtime
ENV COMFYUI_PORT=8188 \
MODEL_DIR=/opt/ComfyUI/models \
BASE=""
RUN mkdir -p ${MODEL_DIR}/{loras,vaes,text_encoders,diffusion_models}
COPY diffusion_models/*.safetensors ${MODEL_DIR}/diffusion_models/
COPY vae/*.safetensors ${MODEL_DIR}/vae/
COPY text_encoders/*.safetensors ${MODEL_DIR}/text_encoders/
EXPOSE ${COMFYUI_PORT}
```
## (三)创建目录
[Section titled “(三)创建目录”](#三创建目录)
创建目录是为了便于我们指定路径,请按照下面的路径放置上述的文件。
comfyUI/
└── Dockerfile
├── diffusion\_models/
│ └── flux1-dev.safetensors
├── text\_encoders/
│ ├── clip\_l.safetensors
│ └── t5xxl\_fp8\_e4m3fn.safetensors
├── vae/
│ └── ae.safetensors
## (四)执行构建
[Section titled “(四)执行构建”](#四执行构建)
进入 comfyuiUI 目录,打开控制台,执行如下命令 (可根据需要自行修改标签和镜像名):
```docker
docker build -t comfyui-flux:0.1 .
```
耐心等待构建完毕,最终生成的镜像体积约 42GB。
## (五)本地测试(推荐)
[Section titled “(五)本地测试(推荐)”](#五本地测试推荐)
虽然即使不经过本地测试也可以直接上传使用,但本地测试可以更快的预览镜像构建效果,还能提前排除可能的一些问题,避免构建过程中的错误在上传远程仓库后才发现。
我们可以在任意位置打开控制台,键入以下指令:
```docker
docker run --rm --gpus all -p 3000:3000 comfyui-flux:0.1
```
当容器运行完毕后,,我们可以通过 API 来判断其是否正常工作。
### 获取 API 文档
[Section titled “获取 API 文档”](#获取-api-文档)
我们可以打开浏览器,网址栏输入`http://localhost:3000/docs`,即可打开默认的 comfyui-api 基于 swagger 的文档页面,如下图所示:

其中介绍了我们可以使用的 4 个常用方法,可自行了解详情。
### 测试生图接口
[Section titled “测试生图接口”](#测试生图接口)
接下来我们需要测试镜像容器的生图功能——当然也是最重要的功能。这一步推荐使用 PostMan 这类 API 测试工具,以下将以 PostMan 作为示例:
#### (1)创建请求
[Section titled “(1)创建请求”](#1创建请求)
新建一个请求,将其请求方法设置为 POST,并键入`http://localhost:3000/prompt`作为请求的 URL。
#### (2)选择参数
[Section titled “(2)选择参数”](#2选择参数)
找到下方的`body`栏,点击`raw`一项,并选择右侧的类型为`JSON`。在下方键入我们的 JSON 参数。
我们所需的参数如下,prompt 对应的是 comfyui 的工作流内容(API 形式)如果有自定义需要,我们也可以修改其中的参数值。

```plaintext
{
"prompt":{
"8": {
"inputs": {
"samples": [
"40",
0
],
"vae": [
"10",
0
]
},
"class_type": "VAEDecode",
"_meta": {
"title": "VAE解码"
}
},
"10": {
"inputs": {
"vae_name": "ae.safetensors"
},
"class_type": "VAELoader",
"_meta": {
"title": "加载VAE"
}
},
"11": {
"inputs": {
"clip_name1": "t5xxl_fp8_e4m3fn.safetensors",
"clip_name2": "clip_l.safetensors",
"type": "flux",
"device": "default"
},
"class_type": "DualCLIPLoader",
"_meta": {
"title": "双CLIP加载器"
}
},
"17": {
"inputs": {
"scheduler": "normal",
"steps": 25,
"denoise": 1,
"model": [
"46",
0
]
},
"class_type": "BasicScheduler",
"_meta": {
"title": "基本调度器"
}
},
"38": {
"inputs": {
"model": [
"46",
0
],
"conditioning": [
"42",
0
]
},
"class_type": "BasicGuider",
"_meta": {
"title": "基本引导器"
}
},
"39": {
"inputs": {
"filename_prefix": "FluxEz",
"images": [
"8",
0
]
},
"class_type": "SaveImage",
"_meta": {
"title": "保存图像"
}
},
"40": {
"inputs": {
"noise": [
"45",
0
],
"guider": [
"38",
0
],
"sampler": [
"47",
0
],
"sigmas": [
"17",
0
],
"latent_image": [
"44",
0
]
},
"class_type": "SamplerCustomAdvanced",
"_meta": {
"title": "自定义采样器(高级)"
}
},
"42": {
"inputs": {
"guidance": 3.5,
"conditioning": [
"43",
0
]
},
"class_type": "FluxGuidance",
"_meta": {
"title": "Flux引导"
}
},
"43": {
"inputs": {
"text": "beautiful photography of a gonger haired artist with Lots of Colorful coloursplashes in face and pn her hands, she is natural, having her hair in a casual bun, looking happily into camera, cinematic,",
"clip": [
"11",
0
]
},
"class_type": "CLIPTextEncode",
"_meta": {
"title": "CLIP文本编码"
}
},
"44": {
"inputs": {
"width": 1024,
"height": 1024,
"batch_size": 1
},
"class_type": "EmptySD3LatentImage",
"_meta": {
"title": "空Latent图像(SD3)"
}
},
"45": {
"inputs": {
"noise_seed": 454905699352480
},
"class_type": "RandomNoise",
"_meta": {
"title": "随机噪波"
}
},
"46": {
"inputs": {
"max_shift": 1.15,
"base_shift": 0.5,
"width": 1024,
"height": 1024,
"model": [
"48",
0
]
},
"class_type": "ModelSamplingFlux",
"_meta": {
"title": "采样算法(Flux)"
}
},
"47": {
"inputs": {
"sampler_name": "euler"
},
"class_type": "KSamplerSelect",
"_meta": {
"title": "K采样器选择"
}
},
"48": {
"inputs": {
"unet_name": "flux1-dev.safetensors",
"weight_dtype": "default"
},
"class_type": "UNETLoader",
"_meta": {
"title": "UNet加载器"
}
}
}
}
```
#### (3)发送请求
[Section titled “(3)发送请求”](#3发送请求)
请求返回的结果应该如下:
```docker
{
"id": "63c4114c-108a-4178-a37b-e53334607805",
"prompt"://你的工作流参数,
"images": []//返回的图片数组,
}
```
## (六)推送镜像到平台
[Section titled “(六)推送镜像到平台”](#六推送镜像到平台)
这一步会将上一步中自定义的镜像上传到我们的镜像仓库服务中。请参考镜像仓库文档进行
## (七)部署服务
[Section titled “(七)部署服务”](#七部署服务)
#### 访问共绩算力控制台 [https://dockerweb.gongjiyun.com](https://dockerweb.gongjiyun.com/),* *点击新建任务。
[Section titled “访问共绩算力控制台 https://dockerweb.gongjiyun.com, 点击新建任务。”](#访问共绩算力控制台-httpsdockerwebgongjiyuncom-点击新建任务)

#### 填写基本信息和 Docker Compose
[Section titled “填写基本信息和 Docker Compose”](#填写基本信息和-docker-compose)
我们所选用的基础镜像以 CUDA 12.4 为基础,但此镜像依旧能够选择更高的 CUDA 版本,cuda 版本通常具备向下兼容性。
建议选择节点数量在 3 个以上。在显卡方面,推荐使用 4090,当前任务最低要求为显存在 16G 以上的显卡。

项目所需的 docker-compose 文件如下,可供参考:
```plaintext
version: '3.9'
services:
comfyui:
image: harbor.suanleme.cn/light1/comfyui-flux:0.30 #这里修改为你上传镜像的地址和标签
ports:
- "3000:3000"
labels:
# 转发端口
- suanleme_0.http.port=3000
- suanleme_0.http.prefix=lastapi
deploy:
resources:
reservations:
devices:
- driver: nvidia # 使用 NVIDIA GPU 驱动
count: 1 # 预留的 GPU 数量
capabilities: [ gpu ] # 指定 GPU 功能
```
接下来,我们选择健康配置,该配置可供平台检测服务的健康状态。当前镜像的 API 服务已完成对 health check 接口的封装。修改路径为对应的“/health”。该 API 服务对应 3000 端口。配置完成后点击`保存配置`。

#### 等待节点部署
[Section titled “等待节点部署”](#等待节点部署)
由于镜像体积较大,我们需要耐心等待一段时间,部署完成后页面显示如下图。节点分配完成后,可以通过回传链接访问服务:

[FluxEz](https://flux.comnergy.com/zh)是基于此模式开发的 Flux.1-dev 在线文生图服务网页应用,您可前往该站点进行体验。
# 其它开源示例
我们提供了一些简单的例子供你使用参考,简单上手共绩算力。
## FunASR
[Section titled “FunASR”](#funasr)
开源示例:
> FunASR 是一个旨在搭建学术研究与工业应用之间桥梁的语音识别基础工具包,提供了包括语音识别、语音活动检测、标点恢复、语言模型、说话人验证、说话人对话语音识别等多种功能。
我们对 FunASR 已经进行了打包,可以快速部署在我们平台。
1. 复制下面代码
docker-compose.yml
```yaml
services:
slmasr:
image: harbor.suanleme.cn/admin/slmasr
build:
context: .
ports:
- 8000:8000
volumes:
- ./modelscope:/root/.cache/modelscope
deploy:
resources:
reservations:
devices:
- driver: nvidia
count: 1
capabilities: [ gpu ]
```
1. 遵从 [本操作](/docs/docker/quick.html#_2-%E5%8F%91%E5%B8%83%E4%BB%BB%E5%8A%A1)
## FFmpeg
[Section titled “FFmpeg”](#ffmpeg)
开源示例:
> FFmpeg 是一个开源的多媒体处理工具,主要用于音视频的录制、转换和流化处理。它提供了丰富的功能,包括格式转换、流复制、提取流、截取视频、截取图片、合并视频、添加字幕、调整音量、转换字幕等。FFmpeg 是一个跨平台的工具,可以在多个操作系统上运行,如 Linux、Windows 和 OS-X。
使用本例子请参考:[3 步上手](/docs/docker/quick)
# 优享算力
# 常见问题
## `no port available` 错误
[Section titled “no port available 错误”](#no-port-available-错误)
此错误通常出现在任务创建后的短时间内,表示当前没有可用的计算节点。请耐心等待系统自动调度分配节点。
您可以通过以下路径查看节点状态:任务列表 -> 任务详情 -> 节点状态
## 显示 `whoami` 页面
[Section titled “显示 whoami 页面”](#显示-whoami-页面)
如果看到 Caddy 的默认 whoami 页面,说明平台已经成功连接到计算节点,但容器可能未正确启动,或容器崩溃。
此页面会显示极短时间然后转变为 `no port available` 错误。
## `proxy request failed(data)` 错误
[Section titled “proxy request failed(data) 错误”](#proxy-request-faileddata-错误)
此错误很少发生。通常表示 Docker 容器未能成功启动。可能的原因包括:
* 镜像内部程序启动失败
* 容器配置参数不正确
建议检查:
1. 镜像是否能在本地正常运行
2. 查看任务日志获取详细错误信息
## `not find for domain`
[Section titled “not find for domain”](#not-find-for-domain)
表示该任务已被取消或没有该任务(链接错了),请检查任务状态。
# 为什么?
即开即用、真弹性计算,节约 50% 成本。
先进弹性计算服务商。
📢
弹性算力找共绩!
## 什么是共绩算力?
[Section titled “什么是共绩算力?”](#什么是共绩算力)
* 弹性:自动扩缩,算力削峰填谷;海量资源,做到天降雄兵
* 实惠:算力计程,真正按量付费
* 稳定:后台备用节点实时热保障
* 免运维:告别运维服务
* 低门槛:即开即用,文档完善
## 什么是弹性?
[Section titled “什么是弹性?”](#什么是弹性)

# 费用中心
# 发票管理
balabala
# 发票功能说明
欢迎使用共绩云发票管理系统。我们为您提供全数字化的数电发票自动开具服务,并配备标准化的消费凭证,满足企业及个人的财务合规及报销需求。
### 开票基本规则
[Section titled “开票基本规则”](#开票基本规则)
* **可开票额度**:可开票总额度 = 历史累计现金充值 - 历史累计已开票金额 - 累计提现退款金额。平台赠送金、代金券、SLA 调账补偿等非现金消耗不支持开票。
* 提现与退款限制:已开具发票的金额不支持直接提现。若您需要对已开票的余额进行退款,请先联系在线客服完成发票冲红或作废流程后,方可操作提现。
* 历史数据开票:2026 年 6 月 18 日(新版发票系统上线)之前的历史充值及消费记录,暂不支持在控制台自助开具。请准备好您的充值凭证并联系专属客服人工为您处理。
### 开票模式说明
[Section titled “开票模式说明”](#开票模式说明)
为满足不同企业的财务报销规范,平台支持两种开票模式(注:部分账户权限不同,以控制台实际展示为准):
* **模式 A:按消费账单开票**
* **适用场景**:适用于需要精确消费明细的日常报销。
* **规则**:按自然月出账后的实际消耗金额进行开票。
* **模式 B:按充值金额开票(预开票)**
* **适用场景**:适用于企业年底冲预算、提前核销科研经费等需要先付款后消费的场景。
* **规则**:直接按充值到账金额开票。开具发票的同时,系统将为您生成《充值证明》。
* **⚠️ 防冲突注意**:若您使用了“按充值金额开票”,由于发票额度已提前透支,您将无法再针对后续出账的月度账单重复开票,即无法使用消费账单开票
### 自助开票操作指引
[Section titled “自助开票操作指引”](#自助开票操作指引)
#### 第一步:管理发票抬头
[Section titled “第一步:管理发票抬头”](#第一步管理发票抬头)
1. 登录共绩云控制台,进入 **\[费用中心] -> \[发票管理]**。
2. 点击 **\[新增发票抬头]**,选择“企业单位”或“个人/非企业”。
3. 填写开票信息。个人仅需填写真实姓名与接收邮箱(默认为增值税普通发票);企业需填写真实准确的公司名称、纳税人识别号及基本信息(可选择专票或普票)。
#### 第二步:发起开票申请
[Section titled “第二步:发起开票申请”](#第二步发起开票申请)
1. 点击 **\[开票申请]** Tab 页。
2. 根据您的需求选择 **\[按消费账单开票]** 或 **\[按充值金额开票]**。
3. **按账单开票**:在列表中勾选需要开票的往期月份,系统会自动计算金额。
4. **按充值开票**:在输入框内手动输入所需的开票金额(不得超过当前可开票总额度)。
5. 选择发票抬头,确认接收邮箱无误后,点击 **\[提交申请]**。
#### 第三步:获取电子发票与凭证
[Section titled “第三步:获取电子发票与凭证”](#第三步获取电子发票与凭证)
1. 提交成功后,系统通常会在 5 分钟内自动完成开具。
2. 进入 **\[开票历史]** 列表,找到状态为 **已开具** 的记录。
3. 点击 **\[下载]** 即可跳转至税务开拍系统获取 PDF/OFD 等格式的电子发票原件;
### 发票与业务凭证样例
[Section titled “发票与业务凭证样例”](#发票与业务凭证样例)
共绩云统一开具 **全面数字化的电子发票(数电票)**,发票内容统一为 信息技术服务云服务费,效力与纸质发票完全等同。
#### 样例 1:数电发票(专票/普票)
[Section titled “样例 1:数电发票(专票/普票)”](#样例-1数电发票专票普票)
>
#### 样例 2:充值凭证(按充值开票)
[Section titled “样例 2:充值凭证(按充值开票)”](#样例-2充值凭证按充值开票)
如果您选择“按充值金额开票”,由于尚未产生实际消耗,下载的凭证为《充值明细证明》,用于证明资金已支付至平台。
>
### 常见问题 (FAQ)
[Section titled “常见问题 (FAQ)”](#常见问题-faq)
**Q:为什么我提交了申请,状态一直显示“开具失败”或“审核中”?**
**A**:这通常是由于税务局系统底层网络波动,或您的企业税号与工商局登记信息不符触发了人工安全核验。您的可开票额度未被扣减,请直接联系客服为您加急处理。
**Q:发票抬头填错了可以修改重开吗?**
**A**:发票一旦开具成功不支持用户自助修改。若确因信息错误需要重开,请准备好原发票信息联系在线客服,我们将为您在后台发起“发票冲红”流程。额度返还后,您可重新申请开具。
**Q:我可以将几个月的账单合并开一张发票吗?**
**A**:可以。在“按消费账单开票”界面,直接勾选多个您需要报销的月份,系统会自动将金额求和并开具在一张发票上。
# 账单管理
# 费用账单
## 概述
[Section titled “概述”](#概述)
“账单管理”模块为用户提供极具透明度的费用明细。让用户从宏观到微观,追踪每一分钱的去向。
### 多维度账单视图
[Section titled “多维度账单视图”](#多维度账单视图)
* **账单总览**:提供全局视角的财务汇总,适合财务人员进行月度/年度的整体成本核算。
* **按量计费**:由于共绩云平台包含大量按时长、按调用次数计费的云原生服务(如 Serverless 容器、临时 Job 任务等),该标签页专为高频变动的按量扣费提供精细化视图。
### 账单筛查与概览功能
[Section titled “账单筛查与概览功能”](#账单筛查与概览功能)
* **灵活的账期筛选**:支持通过切换“按月”**或**“按天”按钮,并结合日历组件(如筛选 `2026/04` 至今),精准圈定需要核对的时间范围。
* **账单概览**:在选定账期内,直观呈现核心财务数据:
* **应付金额**:该账期内所有云资源产生的原生费用总计。
* **算力券抵扣**:系统自动为您匹配并抵扣掉的优惠金额。
* **实付金额**:扣除所有优惠后,实际从您的账户余额或授信额度中扣除的真实金额。
* **账单状态**:显示当前账单是否已完成结算(如:“已出账”)。
### 服务详情深度解析
[Section titled “服务详情深度解析”](#服务详情深度解析)
在账单概览下方,系统会将账期内的总费用按“产品类别”进行拆解,帮助技术负责人在排查成本时快速定位“费用大头”:
* **产品线拆分**:支持查看不同业务模块的单独计费,例如:
* **计算与容器资源**:裸金属、云主机、弹性服务部署、Job 批处理任务。
* **存储与周边**:镜像仓库、对象存储加速等。
* **权益类**:预留资源包。
* **计费类型标明**:清晰标注该产品是“预付费”**(包年包月购买)还是**“按量计费”(用多少扣多少)。
* **抵扣链路展示**:针对每一项单独的产品,清晰展示其 `应付金额 -> 算力券抵扣金额 -> 实付金额` 的完整计算逻辑。
### 账单导出
[Section titled “账单导出”](#账单导出)
点击页面左上角的 **“导出账单”** 按钮,系统会将当前筛选条件下的所有账单明细打包为 Excel 或 CSV 文件下载至本地。导出的数据包含更详尽的字段(如资源实例 ID、计费项等),是企业进行内部成本分摊(Showback/Chargeback)的重要依据。
# 合同管理
# 框架合同
## 概述
[Section titled “概述”](#概述)
**企业认证**用户可在控制台**费用中心 - 合同管理**中申请电子版框架合同,与纸质合同具有同等法律效力。
## 创建框架合同
[Section titled “创建框架合同”](#创建框架合同)
### 点击创建框架合同。
[Section titled “点击创建框架合同。”](#点击创建框架合同)
如需了解合同文本内容,可单击**合同模板**。

### 填写甲方信息
[Section titled “填写甲方信息”](#填写甲方信息)
在**填写甲方信息**页面,按照提示填写框架合同中的甲方联系信息,单击**下一步:确认合同文本内容**。

### 确认合同文本
[Section titled “确认合同文本”](#确认合同文本)
在**确认合同文本内容**页面,核对生成的合同文本内容,待确认生成的合同文本内容无误后,单击**下一步:确认签署信息**。

### 确认签署信息
[Section titled “确认签署信息”](#确认签署信息)
在**确认签署信息**页面,核对签署信息无误后,单击**下一步:在线签署**。

### 确认进入签署环节
[Section titled “确认进入签署环节”](#确认进入签署环节)
填写甲方签署人信息后,点击下一步,确认进入签署环节

### 在线签署
[Section titled “在线签署”](#在线签署)
#### 点击“开始签署”,平台会发送签署短信给签署人,请前往法大大小电子签小程序或点击“前往签署”按钮完成电子签章。
[Section titled “点击“开始签署”,平台会发送签署短信给签署人,请前往法大大小电子签小程序或点击“前往签署”按钮完成电子签章。”](#点击开始签署平台会发送签署短信给签署人请前往法大大小电子签小程序或点击前往签署按钮完成电子签章)

#### 在客户方签署完成后,页面自动进入“平台签署”状态
[Section titled “在客户方签署完成后,页面自动进入“平台签署”状态”](#在客户方签署完成后页面自动进入平台签署状态)
### 合同查看
[Section titled “合同查看”](#合同查看)
签署完成后,页面会自动跳转到**查看合同**页面。在该页面可查看、下载已完成双方电子签章的正式版合同。

# 发票管理
# 订单管理
# 资源包管理
# 预留资源包
## 概述
[Section titled “概述”](#概述)
预留资源包是**一种预付费、包周期、计算资源费用抵扣券**,绑定特定**集群**与**卡型**,自动匹配同集群同卡型,抵扣**按量计费**的**计算资源**费用,同时提供**资源预留**能力,保障任务创建成功率。另外还支持**卡时返还**增值模式,支持闲置算力**共享变现**,盘活闲置算力,降低用户综合成本。
## 核心价值
[Section titled “核心价值”](#核心价值)
1. 解决用户**高峰期算力资源无法保障、空闲期闲置资源无法再利用/变现**的核心痛点,并适配不同用户的差异化算力需求。
2. 助力平台实现**算力资源的精细化运营、商业收益的有效提升、核心客户的深度绑定。**
3. 完善平台计费产品体系,**新增闲置算力共享变现模式**,强化算力租赁领域产品竞争力。
## 使用场景
[Section titled “使用场景”](#使用场景)
稳定弹性场景使用预留资源包,可以大幅降低成本。
* 弹性场景:资源总量保持相对稳定,但需根据业务情况弹性使用资源,可通过预留资源包实现降本增效。
* 自动化运维:需根据业务变动、波峰波谷等因素自动扩缩容,调整资源类型和分布。
* 资源锁定:针对重要的弹性业务,或资源供应紧张的情况,需通过提前锁定资源,规避资源供应风险。
## 计费方式
[Section titled “计费方式”](#计费方式)
预留资源包无法单独使用,需要匹配按量计费的计算类容器云产品(弹性部署服务、Job 批处理、云主机等),根据资源包所选卡型、卡数、所在区域等因素来抵扣按量计费的账单。
### 抵扣规则
[Section titled “抵扣规则”](#抵扣规则)
* 秒级计费,按小时抵扣。
* 若同时存在预留资源包和算力券,则优先抵扣预留资源包。
* 如果同时存在多张预留资源包可抵扣时,按照预留资源包的到期时间,先到期的先抵扣;若到期时间相同,生效时间早的先抵扣;若都相同,则随机选取。
## 计费规则
[Section titled “计费规则”](#计费规则)
### 计费类型
[Section titled “计费类型”](#计费类型)
购买预留资源包时仅支持预付费,即购买时一次性缴纳所有费用,有效期内不会再产生其他费用。
### 计费周期
[Section titled “计费周期”](#计费周期)
预留资源包从生效时间开始计费,到失效时间停止计费。
例如,您购买的一份预留资源包生效时间为 2026-05-01 00:00:00,失效时间为 2026-05-10 00:00:00。则该预留资源包的计费开始时间为 2026-05-01 00:00:00,计费停止时间为 2026-05-10 00:00:00。如果您在此期间已经持有运行中的可匹配的(同一卡型、同一区域、不超过资源包的购买卡数)容器类型计算任务,则从 2026-05-01 00:00:00 的小时账单开始抵扣,直至 2026-05-10 00:00:00 预留资源包失效停止抵扣。
预留资源包到期后,状态变更为已到期,不能继续抵扣按量计费账单,但已创建的按量计费资源仍可正常使用(遵循按量计费结算规则,可通过算力券或余额扣费),不会中断您的业务。
## 订单管理
[Section titled “订单管理”](#订单管理)
您可以在费用中心的订单管理页面查看预留资源包订单详情。

您可以通过预留资源包列表页和详情页查看对应信息。
## 预留资源包列表页
[Section titled “预留资源包列表页”](#预留资源包列表页)
列表页包括所有购买的资源包基本信息,可按状态(未生效、生效中、已过期)和卡型筛选。

## 预留资源包详情页
[Section titled “预留资源包详情页”](#预留资源包详情页)
详情页展示资源包详细信息,包括基础配置(生效集群、卡型、卡数、有效期以及生效时段)、计费与支付信息(订单金额、优惠金额、实付金额)以及账单抵扣明细(可以按时间范围筛选查询)。

# 充值
# 如何充值余额
## 打开共绩算力控制台
[Section titled “打开共绩算力控制台”](#打开共绩算力控制台)
## 进入充值页面
[Section titled “进入充值页面”](#进入充值页面)
登录后,在右侧费用信息栏点击 **「充值」**,进入充值界面
 
## 选择充值金额
[Section titled “选择充值金额”](#选择充值金额)
在充值页面中,可选择系统提供的快捷金额,例如 **10 元、20 元、30 元、50 元、100 元**,也可以手动输入需要充值的金额。
## 选择支付方式
[Section titled “选择支付方式”](#选择支付方式)
页面支持多种支付方式,包括:
* 微信支付
* 支付宝支付
* 公对公转账
## 完成支付
[Section titled “完成支付”](#完成支付)
根据实际需求选择合适的支付方式,确认充值金额无误后,点击对应支付方式并按页面提示完成付款
## 查看充值结果
[Section titled “查看充值结果”](#查看充值结果)
支付完成后,返回控制台确认账户余额是否已到账。如未及时到账,可刷新页面或联系平台客服处理

# (产品)弹性服务部署
# 最佳实践
# 弹性扩缩容 - 多策略负载均衡最佳实践
## 适用场景
[Section titled “适用场景”](#适用场景)
* **需要根据业务负载动态调整任务节点数量**,在资源成本与系统处理能力之间实现平衡。
* **需要支持自定义扩缩容策略**,根据业务指标、资源状态或运行规则进行精细化控制。
* **需要更灵活的流量调度与负载均衡机制**,满足复杂业务场景下的请求分发需求。
## 快速上手
[Section titled “快速上手”](#快速上手)
### 1.环境准备
[Section titled “1.环境准备”](#1环境准备)
需要准备一个带宽充足的云服务器,初期可选择按量计费,安装好 docker 环境。
> 如果只是本地测试使用,则不需要云服务器,只需要在本地安装好 docker 环境即可。
### 2.配置文件填写
[Section titled “2.配置文件填写”](#2配置文件填写)
完整的配置文件如下:
```json
{
"openapi_base_url": "https://openapi.suanli.cn", // 共绩域名,固定
"token":"", //用户密钥,用于调用共绩云 API 增减节点
"lb_policy":"LEAST_REQUEST", //负载均衡策略,支持 ROUND_ROBIN、LEAST_REQUEST、RANDOM、RING_HASH、MAGLEV
"max_connections": 1000, //单节点最大连接数
"max_requests":1000, //单节点最大请求数
"max_pending_requests": 100, // 单节点最大排队请求数(由于默认使用 http2 协议,该指标可能不生效)
"max_nodes": 20, //最大节点数,注意平台有最大节点用量限制,该值不应超过平台限制
"min_nodes": 2, //最小节点数,启动时检测节点数,小于该值时会自动扩容至该值,大于该值则会进入缩容逻辑
"p95_latency_threshold": 500, //单位 ms,p95 延时阈值
"p95_delay_duration":30, //单位 s,p95 超过阈值持续时间,超过该时间开始扩容
"shrinkage_delay_time": 600,//单位 s,缩容延迟时间,当满足缩容条件,多久后开始缩容
"shrinkage_number":1, //满足缩容条件时,单次最大缩容数量。
"drain_timeout": 60, //单位 s,缩容时等待已有链接完成最大等待时间,超过该时间即使还有连接也会强制下线。
"acq_frequency":10, //采集数据频率,默认 10s 采集一次计算相关指标
"dashboard": { //面板配置,数据保存在/var/log/supervisor/node_history.json
"default_days": 7, //面板默认显示最近几天的数据
"retain_days": 30 //磁盘数据保留天数,超过的数据会在下一次启动时删除
},
"expansion_strategies": [ // 扩容策略配置,未添加到本配置的策略不会启用
"trend_expansion",
"delay_prediction",
"p95_expansion"
],
"trend_expansion":{ //趋势扩容配置
"expand_cooling_time": 180, //触发扩容后的冷却时间,至少大于 60s,因为节点冷启动需要 60s
},
"delay_prediction":{ //延时预测扩容配置
"min_sample_size": 100, //最小样本数,当最近一分钟的总请求数量小于该值,则忽略
"expand_cooling_time": 180, //触发扩容后的冷却时间,至少大于 60s,因为节点冷启动需要 60s
"delay_time": 2, //单位 s,触发扩容条件的延时指标,当预测当前请求最晚需要 2s 及以上完成时触发
"expansion_ratio": 0.2, //扩容比例,用于计算需要扩容的数量:当前节点数*expansion_ratio
"min_expansion": 2, //最小扩容数量,实际扩容数量取 min_expansion 与 expansion_ratio 计算结果 的最大值
},
"p95_expansion":{ //p95 策略扩容
"min_sample_size": 100, //最小样本数,当最近一分钟的总请求数量小于该值,则忽略
"expand_cooling_time": 180, //触发扩容后的冷却时间,至少大于 60s,因为节点冷启动需要 60s
"threshold":500 ,//单位 ms,触发阈值,当近一分钟超过 5% 的请求数量延时超过该值时,触发阈值,
"threshold_duration": 30, //阈值持续时间,当触发阈值的持续时间超过该值时,触发扩容
"expansion_ratio": 0.2, //扩容比例,用于计算需要扩容的数量:当前节点数*expansion_ratio
"min_expansion": 2, //最小扩容数量,实际扩容数量取 min_expansion 与 expansion_ratio 计算结果 的最大值
},
"scale_up_request": { //通过发新任务进行扩容
"task_name": "test", //任务名,扩容时自动追加后缀,所有包含该名的任务都将作为扩容任务点
"points": 1, //单次任务新增节点数,将忽略该值,默认单任务启动单节点、以适配调度。
"resources": [
{
"mark": "REPLACE_WITH_RESOURCE_MARK_FROM_CLOUD" //实例信息(比如北京区 4090 等)标识,可通过 api 查询集群资源详情。
}
],
"services": [ //容器列表
{
"service_name": "svc1", //容器名,不支持下划线(_)
"service_image": "REPLACE_WITH_IMAGE", //镜像
"remote_ports": [ //该镜像需要暴露服务的端口
{
"service_port": 8080
}
],
"start_script_v2": {
"args": [], //参数
"command": null //镜像的启动命令,若镜像本身存在启动命令可不填
},
"env": [
{
"name": "gongji_share",
"value": "True"
}
]
}
]
}
}
```
其中需要重点关注的值:
* token:在平台控制台获取
* lb\_policy:调度策略
* max\_nodes:设置最大扩容节点数
* min\_nodes:设置最小扩容节点数
* scale\_up\_request:扩容任务时发生的请求体
* mark:资源标识,例如【河北四区 4090】,可通过接口或控制台获取
如需要调整扩缩容策略,可参考其它现有的参数值进行修改即可。
### 3.部署服务
[Section titled “3.部署服务”](#3部署服务)
```py
docker run -d -v [本地配置文件]:/app/configs/config.json -v [本地保存日志目录]:/var/log/supervisor -p 8080:8080 harbor.suanleme.cn/vm/gongji-slb:v0.9
```
注意将命令中的中文替换为正确的文件路径、目录路径。
部署成功后,所有打入该服务的流量将根据策略,自动将流量均衡转发到共绩云的任务内。
## 原理
[Section titled “原理”](#原理)
### 1.架构
[Section titled “1.架构”](#1架构)
服务架构如下:
本服务不做排队,所有进入的用户流量都会按调度策略转发给后端任务处理,因此需要保证后端任务支持同时处理多个用户请求的能力。
该服务的所有请求转发行为均可参考开源项目 Envoy,本项目只是对 Envoy 的一层封装:根据指标判断扩容与缩容。
### 2.扩缩容规则
[Section titled “2.扩缩容规则”](#2扩缩容规则)
趋势扩容:
1. 采集最近 60s 连接数增长速率,当 链接数 + 速率\*60s 大于 单节点最大请求数,则提前扩容。
1. 每 10 秒采集一次
2. 例如单节点最大支持 1000 请求,目前活跃请求 600,一分钟内增长到 820,则平均 每秒 4 个请求,一分钟后将超过 1000 个,因此需要在 820 时就要开始扩容。
2. 需要节点数:总请求数/安全容量
1. 安全容量:单节点最大请求数 - 增速\*60s
2. 例如:当前达到 1000 请求,过去一分钟增速为 5 个/s,安全容量为:1000-5\*60=700。则需要的节点数为:1000/700=1.42,向上取整,需要扩容到两个节点。
3. 扩容冷却:触发扩容后,将进入一段时间的观察期(时间可配置)
延时预测扩容:
1. 统计当前 新增 + 处理 + 排队中的请求数,除以 过去一分钟完成的请求数,得到剩余请求完成的最大完成时间。
1. 每 10 秒统计一次最近一分钟完成请求数 与 新增 + 处理 + 排队中的请求数
2. 需配置最小样本数,防止少数几个请求因为网络抖动超过阈值而扩容
2. 当延时时间超过 2s(可配置)时,触发扩容
3. 单次扩容节点数:Max(当前节点数 \* 20%, 2),(比例与数量可配置)
4. 扩容冷却:触发扩容后,将进入一段时间的观察期(时间可配置)
1. 防止“扩容震荡”(扩容节点还未加入、而继续触发扩容)
p95 扩容:
1. 当最近一分钟有 5% 的请求延迟大于 500ms(持续 30s)时开始扩容,该值可配置。
1. 每 10 秒统计一次最近一分钟的 p95 数值。
2. 需配置最小样本量,防止 qps 极低时,少数几个请求因为网络抖动超过阈值而扩容。
2. 每次触发扩容、扩容节点数为:Max(当前节点数 \* 20%, 2),(比例与数量可配置)
1. P95 触发的扩容,通常意味着系统已经感受到压力,此时的扩容应该**果断**。
3. 扩容冷却:触发扩容后,将进入一段时间的观察期(时间可配置)
1. 防止“扩容震荡”
扩容策略均彼此独立,任意一个满足扩容条件,都会触发扩容。
缩容策略:
1. 健康状态(趋势扩容、延时预测、p95 均正常)持续十分钟(时间可配置),则触发缩容。
1. 按趋势扩容计算可缩容的数量,单次最大缩容一个节点(可配置)。
2. 配置 envoy 停止将新流量打入将要下线的节点、并等待旧连接完成。
3. 待节点 active\_rq 请求链接数归零/或超时后,调用共绩云 api 移除节点。
极端情况:
1. 瞬时连接数超过当前所有节点的最大连接数之和,允许在 envoy 排队一定数量的请求(比如 100,可配置),继续超过阈值则丢弃新到来的请求。
# 通过对象存储加速持久化模型缓存
## 1. 场景
[Section titled “1. 场景”](#1-场景)
在弹性部署服务中,模型文件通常体积较大。如果将模型文件直接打包进镜像,虽然服务启动链路相对简单,但会带来以下问题:
* 镜像体积过大,构建、推送和拉取耗时较长。
* 模型版本更新时,需要重新构建镜像并重新发布。
* 多个服务使用同一模型时,容易出现模型文件随镜像重复存储的问题。
* 镜像和模型强绑定,不利于模型版本管理和快速切换。
* 大模型文件更新频繁时,镜像维护成本较高。
为了解决上述问题,可以将镜像和模型文件解耦:
* 镜像中只保留服务运行环境、依赖库和启动逻辑。
* 模型文件单独存放在对象存储中。
* 通过对象存储加速将模型目录挂载到任务容器中。
* 通过缓存预热减少服务启动时读取模型文件的等待时间。
本文主要介绍如何通过对象存储加速挂载模型文件,实现模型与镜像解耦,并提升模型读取效率。
## 2. 重要说明
[Section titled “2. 重要说明”](#2-重要说明)
当前对象存储加速以只读方式挂载到任务容器中,适合读取已经提前准备好的模型文件。用户需要先将模型文件上传到对象存储指定目录,再通过对象存储加速进行配置、预热和挂载使用。
例如,将对象存储加速配置挂载到容器内 `/root/data` 后,服务可以从该路径读取模型文件,但不能向该路径写入新文件。若尝试写入,系统会提示 `Read-only file system`。

因此,对象存储加速不会自动下载模型,也不会将容器运行过程中产生的新模型文件、下载结果或缓存文件写回对象存储加速目录。请勿将该目录作为模型在线下载或运行时缓存的写入目录。
## 3. 使用前提
[Section titled “3. 使用前提”](#3-使用前提)
使用对象存储加速持久化模型缓存前,需要满足以下前提:
* 已准备好对象存储 Bucket。
* 已将模型文件上传到对象存储指定目录。
* 已获取对象存储访问凭证,例如 Endpoint、AccessKey、SecretKey、Bucket 名称等。
* 已确认模型服务启动时需要读取的容器内路径。
* 已确认任务运行区域与对象存储加速区域一致。
对象存储接入、权限准备、加速目录填写、区域配置、预热缓存、删除缓存等通用操作,详见《对象存储加速使用说明》文档:[操作流程](https://suanli.cn/docs/storage-service/object-storage-acceleration/nceowz55diqv9hkid8wcgkosnkg/#2-%E6%93%8D%E4%BD%9C%E6%B5%81%E7%A8%8B)。
## 4. 整体操作流程
[Section titled “4. 整体操作流程”](#4-整体操作流程)
通过对象存储加速持久化模型缓存的整体流程如下:
## 5. 确认模型目录
[Section titled “5. 确认模型目录”](#5-确认模型目录)
使用对象存储加速前,需要先确认模型文件在对象存储中的目录结构,以及服务启动时需要从哪个容器路径读取模型。
例如,可以将模型文件按模型名称和版本组织为以下结构,将`/models/qwen/` 作为 Bucket 内加速目录:
```text
models/
qwen/
Qwen3-Coder-30B-A3B-Instruct-FP8/
config.json
tokenizer.json
model-00001-of-00004.safetensors
model-00002-of-00004.safetensors
model-00003-of-00004.safetensors
model-00004-of-00004.safetensors
```
任务容器启动后,可以将对象存储中的模型目录挂载到容器内指定路径,例如:
```bash
/mnt/models
```
此时模型服务可以从以下路径读取模型:
```bash
/mnt/models/Qwen3-Coder-30B-A3B-Instruct-FP8
```
如果镜像内的模型服务默认从 Hugging Face 缓存目录读取模型,也可以根据实际镜像逻辑,将对象存储加速配置挂载到:
```bash
/root/.cache/huggingface
```
具体挂载路径需要结合镜像内模型服务的读取逻辑确定。对象存储加速目录为只读挂载,只适合读取已经准备好的模型文件,不适合作为在线下载模型或运行时缓存写入目录。
## 6. 准备对象存储中的模型文件
[Section titled “6. 准备对象存储中的模型文件”](#6-准备对象存储中的模型文件)
在创建对象存储加速配置前,请先将模型文件上传到对象存储指定目录中。
推荐目录示例:
```bash
oss://demo-bucket/models/qwen/
oss://demo-bucket/models/deepseek/
oss://demo-bucket/models/llama/
```
不推荐直接使用:
```bash
oss://demo-bucket/
```
建议将模型文件按模型名称、模型版本或业务场景进行目录组织,例如:
```text
models/
qwen/
Qwen3-Coder-30B-A3B-Instruct-FP8/
deepseek/
DeepSeek-R1/
llama/
Llama-3-8B/
```
不建议直接选择 Bucket 根目录作为模型加速目录。根目录下可能包含多个业务目录或无关文件,后续目录加载、缓存预热和缓存删除的范围都会变大,不利于区分不同模型或业务数据。
## 7. 新增对象存储配置
[Section titled “7. 新增对象存储配置”](#7-新增对象存储配置)
进入「对象存储加速」页面,点击「新增对象存储配置」,填写对象存储相关信息。

需要填写的主要信息包括:
* 配置名称
* 云服务商
* 地域
* Endpoint
* AccessKey
* SecretKey
* Bucket 名称
* 加速目录

填写对象存储配置,包括 Endpoint、AK/SK、Bucket 和加速目录,填写完成后点击「创建配置」。
创建配置时,系统会自动校验对象存储配置是否可用。配置校验通过后,该对象存储配置才会成功保存。
对象存储配置的详细操作步骤、云厂商 AccessKey 获取方式、权限说明和桶策略配置,详见《对象存储加速使用说明》文档:[操作流程](https://suanli.cn/docs/storage-service/object-storage-acceleration/nceowz55diqv9hkid8wcgkosnkg/#2-%E6%93%8D%E4%BD%9C%E6%B5%81%E7%A8%8B)。
## 8. 配置加速区域
[Section titled “8. 配置加速区域”](#8-配置加速区域)
对象存储配置保存成功后,需要为该配置选择加速区域。
在对象存储加速列表中,点击「配置区域」,选择需要启用的加速区域。
 
配置加速区域主要用于准备对象存储挂载和缓存能力。配置完成后,该区域具备后续任务挂载和缓存预热能力。

需要注意:
配置加速区域不等于缓存预热。首次配置完成后,区域显示为「未同步」状态。此时**已经可以挂载使用**,但首次访问模型文件时可能仍需要从对象存储读取。为了提升首次访问速度,建议继续执行「预热缓存」。

区域状态说明、异常状态处理和可预热状态判断,详见《对象存储加速使用说明》文档:[区域状态说明](https://suanli.cn/docs/storage-service/object-storage-acceleration/nceowz55diqv9hkid8wcgkosnkg/#3-%E5%8C%BA%E5%9F%9F%E7%8A%B6%E6%80%81%E8%AF%B4%E6%98%8E)。
## 9. 预热模型缓存
[Section titled “9. 预热模型缓存”](#9-预热模型缓存)
区域配置完成后,点击「预热缓存」,选择需要提前缓存的模型目录。
预热缓存的前提是:对象存储目录中已经存在模型文件。
预热缓存需要同时选择:
* 预热区域
* 预热目录
例如,如果模型文件已经上传到:
```bash
/models/qwen/Qwen3-0.6B/
```
可以选择该目录进行预热。系统会将该目录下的模型文件提前加载到指定加速区域。

预热完成后,后续任务在相同区域访问该模型目录时,可以减少从远端对象存储读取模型文件的等待时间。
预热缓存的具体弹窗操作、目录树加载规则、元数据更新中状态说明,详见《对象存储加速使用说明》文档:[预热缓存](https://suanli.cn/docs/storage-service/object-storage-acceleration/nceowz55diqv9hkid8wcgkosnkg/#25-%E9%A2%84%E7%83%AD%E7%BC%93%E5%AD%98)。
## 10. 在任务中挂载使用
[Section titled “10. 在任务中挂载使用”](#10-在任务中挂载使用)
创建或编辑任务时,打开「存储配置」开关,在「对象存储加速挂载」区域选择需要挂载的对象存储配置,并填写容器挂载路径。
操作流程如下:
```text
打开「存储配置」开关 → 选择需要挂载的对象存储配置 → 输入容器挂载路径 → 点击「新增挂载」
```

常见挂载路径示例:
```bash
/mnt/models
/root/.cache/huggingface
/root/.cache/modelscope
/root/data
```
如果希望模型服务从指定模型目录读取模型,可以将对象存储加速配置挂载到:
```bash
/mnt/models
```
如果镜像内模型服务默认从 Hugging Face 缓存目录读取模型,也可以根据镜像实际逻辑挂载到:
```bash
/root/.cache/huggingface
```
如果只需要验证对象存储加速是否成功挂载,也可以挂载到测试路径,例如:
```bash
/root/data
```
建议任务运行区域与对象存储加速区域保持一致。如果任务区域与对象存储加速区域不一致,可能无法使用对应区域的缓存能力,首次访问模型时仍可能从对象存储读取。
由于对象存储加速目录为只读挂载,请确保模型服务启动时只读取该目录,不要将模型下载目录或运行时写入目录配置到对象存储加速挂载路径下。
任务挂载对象存储加速配置的完整操作步骤,详见《对象存储加速使用说明》文档:[任务发布时挂载](https://suanli.cn/docs/storage-service/object-storage-acceleration/nceowz55diqv9hkid8wcgkosnkg/#27-%E4%BB%BB%E5%8A%A1%E5%8F%91%E5%B8%83%E6%97%B6%E6%8C%82%E8%BD%BD)。
## 11. 模型读取路径示例
[Section titled “11. 模型读取路径示例”](#11-模型读取路径示例)
对象存储加速挂载完成后,服务需要从容器内的挂载路径读取模型文件。不同镜像或模型服务的启动方式不同,用户需要根据镜像内服务的实际要求,配置模型读取路径。
例如,对象存储加速配置挂载到容器内:
```bash
/mnt/models
```
对象存储中的模型目录为:
```bash
/models/qwen/Qwen3-0.6B/
```
挂载后,容器内可读取的模型路径为:
```bash
/mnt/models/qwen/Qwen3-0.6B
```
此时,模型服务启动时应将模型路径配置为上述容器内路径。具体参数名称和启动方式请以所使用镜像或服务框架为准。
如果对象存储目录中尚未准备模型文件,服务启动时可能无法正常加载模型。部分服务会尝试在线下载模型,但下载结果无法写入对象存储加速挂载目录,因此不建议依赖服务启动时自动下载模型。
建议在启动服务前完成以下检查:
* 模型文件已经上传到对象存储指定目录。
* 对象存储配置已经完成加速区域配置。
* 已对模型目录执行缓存预热。
* 任务中已经将对象存储加速配置挂载到服务实际读取的容器路径。
* 进入容器后,可以通过 `ls` 命令查看到模型文件。
## 12. 效果验证
[Section titled “12. 效果验证”](#12-效果验证)
任务启动后,可以进入容器查看挂载目录是否存在模型文件。
例如:
```bash
ls /mnt/models/qwen/Qwen3-0.6B/
```
如果能够看到对象存储中对应目录下的模型文件,说明挂载成功。

模型文件读取速度会受到模型大小、对象存储访问速度、网络环境、缓存是否完成预热、GPU 初始化耗时等因素影响,请以实际运行结果为准。
## 13. 删除缓存与重新预热
[Section titled “13. 删除缓存与重新预热”](#13-删除缓存与重新预热)
如果某些模型目录不再需要加速,可以在对象存储加速页面点击「删除缓存」,选择需要删除缓存的目录。
删除缓存会移除所选目录对应的数据记录,并更新加速用量。该操作不会删除对象存储中的模型源文件,也不会删除对象存储配置。
删除缓存后,如果后续任务再次访问这些模型文件,可能需要重新从对象存储读取,或重新执行缓存预热。
如果模型文件已经在对象存储中更新,建议重新执行「预热缓存」,确保后续任务读取到最新模型内容。
删除缓存的弹窗操作、加速用量变化、元数据更新中状态和 4KB 基础目录占用说明,详见《对象存储加速使用说明》文档:[删除缓存](https://suanli.cn/docs/storage-service/object-storage-acceleration/nceowz55diqv9hkid8wcgkosnkg/#26-%E5%88%A0%E9%99%A4%E7%BC%93%E5%AD%98)。
# 通过 API 实现弹性节点扩缩容
平台提供了强大的 Open API,允许您通过编程方式动态地对任务节点进行扩容或缩容。这对于实现自动化运维、根据业务负载高峰低谷自动调整资源、节约成本具有重要意义。
接口参数文档:
## **1.任务节点数量修改接口**
[Section titled “1.任务节点数量修改接口”](#1任务节点数量修改接口)
此接口是实现弹性伸缩的核心,允许您实时修改指定任务的运行节点数量。
**接口地址**:
`POST /api/deployment/task/change_points`
**说明**:根据您在平台生成 API 密钥的模式 (简易模式或签名模式),此接口的调用方式略有不同。

### **1.1 请求参数**
[Section titled “1.1 请求参数”](#11-请求参数)
**Header 参数**
| | | | |
| ----------- | ------ | ---- | ------------------------------- |
| 参数名 | 类型 | 是否必需 | 描述 |
| `token` | string | 是 | 您在平台生成的 API 密钥 |
| `timestamp` | string | 是 | 请求时间戳 (毫秒),例如 `1747379023000` |
| `version` | string | 是 | API 版本号,例如 `1.0.0` |
| `sign_str` | string | 否 | 签名字符串。如果 `token` 为简易模式,则无需填写此字段 |
**Body 参数** (`application/json`)
| | | |
| --------- | ------- | ---------------- |
| 参数名 | 类型 | 描述 |
| `task_id` | integer | 必需,您要修改的目标任务的 ID |
| `points` | integer | 必需,修改后任务的目标节点数量 |
**任务 ID 从这里获取:**

### **1.2 请求体示例**
[Section titled “1.2 请求体示例”](#12-请求体示例)
```json
{
"task_id": 388,
"points": 1
}
```
### **1.3 调用示例代码 (Python)**
[Section titled “1.3 调用示例代码 (Python)”](#13-调用示例代码-python)
以下是使用 Python 的 `http.client` 库调用此接口的示例:
```py
import http.client
import json
conn = http.client.HTTPSConnection("openapi.suanli.cn")
payload = json.dumps({
"task_id": 388,
"points": 1 # 将任务 ID 为 388 的节点数量修改为 1
})
headers = {
'token': 'YOUR_API_TOKEN', # 替换为您的 Token
'timestamp': '1747379023000', # 替换为当前的时间戳
'version': '1.0.0',
'sign_str': '', # 如果是签名模式,需要计算并填写
'Content-Type': 'application/json'
}
conn.request("POST", "/api/deployment/task/change_points", payload, headers)
res = conn.getresponse()
data = res.read()
print(data.decode("utf-8"))
```
### **1.4 返回响应**
[Section titled “1.4 返回响应”](#14-返回响应)
如果请求成功,您将收到如下格式的 JSON 响应:
`200 OK`
```json
{
"code": "0000",
"message": "success"
}
```
### **1.5 完整调用示例与成功响应**
[Section titled “1.5 完整调用示例与成功响应”](#15-完整调用示例与成功响应)
下面是一个将任务 ID 为 `3000` 的节点数量从 1 个调整为 2 个的真实调用示例。
**示例代码 (Python)**
```py
import http.client
import json
import time
API_TOKEN = "d1e7f0a8-49df-4760-8cb2-09b7aeb48dbf-20250709180338" # 示例 Token
TASK_ID = 3000 # 示例任务 ID
TARGET_POINTS = 8 # 目标节点数
current_timestamp = int(time.time() * 1000)
conn = http.client.HTTPSConnection("openapi.suanli.cn")
payload = json.dumps({
"task_id": TASK_ID,
"points": TARGET_POINTS
})
headers = {
'token': API_TOKEN,
'timestamp': str(current_timestamp),
'version': '1.0.0',
'sign_str': '',
'Content-Type': 'application/json'
}
try:
conn.request("POST", "/api/deployment/task/change_points", payload, headers)
res = conn.getresponse()
print(f"状态码:{res.status} {res.reason}")
data = res.read()
print("响应内容:")
try:
response_json = json.loads(data.decode('utf-8'))
print(json.dumps(response_json, indent=4, ensure_ascii=False))
except (json.JSONDecodeError, UnicodeDecodeError):
print(data.decode('utf-8', errors='ignore'))
finally:
conn.close()
```
**成功响应日志**
执行以上脚本后,得到的成功响应如下:
```shell
--- 准备发送请求 ---
URL: https://openapi.suanli.cn/api/deployment/task/change_points
请求方法: POST
Headers: {'token': 'd1e7f0a8-49df-4760-8cb2-09b7aeb48dbf-20250709180338', 'timestamp': '1752055431338', 'version': '1.0.0', 'sign_str': '', 'Content-Type': 'application/json'}
Payload: {"task_id": 3000, "points": 2}
--------------------
--- 收到响应 ---
状态码: 200 OK
响应内容:
{
"code": "0000",
"message": "success",
"data": null
}
```
**效果验证**
调用成功后,回到控制台任务详情页,可以看到节点数量已成功变为 8 个,一个新的节点正在启动或已在运行中。

## **2.实践建议**
[Section titled “2.实践建议”](#2实践建议)
您可以将此 API 集成到您的监控和自动化脚本中。例如,通过监控应用负载 (如队列长度、API 响应时间),当负载超过预设阈值时,自动调用此接口增加节点 (`points` 调大);当负载恢复正常时,再调用接口减少节点 (`points` 调小),从而实现真正意义上的无人值守和成本优化。
# 弹性部署服务最佳实践
## 一。环境准备
[Section titled “一。环境准备”](#一环境准备)
### 1. 本地环境将服务容器化
[Section titled “1. 本地环境将服务容器化”](#1-本地环境将服务容器化)
构建完整服务镜像
### 2. 注册并初始化账号,申请测试券
[Section titled “2. 注册并初始化账号,申请测试券”](#2-注册并初始化账号申请测试券)
登录注册地址:
#### **2.1. 设置登陆密码并绑定微信(可选)**
[Section titled “2.1. 设置登陆密码并绑定微信(可选)”](#21-设置登陆密码并绑定微信可选)

#### **2.2. 激活账号**
[Section titled “2.2. 激活账号”](#22-激活账号)
充值 0.01 激活账号

#### **2.3. 申请测试算力券**
[Section titled “2.3. 申请测试算力券”](#23-申请测试算力券)
注册账号后联系商务对接人员,提供账号信息由他给您走申请流程
### 3. 镜像上传,镜像预热
[Section titled “3. 镜像上传,镜像预热”](#3-镜像上传镜像预热)
#### **3.1. 初始化镜像仓库**
[Section titled “3.1. 初始化镜像仓库”](#31-初始化镜像仓库)
平台镜像仓库页面:
#### **3.2. 镜像上传**
[Section titled “3.2. 镜像上传 ”](#32-镜像上传-)
信息查看页面:
```bash
#登录镜像仓库
docker login harborpush.suanleme.cn --username=yourname
#修改镜像tag
docker tag [ImageId] harborpush.suanleme.cn/yourname/[镜像名称]:[镜像版本号]
#推送镜像
docker push harborpush.suanleme.cn/yourname/[镜像名称]:[镜像版本号]
```
上传后平台镜像仓库会有对应的镜像

#### **3.3. 镜像预热**
[Section titled “3.3. 镜像预热”](#33-镜像预热)
若镜像**大于 50G,**请在上传完镜像后联系共绩技术人员提前给此镜像提前做预热,避免过长时间等待镜像下载
### 4. 存储准备
[Section titled “4. 存储准备”](#4-存储准备)
#### **4.1. 对象存储加速**
[Section titled “4.1. 对象存储加速”](#41-对象存储加速)
功能:以 s3 协议将云上对象存储桶内的数据加载到指定集群中,在加速完成后可以被同集群的任务以只读属性进行挂载,没有强制的容量限制;**适合存放固定的大体积模型文件,实现模型镜像分离减少镜像体积**
**对象存储加速配置参考文档**:
**配置方式:**
配置存储桶的 AKSK 以建立连接,需要此 AKSK 具备 ListObjectsV2、PutObject、DeleteObject 权限

配置完成后,请点击「配置区域」选择需要启用的加速区域。区域配置完成后,可按需点击「预热缓存」选择目录进行数据预热。
**使用方式:**
创建任务时先指定存储桶并挂载到指定路径即可
## 二、创建任务
[Section titled “二、创建任务”](#二创建任务)
新增部署任务:
### 1. 绑定存储
[Section titled “1. 绑定存储”](#1-绑定存储)
开启「存储配置」--- 点击「新增挂载」--- 填写挂载路径
```text
/root/.cache/huggingface
```

### 2. 选择 GPU 型号和区域
[Section titled “2. 选择 GPU 型号和区域”](#2-选择-gpu-型号和区域)
先挂载指定区域后,任务区域会自动限制在存储的指定区域

### 3. 服务配置 - 选择镜像
[Section titled “3. 服务配置 - 选择镜像”](#3-服务配置---选择镜像)

#### **方式一:使用预制镜像发布任务**
[Section titled “方式一:使用预制镜像发布任务”](#方式一使用预制镜像发布任务)
在服务配置中,可以选择平台提供的 **预制镜像,**每个镜像均配有文档说明,方便快速了解部署和使用方式**。**这里我们随机选择了一个预制镜像。

选择完成后,滚动到页面最下方点击 **【部署服务】**,提交任务。
#### **方式二:使用用户自定义镜像发布任务**
[Section titled “方式二:使用用户自定义镜像发布任务”](#方式二使用用户自定义镜像发布任务)

#### 3.1. 配置端口暴露、环境变量
[Section titled “3.1. 配置端口暴露、环境变量”](#31-配置端口暴露环境变量)

#### 3.2. 启动命令
[Section titled “3.2. 启动命令”](#32-启动命令)

### 4. 启动任务
[Section titled “4. 启动任务”](#4-启动任务)

## 三、检查任务运行状态
[Section titled “三、检查任务运行状态”](#三检查任务运行状态)
### **1.任务调度状态**
[Section titled “1.任务调度状态”](#1任务调度状态)
刚启动时

任务状态为「运行中」开始计费

### 2.节点信息查看
[Section titled “2.节点信息查看”](#2节点信息查看)

监控:该监控页面主要展示当前节点的运行状态、所在区域,以及 CPU、内存、GPU 等资源的实时使用率和历史趋势

日志:查看容器日志信息,只有容器内程序启动后才有

事件:容器启动的事件信息,在任务启动时查看,展示任务调度、镜像下载、任务挂载、启动命令配置等信息

终端:提供一个 webui 界面,可以进入容器内操作和查看信息,有对应的 shell 环境

更换节点:启动一个新的任务,关闭旧的任务,实际效果为将任务进行重启(pod 被重建)

### 3.终端查看挂载
[Section titled “3.终端查看挂载”](#3终端查看挂载)

### 4.查看端口链接
[Section titled “4.查看端口链接”](#4查看端口链接)
服务内没有监听对应端口时显示如下

**安装 nginx 后**
 
### 5.任务控制
[Section titled “5.任务控制”](#5任务控制)

任务状态为「已停止」结束计费

## 四、信息补充
[Section titled “四、信息补充”](#四信息补充)
* 弹性部署服务不保存镜像状态,也暂不支持 ssh 功能,平台提供 webui
弹性部署服务中运行的任务不会保存其中的状态,每次启动是基于选择的镜像启动的,镜像没变化则启动后都一样,但挂载的共享存储卷保存的内容是可以被持久化的
* 镜像集群下载时间
第一次启动任务时镜像时从公网下载,启动耗时相对较长,同一个集群内后续会建立缓存,减少启动时间
* 节点扩缩容与链接的负载均衡
弹性部署服务中任务若为多节点,端口链接默认是轮询的负载均衡模式
* 终端页面不会保存上一个 shell 页面
点开终端执行的操作记录是标准页面的 bash,如果执行了前台的命令,页面关闭后进程不会保持,后续也无法再进入此 bash,而是进入一个新的 bash
## 五、名词解释
[Section titled “五、名词解释”](#五名词解释)
### **新增部署**
[Section titled “新增部署”](#新增部署)
指创建一个新的 Serverless 服务实例,用于分配计算资源并运行指定镜像。
包含内容:
* **资源管理**:GPU、CPU、内存等资源分配
* **镜像管理**:指定运行环境
* **费用记录**:按使用时长生成账单
### GPU 型号
[Section titled “GPU 型号”](#gpu-型号)
GPU 型号代表单个节点的计算能力规格:
* **1 卡 / 2 卡 / 4 卡 / 8 卡**:单节点 GPU 数量
* **显存大小**:决定可运行模型规模
* **CPU / 内存**:影响多任务并发能力
* **库存数量**:当前可用资源规模
**适用场景:**
* 1 卡:模型推理、数据处理
* 多卡:分布式训练、高并发计算
### 显存要求(≥16GB)
[Section titled “显存要求(≥16GB)”](#显存要求16gb)
显存用于存储模型参数和中间计算数据。
* 16GB:中等规模模型的最低需求
* 24GB(如 4090):可稳定运行主流 AI 推理服务
### 节点数量
[Section titled “节点数量”](#节点数量)
节点代表相同配置的计算实例数量。
* 1 节点:单任务或低并发场景
* 多节点:并行计算或横向扩展
建议先使用 **1 个节点** 验证任务运行情况,再根据需要扩展。
### 服务名称
[Section titled “服务名称”](#服务名称)
服务名称是当前部署任务的唯一标识。
**建议命名规范:**`用途-日期`
示例:`image-generation-20250515`
便于后续管理、监控和成本统计。
### 启动命令
[Section titled “启动命令”](#启动命令)
启动命令用于覆盖镜像的默认启动行为,允许用户自定义容器启动时执行的指令。
作用:定制服务启动参数、初始化脚本或运行多个程序。
使用场景:
* 为 WebUI 添加额外启动参数(如 `--listen --port 7860`)
* 执行自定义初始化脚本后再启动主服务
* 同时运行训练任务和监控进程
格式:通常为 Shell 命令,例如:

注意:若镜像已内置完善的启动脚本,通常无需填写;错误命令会导致容器启动失败。
### 添加端口
[Section titled “添加端口”](#添加端口)
指在部署配置中手动指定容器内部服务监听的端口号,使平台能够将外部请求正确转发至服务实例。
* 必要性:自定义镜像必须显式配置端口,平台无法自动识别容器内的服务端口。
* 配置方式:在“服务配置”区域填写端口号(如 `7860`、`8888`),需与镜像中实际启动的服务端口严格一致。
* 常见错误:
* 未添加端口 → 服务部署成功但无法访问
* 端口号填写错误 → 访问时出现连接失败或超时
* 注意:同一服务可配置多个端口,但需确保镜像内服务已相应监听;预制镜像通常已预置端口,无需手动添加。
# 日志采集容器配置说明
为了满足平台用户发布任务时对日志持久化的需求,平台提供了一套低侵入、开箱即用的日志采集方案。
通过本指南,您可以轻松地将容器内产生的业务日志,实时投递至指定的第三方云日志服务(如阿里云 SLS、腾讯云 CLS、火山引擎等),而无需手动编写复杂的底层配置文件。
## 一、功能入口
[Section titled “一、功能入口”](#一功能入口)
在创建或编辑**多容器任务**时,开启“该任务为多容器任务”开关。在下方的容器标签页区域,点击最右侧的 **「添加日志容器」** 按钮,系统将弹出“日志容器配置”窗口。
 
## 二、日志容器配置指引
[Section titled “二、日志容器配置指引”](#二日志容器配置指引)
在弹出的配置窗口中,您只需按步骤完成以下三个模块的填写,最后点击底部的 **「确认挂载」** 即可。
### 云服务商选择与鉴权配置
[Section titled “云服务商选择与鉴权配置”](#云服务商选择与鉴权配置)
平台支持将日志推送到多种主流云厂商。选中您的目标厂商后(需要您提前在云厂商日志服务中进行注册,表单下方提供了对应云厂商的官方配置参考文档链接),请填写对应的鉴权与路由参数:
* **阿里云 SLS(示例)**
* **地址**:填写 SLS\_KAFKA\_ENDPOINT,例如 cn-hangzhou.log.aliyuncs.com:10012;
* **Project 名称**:您的 SLS 项目名;
* **LogStore 名称**:接收日志的 Logstore 名称;
* **具备 sls 写入权限的 AccessKeySecret**:填写对应权限的密钥凭证(SLS\_PASSWORD); 
     
* 所属地域 → 决定了采集配置中填写的 地址(SLS 入口),例如选“华东 1(杭州)”则地址为 `cn-hangzhou.log.aliyuncs.com`。
* Project 名称 → 直接对应采集配置中的 Project 名称(SLS\_PROJECT),填写后记住该名称。
* Project 回收站 / 资源释放保护 → 根据安全需要决定,不影响日志采集。
* Project 注释 → 选填,仅便于管理,不影响采集。
* 资源组 → 使用默认即可,不影响采集。
* 开通日志(详细日志) → 是否记录操作日志,按需开启,与业务日志采集无关。
* **火山引擎 TLS / 腾讯云 CLS**
* 切换选项后,请根据界面上动态变化的表单,填入对应云厂商要求的主题 ID (Topic)、日志集 ID 等路由及鉴权参数。
* **自定义配置**
* 如果您使用其他日志中心,可选择此项进行高度自定义的配置。
### 日志源配置
[Section titled “日志源配置”](#日志源配置)
您需要告诉采集器去哪里读取业务日志文件。平台会自动在底层建立安全的临时共享卷,您无需手动配置复杂的挂载关系。
* **配置方法**:在输入框中填写需要采集的日志**绝对路径**,支持使用通配符(例如默认的 /logs/\*.log)。
* **注意**:请务必确保您的核心业务容器(如 container-01)也已将日志落盘(写入文件)至上述填写的路径中。本方案暂不支持直接采集控制台的标准输出。
 
* 云服务商选择 → 选“阿里云 SLS”
* 地址 → 填 SLS 地域公网入口,例如 `cn-hangzhou.log.aliyuncs.com`
* Project 名称 → 填已创建的 SLS Project 名,如 `gongji-app-logs`
* LogStore 名称 → 填该 Project 下的 LogStore 名,如 `app-file-log`
* AccessKeySecret → 填有日志写入权限的 RAM 用户 AccessKey Secret
* 日志源配置 → 填容器内日志路径(支持通配符),如 `/var/log/ /*.log`
* 日志轮转托管 → 建议勾选,防止日志撑爆磁盘
* 确认挂载 → 点击确认,确保日志目录已挂载
### 日志轮转托管
[Section titled “日志轮转托管”](#日志轮转托管)
长时间运行的服务如果不清理日志,极易导致容器磁盘打满。平台为您提供了开箱即用的日志轮转能力。
* **开启轮转托管**:打开开关后,平台将为您“自动轮转并控制日志保留数量”(默认单文件上限 100MB,保留 5 个)。
* **避坑指南**:如果您的业务代码**已经自带了日志按天或按大小切割的逻辑,请务必保持此开关处于“关闭”状态**。同时开启业务轮转和平台轮转会导致严重的文件读取冲突,从而造成日志丢失。
## 三、 ⚠️ Job 批处理任务专属退出机制
[Section titled “三、 ⚠️ Job 批处理任务专属退出机制”](#三-️-job-批处理任务专属退出机制)
**如果您运行的是数据批处理、AI 离线训练等 Job 批处理类任务,请务必阅读本章节,这关乎您的任务能否正常结束。**
### 为什么需要配置退出机制?
[Section titled “为什么需要配置退出机制?”](#为什么需要配置退出机制)
由于日志采集器是一个常驻后台的进程,它永远不会主动停止。当您的主业务程序执行完毕退出后,如果没有特定的信号通知,日志容器将一直在后台挂起等待。这将导致整个任务的 Pod 无法变为已完成状态,不仅会**持续占用计算资源**,还会导致**重试机制失效**。
### 如何配置安全退出?
[Section titled “如何配置安全退出?”](#如何配置安全退出)
为确保任务结束后能释放资源,平台已为您底层挂载了共享目录 /tasksite。请在**业务代码运行结束时**(或异常捕获逻辑中)执行以下命令触发退出机制:
在启动命令最后添加命令 touch /tasksite/tombstone 通知日志容器退出。
风险提示:若程序异常崩溃导致该命令未执行,可能会造成任务挂起或重试失败
## 四、常见问题解答 (FAQ)
[Section titled “四、常见问题解答 (FAQ)”](#四常见问题解答-faq)
**Q:为什么配置了日志容器,但在云平台界面上的控制台日志里看不到输出?**
A:当前方案会将日志落盘写入文件。写入指定目录文件的日志会被精准投递到您配置的云服务商(如阿里云 SLS)中。控制台只展示标准输出的内容。
**Q:提交配置后,还能修改挂载关系吗?**
A:点击“确认挂载”后,系统会在工作负载中自动生成一个专用的日志容器。对于弹性部署服务,如需修改,您可以随时点击该日志容器的标签页进行重新配置或移除。但是对于 job 批处理任务,将不可以更改配置。
# 通过共享存储卷持久化模型缓存
## 场景
[Section titled “场景”](#场景)
当我们使用例如 Comfyui, vLLM, Ollama 等服务过程中常常有以下几个痛点。
* 多个服务中模型重复下载,重复储存。
* 启动过程拉取模型过慢。
* 服务重启后模型需要重复下载。
## 共享存储卷介绍
[Section titled “共享存储卷介绍”](#共享存储卷介绍)
共享存储卷是共绩算力自主研发的高性能云存储解决方案,采用独特的分布式存储技术,实现本地磁盘与云端存储的无缝对接。在模型缓存场景下我们利用了共享存储卷以下特性。
* 可直接挂载至容器指定目录下,读写可直接通过文件系统实现。
* 容器销毁后数据不丢失,重新启动后无需重新拉取。
* 文件可在同集群多个服务容器之间复用。
* 跨集群自动同步,减少人工操作。
## 最佳实践
[Section titled “最佳实践”](#最佳实践)
我们以 vLLM 为例
### 1.确认缓存目录
[Section titled “1.确认缓存目录”](#1确认缓存目录)
vLLM 通常把模型缓存在 \~`/.cache/huggingface/` 下,若是设置了 `VLLM_USE_MODELSCOPE=True` 模型会缓存在 `~/.cache/modelscope/`下。除了模型外我们也可以缓存 vLLM 生成的 Compile Time Cache. 因此我们可以直接缓存整个目录 \~`/.cache/`,这样我们在容器启动过程中就无需重复编译。
❗
Compile Time Cache 只能在架构相同的 GPU 上共享
### 2.新建共享存储卷
[Section titled “2.新建共享存储卷”](#2新建共享存储卷)
具体的操作我们可以参考

建议根据自己的实际需求。新建存储桶。
存储桶大小必须大于模型文件大小而且留有余量。
区域必须与业务容器所在区域对应。
### 3.挂载到业务容器
[Section titled “3.挂载到业务容器”](#3挂载到业务容器)
创建完成后我们可以在对应任务下方设置挂载共享存储卷。

建议在首次启动前挂载,首次启动 vLLM 仍会下载模型,下载完成后再次启动或者其他容器即可重复利用缓存。
❗
不要出现多个容器同时下载模型的情况。
### 4.效果验证
[Section titled “4.效果验证”](#4效果验证)
我们建立一个 vLLM 的自定义服务如下:

镜像 URL = harbor.suanleme.cn/laiaqwq/vllm-openai:2025-10-13
端口配置 = 8000
启动命令 = vllm
启动参数 =
serve
Qwen/Qwen3-Coder-30B-A3B-Instruct-FP8
—tensor-parallel-size
2
—max-num-seqs
8
—max\_model\_len
32K
**挂载共享存储卷**

**启动服务**
挂载存储卷后,模型首次下载,将保存在共享存储卷内。

而在第二次启动过程中,模型可直接从共享存储卷加载。

```yaml
2025-10-28T02:46:46.057044894Z [1;36m(Worker_TP0 pid=290)[0;0m
Loading safetensors checkpoint shards: 0% Completed | 0/4 [00:00
### **3.2 Job 任务配置示例**
[Section titled “3.2 Job 任务配置示例”](#32-job-任务配置示例)
通过 API 创建 Job 任务需要按照 Kubernetes Job 资源格式配置 YAML,以下是一个多容器 Job 任务的完整配置示例:
```yaml
---
apiVersion: batch/v1 # 指定 Kubernetes API 的版本,用于 Job 资源
kind: Job # 指定资源类型为 Job,用于运行一次性任务
metadata: # 元数据部分,定义 Job 的基本信息
name: gpu-job-pi # Job 的名称,必须是唯一的
spec: # Job 的具体配置
completions: 4 # 总共需要成功完成的 Pod 数量
parallelism: 2 # 同时运行的 Pod 数量
backoffLimit: 4 # Pod 失败后的重试次数
ttlSecondsAfterFinished: 86400 # Job 完成后保留的时间(秒),之后自动清理
template: # Pod 模板,定义每个 Pod 的配置
metadata: # Pod 元数据
labels: # Pod 的标签,用于标识和选择
app: gpu-job-pi
spec: # Pod 的具体配置
restartPolicy: Never # Pod 的重启策略,设置为 Never 表示失败后不重启
containers: # 定义 Pod 中的容器
- name: pi # 主容器名称
image: harbor.suanleme.cn/huang5876/jupyter-tf1.15-gpu:v3.0 # 主容器的镜像地址
imagePullPolicy: IfNotPresent # 镜像拉取策略,如果本地存在则不拉取
env: # 环境变量
- name: DEBUG_MODE # 调试模式开关
value: "true" # 设置为 "true" 进入调试模式,"false" 运行实际任务
command: # 容器启动命令
- /bin/bash
- -c
args: # 容器启动参数
- |
if [[ $DEBUG_MODE == true ]]; then
echo "==== DEBUG: sleep 8h ===="
sleep 28800 # 调试模式下睡眠 8 小时
else
echo "==== 真正脚本写这里 ===="
# python /mnt/data/train.py # 替换为实际的启动命令
fi
resources: # 资源限制和请求
limits:
cpu: "14" # 最大 CPU 使用量
nvidia.com/gpu: "1" # 使用 1 块 GPU
memory: 50Gi # 最大内存使用量
requests:
cpu: 1166m # 最小 CPU 请求量
nvidia.com/gpu: "1" # 请求 1 块 GPU
memory: 2133Mi # 最小内存请求量
volumeMounts: # 挂载卷
- name: data
mountPath: /mnt/data # 数据卷挂载路径
- name: out
mountPath: /mnt/output # 输出卷挂载路径
- name: pi2 # 辅助调试容器
image: harbor.suanleme.cn/library/cuda:debugv4 # 调试容器的镜像地址
imagePullPolicy: IfNotPresent # 镜像拉取策略
command: # 调试容器启动命令
- sleep
- infinity # 无限睡眠,方便调试
resources: # 资源限制和请求
limits:
cpu: "9"
nvidia.com/gpu: "1"
memory: 4Gi
requests:
cpu: 2333m
nvidia.com/gpu: "1"
memory: 10Gi
volumes: # 定义卷
- name: data
persistentVolumeClaim: # 数据卷 PVC
claimName: gpu-job-data-pvc # PVC 名称
- name: out
persistentVolumeClaim: # 输出卷 PVC
claimName: gpu-job-output-pvc # PVC 名称
nodeSelector: # 节点选择器
accelerator: nvidia # 选择带有 GPU 的节点
tolerations: # 容忍度
- key: nvidia.com/gpu
operator: Exists # 允许调度到带有 GPU 污点的节点
effect: NoSchedule
```
## 4.改参 - 提交 - 看状态 - 进终端
[Section titled “4.改参 - 提交 - 看状态 - 进终端”](#4改参---提交---看状态---进终端)
1️⃣ 改参数(5 个高频开关)
用任何编辑器打开 `gpu-job.yaml`——只动下面 5 处,别的别动:
| | | |
| --------------------- | --------------- | ----------------------------- |
| 位置 | 示例值 | 说明 |
| `name: gpu-job-pi` | `my-experiment` | 一次提交一个 Job,名字不能重复 |
| `completions: 4` | `10` | 总共要成功的 Pod 数 |
| `parallelism: 2` | `5` | 同时跑几个 Pod |
| `value: "true"` | `"false"` | `true` 睡 8 h 调试;`false` 真正跑代码 |
| `nvidia.com/gpu: "1"` | `"2"` | 每 Pod 用几张卡 |
改完保存即可。
2️⃣ 提交到集群
```bash
kubectl apply --dry-run=client -f gpu-job.yaml
kubectl apply -f gpu-job.yaml
```
成功提示
`job.batch/my-experiment created`
3️⃣ 实时看 Pod 状态
```bash
watch -n 1 kubectl get po -l app=gpu-job-pi
```
输出示例
```text
NAME READY STATUS RESTARTS AGE
my-experiment-5shk9 2/2 Running 0 14s
my-experiment-7v4kp 2/2 Running 0 14s
my-experiment-h6abc 0/2 Pending 0 2s # 还没调度
```
STATUS 列常见值
`Pending` → 正在找 GPU 节点 / 拉镜像
`ContainerCreating` → 创建中
`Running` → 可以 exec 进去了
`Completed` → 正常退出
`Error` / `CrashLoopBackOff` → 出错了看日志
4️⃣ 进终端调试(两种容器)
**a) 进主容器(pi)**——里面有 GPU、训练环境
```bash
kubectl exec -it my-experiment-5shk9 -c pi -- bash
[root@5shk9 /]# nvidia-smi # 看 GPU
[root@5shk9 /]# ls /mnt/data # 看数据卷
[root@5shk9 /]# python /mnt/data/train.py # 手动跑脚本
```
退出 `exit`
**b) 进辅助容器(pi-debug)**——纯净 CUDA 环境,调驱动、看卡
```bash
kubectl exec -it my-experiment-5shk9 -c pi-debug -- bash
[root@5shk9 /]# nvcc --version
[root@5shk9 /]# nvidia-smi -q # 详细显卡信息
```
退出 `exit`
5️⃣ 看日志(排错必用)
```bash
kubectl logs my-experiment-5shk9 -c pi
kubectl logs my-experiment-5shk9 -c pi-debug
```
6️⃣ 清理 Job(跑完及时删)
```bash
kubectl delete job my-experiment
```
因为模板里写了 `ttlSecondsAfterFinished: 86400`,集群也会在 1 天后自动清掉。
## **5.多容器资源分配算法**
[Section titled “5.多容器资源分配算法”](#5多容器资源分配算法)

当使用多容器配置时,系统采用智能的资源分配算法来确保每个容器获得合理的资源分配。
**CPU 资源分配机制**:在 Job 任务的多容器场景中,系统采用加权平均算法进行 CPU 资源分配。该算法确保每个容器按照其配置比例获得相应的 CPU 资源。算法实现过程如下:首先计算所有容器的 CPU 配置总和,然后根据每个容器的配置占比,将实际机器的 CPU 核心数按比例分配给各个容器。例如,当第一个容器配置 14,000 微核,第二个容器配置 9,333 微核时,总和为 23,333 微核。在实际分配过程中,假设选择 4090 卡(20 核)作为目标机器,系统会计算第一个容器的分配比例:14,000 ÷ 23,333 ≈ 60%,因此第一个容器将获得 20 核 × 60% = 12 核的 CPU 资源。
**内存资源分配机制**:内存分配采用总量计算和比例分配相结合的策略。系统首先汇总所有容器的内存配置需求,然后按照各容器的内存配置比例进行资源分配。具体分配流程如下:以第一个容器内存配置 51,200 兆,第二个容器配置 4,200 兆为例,系统计算出总内存需求为 55,400 兆。随后,系统根据第一个容器的内存配置占比(51,200 ÷ 55,400 ≈ 92%)将目标机器的内存资源进行分配,假设目标机器内存为 101 G,则第一个容器将获得 101 G × 92% ≈ 93 G 的内存资源。
**GPU 资源分配策略**:GPU 资源分配采用优先级分配策略,确保关键任务能够优先获得 GPU 资源支持。分配规则如下:当选择单 GPU 配置时,系统优先将 GPU 资源分配给第一个容器;当选择多 GPU 配置时,系统会为所有容器分配 GPU 资源。这种策略确保了资源分配的公平性和效率。在资源请求计算方面,系统采用统一的规则:计算完 limit 值后,request 值设置为 limit 除以 4,这种配置方式既保证了资源的有效利用,又避免了资源过度预留。
# 任务创建接口与多容器部署指南
## **1 任务创建接口**
[Section titled “1 任务创建接口”](#1-任务创建接口)
### **1.1 接口概述**
[Section titled “1.1 接口概述”](#11-接口概述)
任务创建接口是系统核心功能之一,用于创建和管理不同类型的计算任务。
接口参数文档位于:
任务创建接口的资源信息需要通过”显卡资源查询接口”获取(mark 标识)([https://s.apifox.cn/6aa360d3-d8f2-471e-b841-3a35c33a7b7c/api-296881020)。如果使用了不存在的资源类型(mark](https://s.apifox.cn/6aa360d3-d8f2-471e-b841-3a35c33a7b7c/api-296881020%EF%BC%89%E3%80%82%E5%A6%82%E6%9E%9C%E4%BD%BF%E7%94%A8%E4%BA%86%E4%B8%8D%E5%AD%98%E5%9C%A8%E7%9A%84%E8%B5%84%E6%BA%90%E7%B1%BB%E5%9E%8B%EF%BC%88mark) 标识),尽管接口会返回成功,GUI 面板上也能看到任务被成功创建,但是因为实际资源不存在,任务无法匹配到 GPU,Pod 不会被分配,亦不会扣费。
services 数组目前仅支持定义单个 service,因而,建议 service\_name 设置为和 task\_name 相同。实例名称只能是小写字母开头的(大小写字母,数字,中横线)。
### **1.2 多任务类型支持**
[Section titled “1.2 多任务类型支持”](#12-多任务类型支持)
接口现在支持两种主要的任务类型:
**Job 任务**:适用于一次性执行的任务,如批处理、数据处理、机器学习训练等场景。任务完成后 Pod 会自动终止,不会持续运行。
**Deployment 任务**:适用于长期运行的服务任务,如 Web 服务、API 服务、微服务等场景。支持自动重启、扩缩容和滚动更新。
## **2 配置示例**
[Section titled “2 配置示例”](#2-配置示例)
### **2.1 Job 任务示例**
[Section titled “2.1 Job 任务示例”](#21-job-任务示例)
```yaml
apiVersion: batch/v1
kind: Job
metadata:
creationTimestamp: null
name: pi
spec:
backoffLimit: 4
template:
metadata:
creationTimestamp: null
spec:
containers:
- image: harbor.suanleme.cn/huang5876/jupyter-tf1.15-gpu:v3.0
name: pi
resources:
limits:
cpu: 14000m
nvidia.com/gpu: 1
memory: 51200Mi
requests:
cpu: 1166m
nvidia.com/gpu: 1
memory: 2133Mi
- image: harbor.suanleme.cn/library/cuda:debugv4
name: pi2
resources:
limits:
cpu: 9333m
nvidia.com/gpu: 1
memory: 4200Mi
requests:
cpu: 2333m
nvidia.com/gpu: 1
memory: 10666Mi
restartPolicy: Never
status: {}
```
### **2.2 多容器 Deployment 任务示例**
[Section titled “2.2 多容器 Deployment 任务示例”](#22-多容器-deployment-任务示例)
```yaml
apiVersion: apps/v1
kind: Deployment
metadata:
creationTimestamp: null
labels:
app: d09231749-test11-12-pa5gknnq
gongjiyun.com/task-type: deployment
name: d09231749-test11-12-pa5gknnq
namespace: noxx7nxtak81hbk0lqbwsdv5etbjh8ei-12
spec:
replicas: 1
selector:
matchLabels:
app: d09231749-test11-12-pa5gknnq
strategy: {}
template:
metadata:
annotations:
proxy.istio.io/config: |
drainDuration: 120s
terminationDrainDuration: "120s"
holdApplicationUntilProxyStarts: true
quota.k8s.io/enabled: 'true'
quota.k8s.io/ephemeral-storage: 50Gi
quota.k8s.io/project-id: auto
sidecar.istio.io/rewriteAppHTTPProbers: 'false'
creationTimestamp: null
labels:
app: d09231749-test11-12-pa5gknnq
gongjiyun.com/task-type: deployment
spec:
affinity:
nodeAffinity:
preferredDuringSchedulingIgnoredDuringExecution:
- preference:
matchExpressions:
- key: kubernetes.io/role
operator: In
values:
- node
weight: 80
- preference:
matchExpressions:
- key: gongjiyun.com/can-be-used-develop
operator: NotIn
values:
- 'true'
weight: 20
requiredDuringSchedulingIgnoredDuringExecution:
nodeSelectorTerms:
- matchExpressions:
- key: nvidia.com/gpu.product
operator: In
values:
- NVIDIA-GeForce-RTX-4090
containers:
- image: harbor.suanleme.cn/library/fluentd:1.81
lifecycle:
preStop:
exec:
command:
- sleep
- '120'
name: d1758620954106-62013-container1
ports:
- containerPort: 7860
resources:
limits:
cpu: '28'
memory: 100Gi
nvidia.com/gpu: '1'
requests:
cpu: '7'
memory: 25Gi
volumeMounts:
- mountPath: /data
name: gjs3-00
- mountPath: /dev/shm
name: gj-shm-d09231749-test11-12-pa5gknnq
- image: harbor.suanleme.cn/library/nginx:v1.20
lifecycle:
preStop:
exec:
command:
- sleep
- '120'
name: d1758620954106-62013-container2
ports:
- containerPort: 80
resources:
limits:
cpu: '28'
memory: 1000Gi
nvidia.com/gpu: '1'
requests:
cpu: '7'
memory: 25Gi
volumeMounts:
- mountPath: /data
name: gjs3-00
- mountPath: /dev/shm
name: gj-shm-d09231749-test11-12-pa5gknnq
priorityClassName: default-pc
schedulerName: requested-to-capacity-ratio-custom-scheduler
volumes:
- name: gjs3-00
persistentVolumeClaim:
claimName: s3-12-47177-dataset
- emptyDir:
medium: Memory
sizeLimit: 80Mi
name: gj-shm-d09231749-test11-12-pa5gknnq
status: {}
```
## **3 多容器部署资源分配算法**
[Section titled “3 多容器部署资源分配算法”](#3-多容器部署资源分配算法)

### **3.1 CPU 资源分配机制**
[Section titled “3.1 CPU 资源分配机制”](#31-cpu-资源分配机制)
在多容器部署场景中,系统采用加权平均算法进行 CPU 资源分配。该算法确保每个容器按照其配置比例获得相应的 CPU 资源。
算法实现过程如下:首先计算所有容器的 CPU 配置总和,然后根据每个容器的配置占比,将实际机器的 CPU 核心数按比例分配给各个容器。例如,当第一个容器配置 14,000 微核,第二个容器配置 9,333 微核时,总和为 23,333 微核。
在实际分配过程中,假设选择 4090 卡(20 核)作为目标机器,系统会计算第一个容器的分配比例:14,000 ÷ 23,333 ≈ 60%,因此第一个容器将获得 20 核 × 60% = 12 核的 CPU 资源。
### **3.2 内存资源分配机制**
[Section titled “3.2 内存资源分配机制”](#32-内存资源分配机制)
内存分配采用总量计算和比例分配相结合的策略。系统首先汇总所有容器的内存配置需求,然后按照各容器的内存配置比例进行资源分配。
具体分配流程如下:以第一个容器内存配置 51,200 兆,第二个容器配置 4,200 兆为例,系统计算出总内存需求为 55,400 兆。随后,系统根据第一个容器的内存配置占比(51,200 ÷ 55,400 ≈ 92%)将目标机器的内存资源进行分配,假设目标机器内存为 101 G,则第一个容器将获得 101 G × 92% ≈ 93 G 的内存资源。
### **3.3 GPU 资源分配策略**
[Section titled “3.3 GPU 资源分配策略”](#33-gpu-资源分配策略)
GPU 资源分配采用优先级分配策略,确保关键任务能够优先获得 GPU 资源支持。
分配规则如下:当选择单 GPU 配置时,系统优先将 GPU 资源分配给第一个容器;当选择多 GPU 配置时,系统会为所有容器分配 GPU 资源。这种策略确保了资源分配的公平性和效率。
在资源请求计算方面,系统采用统一的规则:计算完 limit 值后,request 值设置为 limit 除以 4,这种配置方式既保证了资源的有效利用,又避免了资源过度预留。
## **4 任务类型与限制说明**
[Section titled “4 任务类型与限制说明”](#4-任务类型与限制说明)
### **4.1 Job 任务特性与限制**
[Section titled “4.1 Job 任务特性与限制”](#41-job-任务特性与限制)
Job 任务适用于一次性执行的批处理任务,如数据处理、模型训练等场景。任务完成后 Pod 会自动终止,不会持续占用资源。
Job 任务创建成功后具有以下特性:任务名称可以随时修改,支持任务暂停和重启功能,为用户提供了基本的任务管理能力。然而,Job 任务在创建后存在诸多不可修改的限制,包括高级设置、yaml 文件配置、共享内存设置、镜像地址、暴露端口配置以及节点数量等核心参数。
这些限制的存在主要基于 Job 任务的一次性执行特性,确保任务执行的稳定性和一致性。用户如需修改这些参数,需要重新创建任务实例。
### **4.2 Deployment 任务特性**
[Section titled “4.2 Deployment 任务特性”](#42-deployment-任务特性)
Deployment 任务适用于长期运行的服务场景,如 Web 服务、API 服务、微服务等。与 Job 任务相比,Deployment 任务具有更高的灵活性和可配置性。
Deployment 任务支持自动重启、扩缩容和滚动更新等高级功能,能够根据实际负载情况动态调整资源分配。更重要的是,Deployment 任务没有 Job 任务的那些修改限制,用户可以在任务运行过程中灵活调整各种配置参数,包括资源限制、端口配置、环境变量等。
这种灵活性使得 Deployment 任务特别适合需要持续运行和动态调整的服务场景,为用户提供了更加灵活的任务管理体验。
# 弹性部署服务推理性能调优
🦀
在弹性部署服务中,推理性能的优化是确保系统高效运行和用户体验的关键。尤其在深度学习服务中,如何确保硬件资源的高效利用,如何排查瓶颈,并选择最佳的配置,成为了优化过程中的重点。本文将详细介绍一系列的调优建议,帮助用户从硬件、软件、部署环境等多个层面提升推理性能。
## **1. 检查 GPU 是否实际被使用**
[Section titled “1. 检查 GPU 是否实际被使用”](#1-检查-gpu-是否实际被使用)
在深度学习推理任务中,GPU 的利用率至关重要。首先需要确认硬件是否被正确识别,并且能够支持 GPU 加速。
### **1.1 验证 GPU 可用性**
[Section titled “1.1 验证 GPU 可用性”](#11-验证-gpu-可用性)
要确认 GPU 硬件的可用性,可以通过以下命令检查:
```bash
nvidia-smi
lspci | grep -i nvidia
nvidia-smi --query-gpu=driver_version --format=csv
```
`nvidia-smi` 命令会列出当前 GPU 的详细信息,如内存、驱动版本、GPU 利用率等。`lspci` 命令帮助确认 NVIDIA 硬件是否被系统识别。
### **1.2 在代码中验证 GPU 使用**
[Section titled “1.2 在代码中验证 GPU 使用”](#12-在代码中验证-gpu-使用)
通过深度学习框架(如 PyTorch 和 TensorFlow)验证代码是否正确使用 GPU:
```py
import torch
import tensorflow as tf
print(f"PyTorch 版本:{torch.__version__}")
print(f"CUDA 可用:{torch.cuda.is_available()}")
print(f"GPU 数量:{torch.cuda.device_count()}")
if torch.cuda.is_available():
print(f"当前 GPU: {torch.cuda.get_device_name(0)}")
print(f"GPU 内存:{torch.cuda.get_device_properties(0).total_memory / 1024**3:.2f} GB")
print(f"TensorFlow 版本:{tf.__version__}")
print(f"GPU 设备列表:{tf.config.list_physical_devices('GPU')}")
```
上述代码会检查是否有 GPU 可用,并显示 GPU 的型号和内存。
### **1.3 运行时 GPU 使用监控**
[Section titled “1.3 运行时 GPU 使用监控”](#13-运行时-gpu-使用监控)
要实时监控 GPU 的使用情况,可以使用以下工具:
```bash
nvidia-smi -l 1
nvidia-smi pmon -i 0
pip install gpustat
gpustat -i 1
```
`nvidia-smi -l 1` 命令会以 1 秒的间隔持续显示 GPU 的实时状态,而 `gpustat` 提供了更易于理解的 GPU 状态输出。
## **2. 尝试更换高性能 GPU,确认性能瓶颈是否与 GPU 硬件相关**
[Section titled “2. 尝试更换高性能 GPU,确认性能瓶颈是否与 GPU 硬件相关”](#2-尝试更换高性能-gpu确认性能瓶颈是否与-gpu-硬件相关)
在进行推理优化时,如果 GPU 利用率低或性能不理想,可能是硬件的性能瓶颈。为了验证这一点,可以通过以下基准测试来评估不同 GPU 的性能。
### **2.1 GPU 性能对比测试**
[Section titled “2.1 GPU 性能对比测试”](#21-gpu-性能对比测试)
使用矩阵乘法来测试 GPU 的计算性能:
```py
import torch
import time
import numpy as np
def gpu_benchmark():
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
# 测试矩阵乘法性能
sizes = [1000, 2000, 4000, 8000]
for size in sizes:
a = torch.randn(size, size).to(device)
b = torch.randn(size, size).to(device)
# 预热
for _ in range(10):
torch.matmul(a, b)
# 性能测试
start_time = time.time()
for _ in range(100):
torch.matmul(a, b)
torch.cuda.synchronize()
end_time = time.time()
print(f"矩阵大小 {size}x{size}: {(end_time - start_time) * 1000:.2f}ms")
gpu_benchmark()
```
通过测试不同矩阵大小的乘法,可以大致了解 GPU 的计算能力,并帮助确认是否需要更换更高性能的 GPU。
## **3. 尝试根据显卡驱动版本更换 CUDA、cuDNN 和 PyTorch 等版本**
[Section titled “3. 尝试根据显卡驱动版本更换 CUDA、cuDNN 和 PyTorch 等版本”](#3-尝试根据显卡驱动版本更换-cudacudnn-和-pytorch-等版本)
不同的 GPU 驱动版本和框架版本可能会对性能产生较大影响。为了确保系统能够充分利用硬件资源,需要保证 CUDA、cuDNN 与 PyTorch 版本的兼容性。
### **3.1 版本兼容性检查**
[Section titled “3.1 版本兼容性检查”](#31-版本兼容性检查)
使用以下命令检查当前驱动和框架版本:
```bash
nvidia-smi
nvcc --version
python -c "import torch; print(torch.__version__); print(torch.version.cuda)"
python -c "import torch; print(torch.backends.cudnn.version())"
```
官方的版本兼容性矩阵可以帮助我们确定各个版本的兼容性,避免不兼容导致的性能问题。
* [PyTorch 版本兼容性](https://github.com/pytorch/pytorch/wiki/PyTorch-Versions#domain-version-compatibility-matrix-for-pytorch)
* [CUDA 兼容性文档](https://docs.nvidia.com/cuda/cuda-toolkit-release-notes/index.html)
* [CUDA Toolkit 12.9 Update 1 - Release Notes — Release Notes 12.9 documentation](https://docs.nvidia.com/cuda/cuda-toolkit-release-notes/index.html#cuda-driver)
* [Supported Products — NVIDIA cuDNN Frontend](https://docs.nvidia.com/deeplearning/cudnn/frontend/v1.12.0/reference/support-matrix.html#support-matrix)
## **4. 尝试更换基础镜像,手动部署**
[Section titled “4. 尝试更换基础镜像,手动部署”](#4-尝试更换基础镜像手动部署)
容器化部署可以极大简化环境管理和服务的扩展性。根据不同的需求,选择合适的基础镜像非常重要。不同的镜像会影响运行时的性能,以下是几种常见的选择策略。
### **4.1 基础镜像选择策略**
[Section titled “4.1 基础镜像选择策略”](#41-基础镜像选择策略)
#### **4.1.1 官方 PyTorch 镜像**
[Section titled “4.1.1 官方 PyTorch 镜像”](#411-官方-pytorch-镜像)
```docker
FROM pytorch/pytorch:2.7.0-cuda12.6-cudnn9-devel
```
这个镜像包含了官方提供的 PyTorch 框架,并预装了 CUDA 和 cuDNN 加速库,适合大多数深度学习应用。
#### **4.1.2 NVIDIA 官方 CUDA 镜像**
[Section titled “4.1.2 NVIDIA 官方 CUDA 镜像”](#412-nvidia-官方-cuda-镜像)
```docker
FROM nvidia/cuda:12.6.3-cudnn-devel-ubuntu22.04
```
此镜像提供了 NVIDIA 官方优化的 CUDA 运行时环境,更适合需要高度自定义配置的用户。
#### **4.1.3 轻量级 Ubuntu 镜像**
[Section titled “4.1.3 轻量级 Ubuntu 镜像”](#413-轻量级-ubuntu-镜像)
```docker
FROM ubuntu:20.04
```
适合需要手动安装依赖并高度定制环境的场景。
相关镜像连接:
* [ubuntu - Official Image | Docker Hub](https://hub.docker.com/_/ubuntu)
* [nvidia/cuda - Docker Image | Docker Hub](https://hub.docker.com/r/nvidia/cuda)
* [pytorch/pytorch - Docker Image | Docker Hub](https://hub.docker.com/r/pytorch/pytorch/)
* [tensorflow/tensorflow - Docker Image | Docker Hub](https://hub.docker.com/r/tensorflow/tensorflow)
### **4.2 多阶段构建优化**
[Section titled “4.2 多阶段构建优化”](#42-多阶段构建优化)
为了减少镜像的大小,可以使用多阶段构建来优化镜像内容:
```docker
FROM python:3.9-slim as builder
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
FROM nvidia/cuda:11.8-runtime-ubuntu20.04
WORKDIR /app
COPY --from=builder /usr/local/lib/python3.9/site-packages /usr/local/lib/python3.9/site-packages
COPY . .
CMD ["python", "inference_server.py"]
```
通过分阶段构建,可以确保运行环境只包含必要的文件,从而减少镜像的体积。
## **5. 使用 vmstat、glances 和 nvidia-smi 等工具监控系统资源**
[Section titled “5. 使用 vmstat、glances 和 nvidia-smi 等工具监控系统资源”](#5-使用-vmstatglances-和-nvidia-smi-等工具监控系统资源)
监控工具能够帮助你实时获取系统和 GPU 的资源使用情况,帮助快速发现性能瓶颈。
### **5.1 系统监控工具使用**
[Section titled “5.1 系统监控工具使用”](#51-系统监控工具使用)
以下工具可以帮助你获取 CPU、内存、磁盘 I/O、网络等多方面的资源使用情况:
```bash
apt-get install -y htop glances atop iotop nethogs sysstat
glances
vmstat 1
htop
iotop -o
iostat -x 1
nethogs
netstat -tulnp
sar -u 1 10 # CPU使用率
sar -r 1 10 # 内存使用率
sar -d 1 10 # 磁盘I/O
```

这些工具能够帮助你监控到各个硬件资源的使用情况,及时发现潜在的性能瓶颈。
### **5.2 GPU 监控脚本**
[Section titled “5.2 GPU 监控脚本”](#52-gpu-监控脚本)
编写自定义 GPU 监控脚本,实时跟踪 GPU 的使用情况:
```bash
#!/bin/bash
nvidia-smi dmon -i 0 -s pucvmet -d 1
nvidia-smi --query-gpu=timestamp,name,driver_version,temperature.gpu,utilization.gpu,utilization.memory,memory.total,memory.free,memory.used --format=csv -l 1
nvidia-smi pmon -i 0 -s m
```
## **6. 使用 PyTorch Profiler 进行模型性能分析**
[Section titled “6. 使用 PyTorch Profiler 进行模型性能分析”](#6-使用-pytorch-profiler-进行模型性能分析)
`PyTorch Profiler` 是一个强大的工具,能够帮助你深入分析模型的性能瓶颈。通过该工具,你可以获得有关模型推理过程中的详细 CPU、GPU 利用情况、内存占用、每个操作的执行时间等信息。
### **6.1 基础性能分析**
[Section titled “6.1 基础性能分析”](#61-基础性能分析)
```py
import torch
import torch.profiler
from torch.profiler import profile, record_function, ProfilerActivity
def model_profiling(model, input_data):
with profile(
activities=[ProfilerActivity.CPU, ProfilerActivity.CUDA],
record_shapes=True,
with_stack=True,
with_flops=True
) as prof:
with record_function("model_inference"):
output = model(input_data)
# 打印性能报告
print(prof.key_averages().table(sort_by="cuda_time_total", row_limit=10))
# 导出 Chrome 跟踪文件
prof.export_chrome_trace("trace.json")
return output
```
### **6.2 详细性能分析**
[Section titled “6.2 详细性能分析”](#62-详细性能分析)
```py
import torch
import torch.nn as nn
from torch.profiler import profile, ProfilerActivity
class DetailedProfiler:
def __init__(self, model):
self.model = model
def profile_inference(self, input_data, warmup_steps=10, profile_steps=100):
# 预热
for _ in range(warmup_steps):
with torch.no_grad():
_ = self.model(input_data)
# 性能分析
with profile(
activities=[ProfilerActivity.CPU, ProfilerActivity.CUDA],
record_shapes=True,
with_stack=True,
with_flops=True,
with_modules=True
) as prof:
for _ in range(profile_steps):
with torch.no_grad():
_ = self.model(input_data)
return prof
def analyze_results(self, prof):
# 按 CUDA 时间排序
print("=== 按 CUDA 时间排序 ===")
print(prof.key_averages().table(sort_by="cuda_time_total", row_limit=20))
# 按 CPU 时间排序
print("\n=== 按 CPU 时间排序 ===")
print(prof.key_averages().table(sort_by="cpu_time_total", row_limit=20))
# 按内存使用排序
print("\n=== 按内存使用排序 ===")
print(prof.key_averages().table(sort_by="cuda_memory_usage", row_limit=20))
# 导出详细报告
prof.export_chrome_trace("detailed_trace.json")
# 按模块分组分析
print("\n=== 按模块分组 ===")
print(prof.key_averages(group_by_stack_n=1).table(sort_by="cuda_time_total", row_limit=20))
```
### **6.3 内存分析**
[Section titled “6.3 内存分析”](#63-内存分析)
```py
import torch
import torch.profiler
def memory_profiling(model, input_data):
# 启用内存分析
torch.cuda.memory._record_memory_history(True)
with torch.profiler.profile(
activities=[torch.profiler.ProfilerActivity.CPU, torch.profiler.ProfilerActivity.CUDA],
with_stack=True,
profile_memory=True,
record_shapes=True
) as prof:
output = model(input_data)
# 保存内存快照
torch.cuda.memory._dump_snapshot("memory_snapshot.pickle")
# 分析内存使用
print("=== 内存使用分析 ===")
print(prof.key_averages().table(sort_by="cuda_memory_usage", row_limit=10))
return output
```
通过这些分析,您可以深入了解模型在推理过程中每个操作的资源消耗,并进行针对性优化。
# 弹性扩缩容-FIFO 队列最佳实践
## 适用场景
[Section titled “适用场景”](#适用场景)
* **服务端处理能力受限,不支持并发处理多个请求**,同一时间只能执行一个任务。
* **需要保证请求严格按照到达顺序进行处理(FIFO)**,避免请求乱序执行导致的数据一致性或业务逻辑问题。
* **需要根据业务负载动态调整任务节点数量,**在资源成本与系统处理能力之间实现平衡**。**
## 快速上手
[Section titled “快速上手”](#快速上手)
### 1.环境准备
[Section titled “1.环境准备”](#1环境准备)
需要准备一个带宽充足的云服务器,安装好 docker 环境。
> 如果只是本地测试使用,则不需要云服务器,只需要在本地安装好 docker 环境即可。
### 2.配置文件填写
[Section titled “2.配置文件填写”](#2配置文件填写)
完整的配置文件如下:
```json
{
"openapi_base_url": "https://openapi.suanli.cn", //共绩域名,固定
"token": "", // 用户密钥,用于调用共绩云 API 增减节点
"min_nodes": 1, //节点池最少保留的节点数,即使空闲也不会缩容到该值以下。可设为 `0`:允许缩容到 0,启动时不预创建任务,有请求时再冷启动。
"max_nodes": 3, //节点池最多允许创建的节点数,扩容时不会超过该上限。
"max_scale_down_nodes": 1, //单次缩容最多同时关闭的节点数,避免一次性关闭过多节点。
"scale_down_cooldown_secs": 180, // 两次缩容之间的最小间隔,避免短时间内反复关闭节点。
"queue_scale_wait_secs": 120, //请求队列超过阈值后,需要持续等待的秒数才触发扩容。
"queue_scale_count_threshold": 10, //触发扩容的队列长度阈值。
"idle_shutdown_secs": 180, //节点连续空闲超过该秒数后,会被关闭以释放资源。
"scale_up_cooldown_secs": 30, //两次扩容之间的最小间隔,避免短时间内反复创建节点。
"node_refresh_interval_secs": 15, //刷新节点状态的时间间隔。
"scale_check_interval_secs": 5, //检查是否需要扩缩容的时间间隔。
"stats_log_interval_secs": 15, //输出统计日志的时间间隔。
"proxy_port": 3000, //实际需要代理转发请求的容器端口,例如 3000。
"health_check_path": "/ready", //健康检查(就绪)接口路径,用于判断节点是否可用。
"scale_up_request": { //调用上游 API 创建新节点时的请求模板
"task_name": "gjtest-comfyui", //创建任务使用的任务名称前缀,不支持下划线(_),注意同账号下以该任务名称开头的任务,均将视为同一组任务节点池,会受本程序管控。
"points": 1, //创建的任务内有多少个节点,固定 1 个、便于本程序调度。
"resources": [
{
"mark": "" // `mark` 标识一组资源配额,可以通过分析控制台 search 接口返回值查找其它区的 mark 值。
}
],
"services": [ // 节点中运行的服务列表(容器配置信息)。
{
"service_name": "container-01", //服务名称。
"service_image": "", //服务使用的容器镜像。
"remote_ports": [ //服务对外暴露的端口列表。
{
"service_port": 3000
},
{
"service_port": 8188
}
],
"start_script_v2": { //服务启动参数与命令。
"args": [],
"command": null
},
"storage_config": [ //服务挂载的存储配置。可为空
{
"storage_id": 2451,
"target_dir": "/opt/ComfyUI/models"
}
]
}
]
}
}
```
大多数配置默认值即可满足需求,需要重点关注的配置为:
* token:用户 token,可在平台控制台获取
* min\_nodes:最小节点数
* max\_nodes:最大节点数
* proxy\_port:该服务需要被转发的端口
* health\_check\_path:该服务提供的健康监测路径,只有该路径返回状态码 200 时,才认为该任务可用、才会被转发请求
* scale\_up\_request:创建任务的配置
* mark:创建任务使用的资源配额标识。
### 3.部署服务
[Section titled “3.部署服务”](#3部署服务)
```py
docker run -d -v [配置文件]:/app/config.json -p 8080:8080 harbor.suanleme.cn/vm/gj_proxy:v0.6
```
注意将命令中的中文替换为正确的文件路径。
部署成功后,所有打入该服务的流量将进入排队,只有当后端任务处于空闲时、才会将请求转发给该任务进行处理,保证后端每个任务最多同时只会接收到一个请求。
## 原理
[Section titled “原理”](#原理)
### 1.架构
[Section titled “1.架构”](#1架构)
本服务会对请求进行排队,所有进入的用户流量都会先进入队列,等待后端任务空闲,保证每个后端任务同一时间只处理一个用户请求。
### 2.扩缩容规则
[Section titled “2.扩缩容规则”](#2扩缩容规则)
#### 扩容规则
[Section titled “扩容规则”](#扩容规则)
1. **触发条件**:当请求队列非空,且满足以下任一条件时触发扩容:
* **冷启动**:当前无节点且无创建中任务(`min_nodes=0` 缩容到 0 后,或启动时未预创建);
* **等待触发**:队列中最久的请求等待时间达到 `queue_scale_wait_secs` 秒;
* **数量触发**:队列长度超过 `queue_scale_count_threshold`。
2. **冷却限制**:如果距上次扩容时间不足 `scale_up_cooldown_secs` 秒,跳过本次扩容,避免短时间内反复创建节点。冷启动不受此冷却限制。
3. **上限保护**:扩容后的总节点数(当前就绪节点 + 正在创建中的节点 + 本次新增节点)不能超过 `max_nodes`。如果当前节点数加上正在创建的节点数已达 `max_nodes`,则本次扩容不会执行。
4. **扩容数量**:本次扩容数量取 `max(队列长度 / 2, 1)`,并同时受 `max_nodes` 剩余可用槽位限制;如果计算值大于可用槽位,则按可用槽位扩容。
#### 缩容规则
[Section titled “缩容规则”](#缩容规则)
1. **触发条件**:当节点池中存在满足以下条件的节点时,会被列为缩容候选:
* 请求队列为空(有排队请求时不缩容);
* 节点当前处于空闲状态(没有正在处理的请求);
* 该节点最近一次处理完请求后,空闲时间已超过 `idle_shutdown_secs` 秒。
2. **冷却限制**:如果距上次缩容时间不足 `scale_down_cooldown_secs` 秒,跳过本次缩容,避免频繁关闭节点。
3. **下限保护**:就绪节点数必须至少保留 `min_nodes` 个,即使这些节点空闲也不会被缩容。程序只会缩容“超出 `min_nodes` 数量的就绪节点”。`min_nodes=0` 时允许缩容到 0。未就绪的空闲节点在达到下限时仍可被清理。
4. **单次上限**:每次缩容最多关闭 `max_scale_down_nodes` 个节点,避免一次性关闭过多节点导致服务能力骤降。
5. **优先顺序**:优先缩容最早进入空闲状态的节点(按节点最近一次处理请求的时间 `last_processed` 从早到晚排序)。
# 常见问题
# 弹性部署常见问题
## 平台使用
[Section titled “平台使用”](#平台使用)
### 怎么计费的?
[Section titled “怎么计费的?”](#怎么计费的)
按量(使用时长)计费,精确到秒。镜像上传拉取过程不收费,服务成功部署后再计费 卡时单价、机型详见:
### 如何实现弹性扩缩容?
[Section titled “如何实现弹性扩缩容?”](#如何实现弹性扩缩容)
支持随时根据服务负载情况修改 GPU 数量。设置办法:
1. 服务部署阶段,选择合适的节点数量(推荐先选一个,后续再根据需要随时添加)
2. 在对应服务页面,点击左侧边栏的【设置】,修改服务运行的节点数量。节点越多,性能越好,但也会增加成本
3. 通过 API 控制,API 文档:
### 什么是 Serverless 与无状态?为什么不提供 SSH?
[Section titled “什么是 Serverless 与无状态?为什么不提供 SSH?”](#什么是-serverless-与无状态为什么不提供-ssh)
本系统采用 Serverless 无状态部署方式。默认情况下,平台不会对历史状态及数据进行存储。这具体体现在:
1. 无状态运行:服务实例会随负载变化动态创建或销毁。一旦容器因缩容、重启或调度迁移而释放,所有运行期间产生的临时文件、手动安装的依赖、终端命令修改的配置均会即刻且永久丢失。
2. 无 SSH / 无页面终端:正是基于上述无状态设计,平台不提供 SSH 登录权限及持久化的页面终端。您需要在制作镜像时,将启动命令写入 `CMD` 或 `ENTRYPOINT`;调试主要依赖控制台的【服务日志】查看标准输出。
3. 适用场景:该部署方式更适用于推理场景,上线后能高效响应生产请求。对于训练及科学计算研发等需要频繁交互、保存中间状态的需求,请依据实际情况判断是否适用。
### 弹性部署与其他平台的容器实例(或虚拟机)有什么区别?
[Section titled “弹性部署与其他平台的容器实例(或虚拟机)有什么区别?”](#弹性部署与其他平台的容器实例或虚拟机有什么区别)
1. 我们并未采用直接租赁实例这一常规方式,而是基于系统负载均衡机制,为用户动态的节点分配策略。在此过程中,流量自特定来源汇聚,随后被导向不同的目的地。

2. 容器实例或虚拟机在关机后,存在一段数据保留期。然而,弹性部署的容器在关机后会即刻释放数据,并无数据保留情况。
## 部署阶段
[Section titled “部署阶段”](#部署阶段)
### 拉取镜像时间长,不知道拉取完了没
[Section titled “拉取镜像时间长,不知道拉取完了没”](#拉取镜像时间长不知道拉取完了没)
根据镜像的规模大小,首次拉取或许会耗费一定的下载时长。您能够查看节点详情中的事件记录,确认是否存在拉取镜像的相关事件。若长时间未能成功拉取,且事件呈现异常状态,建议您与技术人员取得联系,以便他们为您进行排查与处理。
### 快捷访问点开后域名链接报错
[Section titled “快捷访问点开后域名链接报错”](#快捷访问点开后域名链接报错)
> upstream connect error or disconnect/reset before headers. retried and the latest reset reason: remote connection failure, transport failure reason: delayed connect error: Connection refused
当前域名解析可能尚未生效。请等待数秒后,刷新页面并再次尝试。

### 为什么发任务不能超过 10 个节点?
[Section titled “为什么发任务不能超过 10 个节点?”](#为什么发任务不能超过-10-个节点)
为防止平台被滥用,我们针对每个账号设定了基础限制。若需提高上限,请与我们的销售团队进行沟通。
### 点击快捷访问端口后出现`no healthy upstream`
[Section titled “点击快捷访问端口后出现no healthy upstream”](#点击快捷访问端口后出现no-healthy-upstream)

该错误表明 API 网关或负载均衡器无法找到可用的健康后端服务实例来处理请求。
解决措施:
1. 检查后端服务状态
* **确认服务是否运行**
* **查看服务日志**:通过日志定位崩溃原因
1. 验证健康检查配置
* **检查健康检查接口**
* **调整健康检查参数:**在网关配置中增加健康检查的超时时间或重试次数(避免因短暂延迟误判)
### Huggingface 下载太慢了怎么办?
[Section titled “Huggingface 下载太慢了怎么办?”](#huggingface-下载太慢了怎么办)
鉴于 Hugging Face 服务器位于海外,而我们自身的服务器处于国内环境。建议您参照以下文章内容,对 Hugging Face 加速代理源进行配置。完成配置后,即可实现模型的高速下载。
# 使用说明
# 跨区域调度功能说明
### 一、功能概述
[Section titled “一、功能概述”](#一功能概述)
跨区域调度功能用于解决目标区域内卡型资源不足导致服务无法部署的问题。开启该功能后,当系统检测到当前所选区域的指定卡型资源不可用时,将自动从其他符合条件的区域中调度资源进行部署,从而提高部署成功率,保障业务连续性。
### 二、适用场景
[Section titled “二、适用场景”](#二适用场景)
* 所选区域卡型资源紧张或临时不可用
* 对部署时效性要求较高,希望避免因资源不足导致部署失败
* 业务对物理区域不敏感,可接受实例部署在其他区域
### 三、功能限制说明
[Section titled “三、功能限制说明”](#三功能限制说明)
* 跨区域调度部署的实例**不支持配置存储资源**
* 实例的**最终计费价格以实际调度到的区域为准**,可能与原选择区域存在差异
* 实例所在区域可能与最初选择的区域不一致,请以部署结果为准
### 四、演示流程
[Section titled “四、演示流程”](#四演示流程)
以下流程用于演示跨区域调度功能的典型使用过程:
1. **开启跨区域调度功能** 勾选「跨区域调度」选项。

1. **选择部署区域与卡型** 在服务创建页面,选择优先部署区域及所需卡型资源。
2. **提交部署请求** 完成其他必要配置后,提交服务部署请求。
3. **系统自动检测资源情况**
* 若所选区域卡型资源充足,服务将在当前区域直接部署
* 若所选区域卡型资源不足,系统将自动触发跨区域调度机制
4. **跨区域资源调度与部署** 系统从其他可用区域中选择符合条件的区域完成实例部署。
5. **查看部署结果** 部署完成后,可在任务详情页查看:
* 实际部署区域
* 实例规格与卡型信息
* 对应的计费信息
### 五、注意事项
[Section titled “五、注意事项”](#五注意事项)
* 建议在对区域无强约束的业务场景中启用该功能
* 若业务依赖本地存储或固定区域资源,请谨慎开启
* 部署完成后请及时核对实例区域及费用信息,避免预期偏差
# 镜像预热功能说明
## 一、概述
[Section titled “一、概述”](#一概述)
镜像预热功能支持将指定镜像从镜像仓库提前同步至集群 harbor 分站或集群内相应节点的本地缓存。当弹性服务部署任务启动或触发弹性扩容时,可直接从集群 harbor 分站或集群内节点本地缓存加载镜像,避免从远端拉取,提升启动性能并优化扩容响应时间。
## 二、适用场景
[Section titled “二、适用场景”](#二适用场景)
镜像预热功能紧密适配弹性部署服务场景,核心优势集中在加速业务启动、应对弹性扩容、适配灵活业务需求等方面:
1. **助力秒级冷启动,应对流量高峰**:这是其核心优势之一。该功能可提前将镜像推送至目标节点,大幅减少容器启动时的镜像拉取耗时,最终实现秒级冷启动效果。这一特性能让业务快速响应请求,即便面对 AI 推理等场景的流量高峰,也可避免因镜像拉取慢导致的业务延迟,保障服务稳定性。
2. **适配灵活业务场景**:系统提供的镜像预热并非单一功能,而是与弹性扩缩容等能力形成协同。比如对应弹性扩容,在镜像预热基础上,能够通过整合分散在不同地点的计算资源,实现资源虚拟化按需分配,满足用户在不同地域、不同部署环境下的动态扩展需求,同时提升了整体运维效率。
3. **操作适配性强,降低使用门槛**:从使用体验来看,用户可提前联系平台完成镜像到节点的预热操作,流程简洁直接。这种适配其弹性部署服务的专属预热支持,无需用户部署复杂的额外组件,对于租用系统提供的计算资源开展业务的用户来说,能快速上手使用,减少了镜像管理的技术成本,尤其适合非专业运维人员的使用需求。
## 三、功能限制
[Section titled “三、功能限制”](#三功能限制)
本功能属于邀测阶段,**如需使用邀测功能,请联系客户经理**
## 四、演示流程
[Section titled “四、演示流程”](#四演示流程)
以下流程用于演示镜像预热功能的典型使用过程:
### 1、在弹性部署服务页面新增镜像预热功能。
[Section titled “1、在弹性部署服务页面新增镜像预热功能。”](#1在弹性部署服务页面新增镜像预热功能)
* 点击“创建预热任务”按钮创建镜像预热任务。

* 填写预热任务名称
* 选择自定义镜像
* 选择预热方式:“预热到集群”(需要选择集群)或“预热到节点”(以下流程适用)
 
* 选择集群和 GPU 卡型
* 按需勾选是否开启跨区域调度
* 填写期望节点数量
1. 期望节点数可以限制关联的弹性部署服务或 Job 批处理任务使用的总节点数(其和不得超该数量)。
2. 调整期望节点数时,不能低于正在运行的任务总节点数。
3. 部署任务时,当节点数上限超过期望节点数时,未超出的那部分节点可秒级启动。
点击“确认”,生成一条新的镜像预热任务。

### 2、镜像预热任务进行
[Section titled “2、镜像预热任务进行”](#2镜像预热任务进行)
等待一段时间后(后台需要下载镜像,下载时间跟镜像大小有关。测试一个 20GB 的镜像大约需要 30 分钟,实际需要时间取决于当时网络情况,可能时间会更长),预热状态变为“预热中”。通过“节点预热状态”可以观察预热进度。其中,“使用中 / 可用 / 期望值”分别表示已使用该预热镜像部署任务的节点数、可继续使用该预热镜像部署的节点数、期望预热节点数。

随着预热任务进行,“可用”节点数会逐渐增加,直到达到期望值。

### 3、使用该预热镜像创建新的弹性部署服务任务
[Section titled “3、使用该预热镜像创建新的弹性部署服务任务”](#3使用该预热镜像创建新的弹性部署服务任务)
对预热中的镜像,可以使用该镜像在预热所选区域创建新的弹性部署服务任务,在“扩缩容策略”的节点数配置不超过“可用”节点数的情况下,这些节点无需下载镜像,可秒级启动。

此时预热任务的“节点预热状态”中的“使用中”节点数会相应更新。

### 4、修改节点数
[Section titled “4、修改节点数”](#4修改节点数)
当您需要增加或减少镜像预热任务节点数时,可以通过预热任务“操作”栏中的“修改节点数”按钮修改期望预热节点数。

### 5、删除任务
[Section titled “5、删除任务”](#5删除任务)
当您不再需要该镜像预热任务时,可以通过预热任务“操作”栏中的“删除任务”按钮删除该任务。

# 创建多容器部署任务功能说明
## 一、概述
[Section titled “一、概述”](#一概述)
本功能是弹性部署服务的核心扩展能力,支持用户通过产品化 UI 界面或 API 接口,快速创建、管理多容器 Pod 任务,无需依赖 YAML 文件手动配置。
## 二、适用场景
[Section titled “二、适用场景”](#二适用场景)
本功能适配 AI 算力等多场景业务需求,实现多容器间共享存储、数据互通、资源精细化分配,同时可与镜像预热功能协同,保障多容器 Pod 任务秒级启动与弹性扩缩容稳定性,解决传统多容器部署门槛高、日志采集侵入业务、弹性扩缩日志易丢失等痛点。
## 三、演示流程
[Section titled “三、演示流程”](#三演示流程)
1、创建弹性部署服务,“服务配置”选择“自定义服务”时,可以打开“多容器任务”开关,添加多个容器,为每个容器配置镜像、端口、环境变量、启动命令等

2、多容器资源配置

为多容器配置节点资源分配,包括 CPU 限额、内存限额和 GPU 数量。
CPU 限额和内存限额会根据资源权重进行分配。例如,对 CPU 限额,当第一个容器配置 28(权重),第二个容器配置 4(权重)时,权重总和为 32。在实际分配过程中,假设选择 4090 卡(24 核)作为目标机器,系统会计算第一个容器的分配比例:28 ÷ 32 = 87.5%,第一个容器的分配比例:4 ÷ 32 = 12.5%。因此第一个容器将获得 24 核 × 87.5% = 21 核的 CPU 资源,第二个容器将获得 24 核 × 12.5% = 3 核的 CPU 资源。
GPU 卡数分配需保证为整数卡。
3、临时共享存储 emptyDir 配置。
emptyDir 是 k8s 中**Pod 级别的临时共享存储**—— 它会在 Pod 被调度到节点上时自动创建,目录初始为空,Pod 内的所有容器都可以读写这个目录里的文件;当 Pod 被删除(比如重启、调度走、删除)时,emptyDir 里的所有数据会被永久清除。

点击“新增挂载”,选择目标容器,输入存储卷名称和挂载路径,可以给多个不同容器挂载临时共享存储 emptyDir。

部署完成后,可在任务详情页管理多容器任务的任务配置和容器配置。
# 如何使用自动弹性扩缩容
## **1. 功能概述**
[Section titled “1. 功能概述”](#1-功能概述)
弹性扩缩容是共绩算力平台的核心功能,能够根据任务队列状态和资源使用情况自动调整计算实例数量,在保证用户体验的同时优化成本效率。通过智能监控,系统可以自动扩容应对高负载,在负载降低时自动缩容节省成本。

## **2. 功能优势**
[Section titled “2. 功能优势”](#2-功能优势)
* 成本优化
* 性能保障
* 操作简便
## **3. 使用流程**
[Section titled “3. 使用流程”](#3-使用流程)
### **3.1 参数设置建议**
[Section titled “3.1 参数设置建议”](#31-参数设置建议)
**最小节点数**:建议设置为 1,避免冷启动影响。如果业务对响应时间要求极高,可以适当增加。
**最大节点数**:根据预算和业务峰值合理设置。建议先从小值开始,观察实际使用情况后逐步调整。
**队列延迟阈值**:建议设置为 4-10 秒,平衡成本和体验。对于实时性要求高的任务,可以设置较小值。
**空闲超时时间**:建议设置为 300-600 秒,减少冷启动影响的同时控制成本。
### **3.2 创建任务时配置**
[Section titled “3.2 创建任务时配置”](#32-创建任务时配置)
在 弹性部署服务 任务创建页面,您可以在「扩缩容策略」配置模块中设置扩缩容策略。系统提供两种主要策略供您选择:延迟策略(基于等待时间)和计数策略(基于排队数量)。

### **3.3 任务运行中调整**
[Section titled “3.3 任务运行中调整”](#33-任务运行中调整)
任务创建后,您可以在任务详情页面通过「修改扩缩容策略」入口动态调整策略参数,无需重启任务即可生效。

### **3.4 实时监控**
[Section titled “3.4 实时监控”](#34-实时监控)
系统提供 24 小时扩缩容趋势图表,以半小时为颗粒度展示节点数量变化,帮助您了解资源使用情况。

## **4. 策略配置详解**
[Section titled “4. 策略配置详解”](#4-策略配置详解)
### **4.1 延迟策略(基于等待时间)**
[Section titled “4.1 延迟策略(基于等待时间)”](#41-延迟策略基于等待时间)

队列延迟策略基于任务队列的等待时间进行扩缩容决策,适合大多数 AI 推理和批处理任务场景。
#### **4.1.1 基本参数配置**
[Section titled “4.1.1 基本参数配置”](#411-基本参数配置)
**最小节点数**:系统保持的最小节点数量,建议设置为 1,避免冷启动影响。默认值:1,最小值:1,最大值:租户剩余可用 Pod 数。
**最大节点数**:自动扩容的节点数量上限,用于控制成本。应根据预算和业务峰值合理设置,不能小于最小节点数。默认值:10,最小值:1,最大值:租户剩余可用 Pod 数。
#### **4.1.2 队列延迟策略专用参数**
[Section titled “4.1.2 队列延迟策略专用参数”](#412-队列延迟策略专用参数)

**队列延迟阈值**:队列平均等待时间超过此值触发扩容。过小会频繁扩容增加成本,过大会影响用户体验。最小值:1 秒。
**队列监听端口**:队列服务监听端口号,用于接收任务请求。建议使用非特权端口避免权限问题。范围:1-65535。
**空闲超时时间**:无活跃请求时节点继续运行的最长时间。过短会增加冷启动,过长会增加成本。默认值:300 秒,最小值:1 秒。
**单节点最大并发**:每个节点同时处理的最大请求数。默认值:1,最小值:1。
**执行超时时间**:单个作业允许的最长执行时间,防止异常任务占用资源。默认值:600 秒,最小值:30 秒,最大值:86400 秒(24 小时)。
### 4.2 计数策略(基于排队数量)
[Section titled “4.2 计数策略(基于排队数量)”](#42-计数策略基于排队数量)

**请求计数阈值:**队列等待请求数超过此值触发扩容,适用于请求计数策略。最小值:1。
**队列监听端口**:队列服务监听端口号,用于接收任务请求。建议使用非特权端口避免权限问题。范围:1-65535。
**空闲超时时间**:无活跃请求时节点继续运行的最长时间。过短会增加冷启动,过长会增加成本。默认值:300 秒,最小值:1 秒。
**单节点最大并发**:每个节点同时处理的最大请求数。默认值:1,最小值:1。
**执行超时时间**:单个作业允许的最长执行时间,防止异常任务占用资源。默认值:600 秒,最小值:30 秒,最大值:86400 秒(24 小时)。
## **5. 负载均衡策略**
[Section titled “5. 负载均衡策略”](#5-负载均衡策略)

### **5.1 默认策略:加权最少请求**
[Section titled “5.1 默认策略:加权最少请求”](#51-默认策略加权最少请求)
调度中心像个人事主管,手里实时记着每台节点“正在干的活”和“本事值(权重)”。新人请求进门,它先筛掉请病假的,再把剩下的人按“当前工作量”排队;谁活最少、且本事大,就第一时间把新活塞过去。节点只要定期回一句“我还活着、现在忙 N 个”,就能被公平又高效地“能者多劳”。
### **5.2 一致性哈希策略**
[Section titled “5.2 一致性哈希策略”](#52-一致性哈希策略)

调度中心化身“指纹管理员”,把用户 IP 或 Header、Cookie 做成指纹,在一条首尾相接的哈希环上找对应位置,然后顺时针把用户“钉”到第一个遇见的健康节点。只要指纹不变,用户每次来都被领到老位置;节点宕机,环缺一块,指纹顺势滑到隔壁,其余人原地不动。节点这边基本无感,只需保证自己重启后如果环位变化能尽快重新加载状态即可。
#### **5.2.1 来源 IP 策略**
[Section titled “5.2.1 来源 IP 策略”](#521-来源-ip-策略)
根据请求来源的 IP 地址进行 hash。同一公网 IP 地址的用户请求,始终被路由到固定的后端节点。适用于大部分标准客户端场景。
#### **5.2.2 HTTP Header 策略**
[Section titled “5.2.2 HTTP Header 策略”](#522-http-header-策略)
可以指定某个 HTTP Header 字段(例如 X-User-ID 或 Authorization)进行 hash。只要客户端在每次请求时都携带相同的 Header 值,就能实现会话保持。适合 API 调用和需要精细化控制的场景。
#### **5.2.3 Cookie 策略**
[Section titled “5.2.3 Cookie 策略”](#523-cookie-策略)
当采用此策略时,网关会检查请求中是否携带了指定的 Cookie。如果存在,则根据 Cookie 的值进行 hash;如果不存在,系统会自动为该请求生成一个 Cookie 并通过 Set-Cookie 响应头返回给客户端。
### **5.3 其他均衡策略**
[Section titled “5.3 其他均衡策略”](#53-其他均衡策略)

**随机策略**:调度中心当起“骰子庄家”:把所有在岗节点写进名单,新请求进门就掷一次随机数,指到谁便把活甩给谁。节点完全不用汇报工作量,只要保持“我活着”心跳,就有被点中的机会;长期来看大家被抽中的概率趋于平均,简单快速,适合短平快的小任务。

**轮询策略**:调度中心变成“顺序叫号机”,维护一根“上次轮到谁”的指针。请求一来,指针往后移一格,点到谁就给谁,走到名单末尾再折回开头。节点依旧只需报心跳,调度逻辑零计算、零状态,保证每人严格一人一个,公平得肉眼可见,最宜无状态、耗时相近的短连接场景。
## **6. 异常处理机制**
[Section titled “6. 异常处理机制”](#6-异常处理机制)
**异常处理后会通过站内信和短信形式通知用户**
### **6.1 扩容失败处理**
[Section titled “6.1 扩容失败处理”](#61-扩容失败处理)
当扩容失败时,系统会根据失败原因采取不同的处理策略:
**资源不足**:当平台侧资源暂时不足时,系统会保持当前集群规模,尽力处理现有请求,并将溢出任务置于等待队列,避免反复尝试。
**配额限制**:当扩容请求将导致用户总节点数超过配额限制时,系统会立即停止针对该任务的扩容操作,避免无限重试。系统会通过站内信和短信通知用户具体原因。
### **6.2 缩容失败处理**
[Section titled “6.2 缩容失败处理”](#62-缩容失败处理)
当节点无法被系统正常释放时,系统会在几次短暂的释放尝试后,将该节点隔离,不再向其分配新任务,并对此类「待释放」节点免除费用。系统会清晰地告知用户平台正在处理资源回收问题。
### **6.3 其他异常处理**
[Section titled “6.3 其他异常处理”](#63-其他异常处理)
当系统无法获取监控数据时,系统会通过站内信和短信通知用户,并锁定当前节点数量,暂停所有自动伸缩行为,避免无限重试。
## **7. 通知机制**
[Section titled “7. 通知机制”](#7-通知机制)
### **7.1 扩容失败通知**
[Section titled “7.1 扩容失败通知”](#71-扩容失败通知)
**资源不足通知**:
站内信:任务扩容失败通知,说明当前任务所选区域资源暂时不足,扩容操作已自动停止
短信:【共绩算力】集群扩容失败,当前地域资源不足。系统已暂停扩容,请稍后重试
### **7.2 缩容失败通知**
[Section titled “7.2 缩容失败通知”](#72-缩容失败通知)
**站内信**:节点释放异常处理通知,说明检测到节点释放异常,相关节点已被隔离并暂停计费
**短信**:【共绩算力】节点释放异常,已暂停计费并隔离问题节点
### **7.3 其他异常通知**
[Section titled “7.3 其他异常通知”](#73-其他异常通知)
**站内信**:自动扩缩容异常通知,说明发生未知异常,已暂停自动扩缩容,任务仍然正常运行
**短信**:【共绩算力】自动扩缩容发生未知异常,已暂停自动扩缩容,任务仍然正常运行
## **8. 常见问题解答**
[Section titled “8. 常见问题解答”](#8-常见问题解答)
### **8.1 为什么扩容失败?**
[Section titled “8.1 为什么扩容失败?”](#81-为什么扩容失败)
扩容失败通常是由于资源不足或配额限制。请检查当前地域资源情况,或联系客服了解配额使用情况。
### **8.2 如何选择合适的扩缩容策略?**
[Section titled “8.2 如何选择合适的扩缩容策略?”](#82-如何选择合适的扩缩容策略)
对于大多数 AI 推理和批处理任务,建议使用队列延迟策略。对于对资源使用有精确控制需求的场景,可以选择资源利用率策略。
### **8.3 如何优化成本?**
[Section titled “8.3 如何优化成本?”](#83-如何优化成本)
合理设置最大节点数和空闲超时时间,定期监控资源使用情况,根据实际需求调整配置参数。
### **8.4 如何确保任务稳定性?**
[Section titled “8.4 如何确保任务稳定性?”](#84-如何确保任务稳定性)
建议设置合适的最小节点数,避免冷启动影响。同时关注异常通知,及时处理相关问题。
# 资源监控功能说明
## 概述
[Section titled “概述”](#概述)
共绩算力平台资源监控功能,可实时采集、可视化展示及异常告警算力节点的 CPU、内存、GPU(含型号、利用率、功耗、温度)等核心资源指标,助力运维人员、开发人员快速掌握资源监控能力,高效实现对算力资源运行状态、性能指标的实时管控与问题排查,保障算力服务稳定运行。
## 适用场景
[Section titled “适用场景”](#适用场景)
* 共绩算力平台内的弹性部署服务场景:需实时掌握服务运行所需算力资源状态,保障服务稳定部署与正常运行,为弹性部署提供资源支撑。
* 需实时监控 CPU、GPU 资源利用率及历史趋势的场景:适用于高算力需求相关操作,通过实时监控与历史趋势分析,辅助优化资源分配、规避性能瓶颈。
## 演示流程
[Section titled “演示流程”](#演示流程)
以下流程用于演示资源监控功能的典型使用过程:
1. 创建弹性部署服务:登录共绩算力平台,进入弹性部署服务模块,完成服务创建操作,等待服务启动。
2. 进入监控界面:服务启动成功后,进入服务界面,找到需要查看的算力节点,点击该节点对应的“监控”入口,进入节点资源监控详情页。
 
1. 面板功能说明
* 时间范围:可按需设定历史趋势所涵盖的时间范围,满足实时查看与历史数据回溯需求;
* 粒度:可按需设定监控状态更新时间间隔,根据监控精度需求灵活调整,粒度越小,监控数据越精准;
* CPU 监控:可查看当前 CPU 实时负载,以及设定时间范围内的 CPU 利用率历史趋势,清晰掌握 CPU 运行状态;
* 内存监控:可查看内存实时使用情况及历史变化趋势,精准掌握内存占用状态,辅助排查内存相关异常;
* GPU 监控:可查看 GPU 核心指标,包括 GPU 型号、实时利用率、功耗及温度,同时支持查看各指标的历史趋势,全面掌握 GPU 运行状态;
# 预留资源包
## 概述
[Section titled “概述”](#概述)
预留资源包是**一种预付费、包周期、计算资源费用抵扣券**,绑定特定**集群**与**卡型**,自动匹配同集群同卡型,抵扣**按量计费**的**计算资源**费用,同时提供**资源预留**能力,保障任务创建成功率。另外还支持**卡时返还**增值模式,支持闲置算力**共享变现**,盘活闲置算力,降低用户综合成本。
## 核心价值
[Section titled “核心价值”](#核心价值)
1. 解决用户**高峰期算力资源无法保障、空闲期闲置资源无法再利用/变现**的核心痛点,并适配不同用户的差异化算力需求。
2. 助力平台实现**算力资源的精细化运营、商业收益的有效提升、核心客户的深度绑定。**
3. 完善平台计费产品体系,**新增闲置算力共享变现模式**,强化算力租赁领域产品竞争力。
## 使用场景
[Section titled “使用场景”](#使用场景)
稳定弹性场景使用预留资源包,可以大幅降低成本。
* 弹性场景:资源总量保持相对稳定,但需根据业务情况弹性使用资源,可通过预留资源包实现降本增效。
* 自动化运维:需根据业务变动、波峰波谷等因素自动扩缩容,调整资源类型和分布。
* 资源锁定:针对重要的弹性业务,或资源供应紧张的情况,需通过提前锁定资源,规避资源供应风险。
## 生命周期
[Section titled “生命周期”](#生命周期)
在一个生命周期中,预留资源包有固定的一些状态,如下所示:
* 创建中:购买预留资源包后,在其进入“未生效”或“生效中”之前的状态。
* 未生效:购买预留资源包后,未到资源包生效日期时的状态。
* 生效中:购买预留资源包后,到资源包生效日期,未到失效日期前的状态,此状态下的预留资源包可以抵扣按量计费的容器服务产品账单。
* 已过期:预留资源包到期后,处于“已过期”状态。
## 计费方式
[Section titled “计费方式”](#计费方式)
预留资源包无法单独使用,需要匹配按量计费的计算类容器云产品(弹性部署服务、Job 批处理、云主机等),根据资源包所选卡型、卡数、所在区域等因素来抵扣按量计费的账单。
### 抵扣规则
[Section titled “抵扣规则”](#抵扣规则)
* 秒级计费,按小时抵扣。
* 若同时存在预留资源包和算力券,则优先抵扣预留资源包。
* 如果同时存在多张预留资源包可抵扣时,按照预留资源包的到期时间,先到期的先抵扣;若到期时间相同,生效时间早的先抵扣;若都相同,则随机选取。
## 计费规则
[Section titled “计费规则”](#计费规则)
### 计费类型
[Section titled “计费类型”](#计费类型)
购买预留资源包时仅支持预付费,即购买时一次性缴纳所有费用,有效期内不会再产生其他费用。
### 计费周期
[Section titled “计费周期”](#计费周期)
预留资源包从生效时间开始计费,到失效时间停止计费。
例如,您购买的一份预留资源包生效时间为 2026-05-01 00:00:00,失效时间为 2026-05-10 00:00:00。则该预留资源包的计费开始时间为 2026-05-01 00:00:00,计费停止时间为 2026-05-10 00:00:00。如果您在此期间已经持有运行中的可匹配的(同一卡型、同一区域、不超过资源包的购买卡数)容器类型计算任务,则从 2026-05-01 00:00:00 的小时账单开始抵扣,直至 2026-05-10 00:00:00 预留资源包失效停止抵扣。
预留资源包到期后,状态变更为已到期,不能继续抵扣按量计费账单,但已创建的按量计费资源仍可正常使用(遵循按量计费结算规则,可通过算力券或余额扣费),不会中断您的业务。
## 订单管理
[Section titled “订单管理”](#订单管理)
您可以在费用中心的订单管理页面查看预留资源包订单详情。

您可以通过预留资源包列表页和详情页查看对应信息。
## 预留资源包列表页
[Section titled “预留资源包列表页”](#预留资源包列表页)
列表页包括所有购买的资源包基本信息,可按状态(未生效、生效中、已过期)和卡型筛选。

## 预留资源包详情页
[Section titled “预留资源包详情页”](#预留资源包详情页)
详情页展示资源包详细信息,包括基础配置(生效集群、卡型、卡数、有效期以及生效时段)、计费与支付信息(订单金额、优惠金额、实付金额)以及账单抵扣明细(可以按时间范围筛选查询)。

# 健康检测
## 1.概念定位
[Section titled “1.概念定位”](#1概念定位)
### 1.1 存活探针
[Section titled “1.1 存活探针”](#11-存活探针)
存活探针用于检测容器运行状态。当应用出现死锁或无响应时(如崩溃、死循环),共绩算力平台会自动触发容器重启,无需人工干预。 存活探针不会等待就绪探针成功。如果你想在执行存活探针前等待,你可以使用启动探针。
### 1.2 就绪探针
[Section titled “1.2 就绪探针”](#12-就绪探针)
就绪探针验证节点是否具备服务能力。在共绩算力平台中,未通过检测的节点将被自动移出服务流量池,确保业务连续性。 如果就绪探针返回的状态为失败,会将该节点从所有对应服务中移出,同时启动一个新节点进行替换,保证服务的正常运行。 就绪探针在容器的整个生命期内持续运行。
### 1.3 启动探针
[Section titled “1.3 启动探针”](#13-启动探针)
启动探针保护慢启动容器不被误杀。共绩算力平台会暂停存活/就绪检测,直到该探针确认应用已完成初始化。 如果配置了这类探针,它会禁用存活检测和就绪检测,直到启动探针成功为止。
这类探针仅在启动时执行,不像存活探针和就绪探针那样周期性地运行。
## 2.平台视角下的探针实际案例
[Section titled “2.平台视角下的探针实际案例”](#2平台视角下的探针实际案例)
### 2.1 启动探针检测容器中的应用是否已经启动
[Section titled “2.1 启动探针检测容器中的应用是否已经启动”](#21-启动探针检测容器中的应用是否已经启动)
启动探针保护慢启动容器不被误杀。共绩算力平台会暂停存活/就绪检测,直到该探针确认应用已完成初始化。 如果配置了这类探针,它会**禁用存活检测和就绪检测**,直到启动探针成功为止。
这类探针仅在启动时执行,不像存活探针和就绪探针那样周期性地运行。
> 示例镜像地址:harbor.suanleme.cn/huang5876/jupyter\_torch\_probe\_test:latest 端口号配置:8888

启动初始探针设置(下一部分会详细讲解参数及其意义):
修改端口号为 `8888`(JupyterLab 默认端口)

启动探针发现异常:

**异常原因:**
* 启动探针配置不当:
* 路径 /live 返回 404:容器启动后,存活探针立即开始检查 /live 接口(初始延迟 `0` 秒),但该接口不存在(返回 404),导致探针失败。
* 失败阈值触发:存活探针每 10 秒检查一次,超时时间仅 1 秒,连续 3 次失败后,判定容器不健康,触发重启。
* 服务初始化时间较长:
* JupyterLab 及其扩展(如 jupyter\_lsp、jupyter\_server\_terminals)加载需要时间(约 10 秒),但**启动探针未等待服务完全就绪就开始检查**。

**更新启动探针配置:** 修改检查周期长一些 让 JupyterLab 先启动起来 避免启动时间过短 路径指向容器默认启动路径`/lab`

**当前服务状态:**
JupyterLab 服务正常运行 服务持续监听 `http://127.0.0.1:8888/lab`。 用户访问 `/` 路径触发 302 重定向,表明前端路由正常。
无关键错误: 日志中未出现内核崩溃、探针失败或服务中断的报错。 内核消失问题(`404 Kernel does not exist`)未出现。

### 2.2 就绪探针容器检测是否准备好接收流量
[Section titled “2.2 就绪探针容器检测是否准备好接收流量”](#22-就绪探针容器检测是否准备好接收流量)
这里以我们预制好的镜像 Whisper 举例

启动成功后进入健康检查设置中:
修改路径为`/docs#/Endpoints/asr_asr_post` (语音转文字默认接口)
端口号改为:`9000`

保存后可以通过容器日志查看到实时返回的接口信息
服务运行正常:容器状态显示 “运行中”,日志中接口( /docs)返回 200 状态码,表明服务已成功启动,准备好接收流量(检查周期每 20 秒返回一次)

### 2.3 存活探针检测容器是否正常运行
[Section titled “2.3 存活探针检测容器是否正常运行”](#23-存活探针检测容器是否正常运行)
这里以我们预制好的镜像 Whisper 举例

启动成功后进入健康检查设置中:
修改路径为`/docs#/Endpoints/asr_asr_post` (语音转文字默认接口)
端口号改为:`9000`

服务运行正常:容器状态显示 “运行中”,日志中接口( /docs)返回 200 状态码,表明服务已成功启动,准备好接收流量(检查周期每 10 秒返回一次)

## 3.平台视角下的探针参数作用详细解析
[Section titled “3.平台视角下的探针参数作用详细解析”](#3平台视角下的探针参数作用详细解析)

**HTTPGet:**通过发送 HTTP 请求并检查响应状态码来判断服务状态
**TCPSocket:**仅检查指定端口是否能建立 TCP 连接,不涉及具体业务逻辑
**路径:**仅 HTTP Get 类型需要,TCP Socket 类型不需要路径参数
**端口:**健康检查的目标端口号
**初始延迟:**0 秒(立即开始检查)
**检查周期:**X 秒(每 X 秒检测一次)
**超时时间:**X 秒(每次请求最长等待 X 秒)
**失败阈值:**X 次(连续失败 X 次判定启动失败)
## 4.更多
[Section titled “4.更多”](#4更多)
# 镜像仓库使用指南
## 1. 服务选择建议
[Section titled “1. 服务选择建议”](#1-服务选择建议)
1. **阿里云容器镜像服务(ACR)**
* **功能特性**:支持镜像托管、安全扫描、多地域分发,提供企业版与默认实例版,企业版适用于大规模多地域场景。
* **推荐场景**:生产环境建议使用企业版,同时也提供免费版。
* **服务地址**:
2. **我们提供的镜像仓库**
* **适用场景**:临时测试或小规模使用,需注意账号独立(与主账号密码不互通)。
🐋
镜像仓库的账号密码和用户的账号密码不互通。
## **2. ****镜像仓库**使用指南
[Section titled “2. 镜像仓库使用指南”](#2-镜像仓库使用指南)
### 2.1 步骤 1: 登录共绩算力镜像站
[Section titled “2.1 步骤 1: 登录共绩算力镜像站”](#21-步骤-1-登录共绩算力镜像站)
1. 访问控制台的 页面
2. 点击”凭证”
3. 初始化镜像仓库
4. 按照页面上的登录指引操作(运行命令->输入密码)
> **凭证的核心作用:**
>
> * **身份验证** 凭证相当于平台访问的”数字钥匙”,用于验证用户身份,确保只有授权用户才能访问私有镜像库。
> * **权限控制** 通过凭证关联账户权限,控制用户对镜像资源的拉取(pull)、推送(push)等操作。
> * **安全通信** 加密客户端与镜像站之间的数据传输,防止敏感信息泄露。

针对 **Windows** 和 **Mac** 系统的终端操作指南:
前提:需先安装 [Docker Desktop for Windows](https://www.docker.com/products/docker-desktop) 并确保 docker 服务已启动(点击图标运行 docker 引擎)再进行下面的操作
#### **2.1.1 Windows 系统操作步骤**
[Section titled “2.1.1 Windows 系统操作步骤”](#211-windows-系统操作步骤)
**第一步:打开终端** 按下 `Win + S` 搜索 `PowerShell` 或 `CMD`,右键选择** “以管理员身份运行”**(避免权限问题)
**第二步:执行登录命令** (复制凭证中的登录镜像仓库命令) `docker login harborpush.suanleme.cn --username=XXX(换成用户所对应的仓库名称)`  系统会提示输入密码: `Password:#输入你的仓库密码(输入时不会显示字符,直接盲输后按回车)`  成功提示: `Login Succeeded` 
**常见问题:**
如果提示 `docker command not found`:需先安装 [Docker Desktop for Windows](https://www.docker.com/products/docker-desktop) 并确保服务已启动。
密码错误或过期:通过网页端 **“重置密码”** 后重试。
***
#### **2.1.2 Mac 系统操作步骤**
[Section titled “2.1.2 Mac 系统操作步骤”](#212-mac-系统操作步骤)
🥇
mac 设备打的镜像在平台上可能用不了,因为 mac 普遍是 arm 架构,平台是 X86 的
**第一步:打开终端** 通过 `Spotlight`(`Command + Space`)搜索 `终端` 并打开
**第二步:执行登录命令** `docker login harborpush.suanleme.cn --username=XXX(换成用户所对应的仓库名称)` 输入密码: `Password: # 输入密码(无回显,输完直接按回车)` 成功提示: `Login Succeeded`
**常见问题:**\
如果提示权限不足:在命令前加 `sudo`(需输入 Mac 用户密码):\
`sudo docker login harborpush.suanleme.cn --username=huang5876` Docker 未运行:需启动 [Docker Desktop for Mac](https://www.docker.com/products/docker-desktop) 并等待图标变绿。
***
#### **2.1.3 密码重置指引**
[Section titled “2.1.3 密码重置指引”](#213-密码重置指引)
1. 访问镜像仓库控制台页面,点击 **“重置密码”**。
2. 按提示通过邮箱或手机验证身份。
3. 设置新密码后,**重新执行登录命令**。
***
### 2.2 步骤 2: 为镜像添加标签
[Section titled “2.2 步骤 2: 为镜像添加标签”](#22-步骤-2-为镜像添加标签)
#### **2.2.1 为何需要添加标签?**
[Section titled “2.2.1 为何需要添加标签?”](#221-为何需要添加标签)
镜像标签(Tag)相当于镜像的”地址 + 版本标识”,目的是将本地镜像与远程仓库路径绑定。共绩算力镜像站要求镜像名称必须包含完整的仓库地址和账户信息,否则无法识别推送目标。
***
#### **2.2.2 完整操作步骤**
[Section titled “2.2.2 完整操作步骤”](#222-完整操作步骤)
##### **第一步:查看本地镜像列表**
[Section titled “第一步:查看本地镜像列表”](#第一步查看本地镜像列表)
在终端执行以下命令,确认要推送的本地镜像名称和版本:
###### **查看本地所有的镜像**
[Section titled “查看本地所有的镜像”](#查看本地所有的镜像)
```powershell
#查看本地所有的镜像
docker images
```
###### 非 root 用户使用
[Section titled “非 root 用户使用”](#非-root-用户使用)
```powershell
#查看本地所有的镜像
sudo docker images
```
输出示例:
```json
REPOSITORY TAG IMAGE ID CREATED SIZE
my-image latest a1b2c3d4e5f6 2 hours ago 1.2GB
```
###### **Docker 镜像字段解析:**
[Section titled “Docker 镜像字段解析:”](#docker-镜像字段解析)
**镜像仓库/名称 (REPOSITORY)**
表示镜像的完整来源路径,由仓库地址、账户名和镜像名称组成。例如:
* 公共仓库镜像:`my-image`(默认从 Docker Hub 拉取,格式为`仓库名/镜像名`)。
* 私有仓库镜像:`harborpush.suanleme.cn/huang5876/my-app`(需包含仓库域名、账户名及镜像名)。
**标签 (TAG)**
用于标识镜像版本,支持自定义语义化命名规则:
* `latest` 是默认标签,通常指向最新构建的镜像(生产环境慎用)。
* `v1.2.0` 是推荐的自定义标签,可通过版本号区分不同功能阶段的镜像(如开发版、稳定版)。
**镜像唯一 ID (IMAGE ID)** 由镜像内容生成的哈希值,是镜像的唯一标识符。实际显示为完整 64 位 ID 的前 12 位(例如 `a1b2c3d4e5f`),可通过 `docker inspect` 命令查看完整 ID。
**创建时间 (CREATED)** 记录镜像的构建时间,格式为可读的相对时间(如 `2 weeks ago`)。此时间不随镜像更新而改变,可用于判断镜像版本的新旧程度。
**镜像大小 (SIZE)** 表示镜像的虚拟存储空间,包含所有分层文件的总和。由于 Docker 采用分层存储机制,不同镜像可能共享基础层,因此实际磁盘占用通常小于各镜像 SIZE 的累加值(例如多个镜像共享同一 `Ubuntu` 基础层时)。
##### **第二步:执行标签添加命令**
[Section titled “第二步:执行标签添加命令”](#第二步执行标签添加命令)
**命令格式**:
```powershell
docker tag <原镜像名称>:<原标签> harborpush.suanleme.cn/<你的账户>/<镜像名称>:<自定义标签>
```
**参数解释**:
* `<原镜像名称>:<原标签>`:本地已有的镜像名称和标签(如 `my-image:latest`)
* `<你的账户>`:登录镜像仓库的账号(需在控制台 **\[镜像仓库 > 访问凭证]** 中确认)
* `<镜像名称>`:推送到仓库后的镜像名称(可自定义,建议与本地镜像同名)
* `<自定义标签>`:镜像版本标识(如 `v1.0`、`prod`)
***
##### **第三步:具体操作示例**
[Section titled “第三步:具体操作示例”](#第三步具体操作示例)
假设你的账户是 `huang5876`,本地镜像为 `my-image:latest`,目标标签设为 `v1.0`:
```powershell
docker tag my-image:latest harborpush.suanleme.cn/huang5876/my-image:v1.0
```
验证是否成功:
```powershell
docker images
```
输出中应出现新标签的镜像:
```json
REPOSITORY TAG IMAGE ID CREATED SIZE
my-image latest a1b2c3d4e5f6 2 hours ago 1.2GB
harborpush.suanleme.cn/huang5876/my-image v1.0 a1b2c3d4e5f6 2 hours ago 1.2GB
```
***
#### **2.2.3 关键注意事项**
[Section titled “2.2.3 关键注意事项”](#223-关键注意事项)
1. **账户名必须精确匹配** `<你的账户>` 必须与镜像仓库控制台中显示的**登录账号**完全一致(区分大小写)
* 可通过控制台 **\[镜像仓库 > 访问凭证]** 查看确认账号
2. **镜像层级结构规则**
* 完整路径格式:`harborpush.suanleme.cn/<账户>/<项目>/<镜像名>:<标签>`
如果仓库有项目层级(如团队协作),需包含项目名:
例如:`docker tag my-image harborpush.suanleme.cn/huang5876/project-a/my-image:v1.0`
3. **标签命名建议** - 使用语义化版本(如 `v1.0.2`)
* 避免使用默认的`latest` 标签(易导致版本混乱)
* 可包含环境标识(如 `dev`、`prod`)
***
#### **2.2.4 常见问题排查**
[Section titled “2.2.4 常见问题排查”](#224-常见问题排查)
* **错误提示 “Repository does not exist”** ➠ 检查账户名是否拼写错误 ➠ 确认仓库中是否已手动创建对应项目(部分平台需先创建仓库目录)
* **镜像列表未显示新标签** ➠ 确保 `docker tag` 命令参数顺序正确 ➠ 验证原镜像是否存在(通过 `docker images`)
* **推送时提示权限不足** ➠ 重新执行 `docker login`确保登录状态 ➠ 检查账户是否有该仓库路径的写入权限
***
### 2.3 步骤 3: 推送镜像
[Section titled “2.3 步骤 3: 推送镜像”](#23-步骤-3-推送镜像)
标签添加完成后,使用以下命令推送镜像:
```shell
docker push harborpush.suanleme.cn//my-image:my-tag
```
参数解释:`docker push harborpush.suanleme.cn//my-image:my-tag`
* `harborpush.suanleme.cn` 镜像仓库的域名地址,指向共绩算力平台的私有镜像仓库存储服务。
* `` 你的仓库账号(需替换为实际账号)。 ➠ 通过控制台 **\[镜像仓库 > 访问凭证]** 查看确认账号名称(区分大小写)。
* `my-image` 推送到仓库后的镜像名称,支持以下两种形式:
* **直接命名**:与本地镜像同名(如 `my-image`)
* **层级命名**:包含项目/分类(如 `project-a/my-image`,需提前在仓库创建对应目录)
* `my-tag` 镜像的版本标签,用于标识不同版本或环境:
* 示例:`v1.0`(语义化版本)、`prod`(生产环境)、`20251001`(日期版本)
* 避免使用默认的 `latest` 标签(易导致版本混乱)。
在推送过程中,会显示上传进度。当推送成功后,可以在“镜像仓库”页面查看该镜像。如果镜像过大,那么推送所需时间可能会比较长。

***
## **3 阿里云容器镜像服务(ACR)使用指南**
[Section titled “3 阿里云容器镜像服务(ACR)使用指南”](#3-阿里云容器镜像服务acr使用指南)
### 3.1 服务准备与实例选择
[Section titled “3.1 服务准备与实例选择”](#31-服务准备与实例选择)
1. **实例类型选择**
* **企业版**:适用于生产环境,支持多地域分发、安全扫描、镜像加签、全球同步加速、P2P 分发等功能,提供 99.95% SLA 保障。推荐选择标准版或高级版以支持交付链与大规模分发。
* **个人版**:仅限测试或小规模使用,无 SLA 保障,功能受限(如不支持 Helm Chart 管理)。
2. **创建实例**
* **操作路径**:登录[容器镜像服务 ACR](https://www.aliyun.com/product/acr),选择地域后创建实例,需配置实例名称、存储类型(默认 OSS 或自定义 Bucket)、安全扫描引擎(Trivy 或云安全引擎)及资源配额。
* **注意事项**:
* 企业版需绑定 OSS 服务并设置 VPC 访问控制配额。
* 命名空间与仓库数量受配额限制,建议按团队或项目划分命名空间。 
**企业版:**容器镜像服务 
### 3.2 镜像仓库配置
[Section titled “3.2 镜像仓库配置”](#32-镜像仓库配置)
**官方教程:****阿里云【试用教程】在 Dockerfile 中使用构建打包镜像并运行**
1. **命名空间与仓库创建**
1. **命名空间**:逻辑隔离单元,建议按组织命名(如 `dev-team`),一个账号最多创建 3 个(个人版)或更多(企业版)。 
 1. **镜像仓库**: **创建步骤**:在控制台选择命名空间后,填写仓库名称、类型(私有/公开)、代码源(本地仓库或 Git 平台),并配置构建设置(自动构建、缓存策略)。 2. **命名规范**:需包含完整路径(如 \`registry.cn-hangzhou.aliyuncs.com/<命名空间>/<仓库名>:<标签>\`),标签建议使用语义化版本(如 \`v1.0-prod\`)。
 1. **访问控制** - **公网/VPC 访问**:企业版需在控制台开启公网入口并配置白名单,或通过专有网络实现内网加速。 - **权限管理**:通过 RAM 子账号授权,区分命名空间管理员(全权限)、普通成员(读写)和只读用户。
### 3.3 镜像操作指南
[Section titled “3.3 镜像操作指南”](#33-镜像操作指南)
1. **登录凭证配置**
* **凭证类型**:支持阿里云账号 AccessKey 或临时密码,企业版需在控制台\[访问凭证]页面设置固定密码。

* **登录命令**:
```bash
docker login --username=<账号名> registry..aliyuncs.com
```
输入密码后显示 `Login Succeeded` 即为成功。
1. **镜像推送与拉取**
* **标签与推送**:
```bash
docker tag <本地镜像> registry.cn-hangzhou.aliyuncs.com/<命名空间>/<仓库名>:<标签>
docker push registry.cn-hangzhou.aliyuncs.com/<命名空间>/<仓库名>:<标签>
```
* **拉取镜像**:
```bash
docker pull registry.cn-hangzhou.aliyuncs.com/<命名空间>/<仓库名>:<标签>
```
* **注意事项**:企业版实例名称需替换为 `企业版实例名称-region.cr.aliyuncs.com`。
1. **多架构镜像构建**
* **适用场景**:需支持 x86、ARM 等不同架构。
* **操作步骤**:
1. 在代码仓库配置多架构构建规则(如 `linux/amd64` 和 `linux/arm64`)。
2. 触发构建后,同一标签将包含多架构镜像,客户端自动拉取适配版本。
***
### 3.4 高级功能与优化
[Section titled “3.4 高级功能与优化”](#34-高级功能与优化)
1. **镜像加速器配置**
* **作用**:加速 Docker Hub 官方镜像拉取,需在 `/etc/docker/daemon.json` 中添加加速器地址(如 `https://<加速器地址>.mirror.aliyuncs.com`)并重启 Docker 服务。
* **限制**:仅限阿里云公网产品使用,无法保证拉取最新版本,建议指定镜像版本。
2. **安全与合规**
* **安全扫描**:企业版支持自动扫描漏洞(CVE、恶意代码),并生成修复建议。
* **镜像加签**:通过密钥对镜像签名,防止篡改,可配置自动加签规则。
* **操作审计**:记录所有镜像操作日志,便于追溯与合规审查。
3. **全球分发与同步**
* **多地域复制**:企业版支持一键同步镜像至全球地域,通过内网专线降低延迟。
* **P2P 加速**:千节点级分发时启用 P2P 技术,提升效率 4 倍以上。
4. **生命周期管理**
* **自动清理策略**:设置保留规则(如保留最近 10 个版本),自动清理旧镜像释放存储空间。
* **交付链集成**:高级版支持构建→扫描→加签→分发的自动化流水线,减少人工干预。
***
### 3.5 常见问题与排查
[Section titled “3.5 常见问题与排查”](#35-常见问题与排查)
**问题现象:****unauthorized**** 或权限不足**
* **原因**:Docker 客户端未携带有效身份凭证,或用户对目标仓库无操作权限。
* **解决方案**:
1. 执行 `docker logout` 退出当前登录状态,重新运行 `docker login` 输入账户密码。
2. 若使用私有仓库,需在登录时指定仓库地址(如 `docker login harbor1.example.com`)。
3. 检查账户是否被移出仓库权限组,联系管理员确认访问权限。
**问题现象:推送失败(Repository does not exist)**
* **原因**:镜像名称中的命名空间或仓库路径不符合仓库规则,或目标仓库尚未创建。
* **解决方案**:
1. 镜像名称需严格遵循 `仓库域名/命名空间/仓库名:标签` 格式(如 `harbor1.com/dev-team/myapp:v1`)。
2. 通过仓库管理界面手动创建同名仓库目录(部分私有仓库要求先创建空仓库)。
3. 确认账户对目标仓库有 `push` 权限(权限不足时会伪装为“仓库不存在”错误)。
**问题现象:镜像拉取超时**
* **原因**:网络连接不稳定或跨国访问公共仓库速度受限。
* **解决方案**:
1. **配置镜像加速器**:
* 修改 Docker 配置文件 `/etc/docker/daemon.json`,添加国内镜像源(如阿里云、腾讯云镜像加速地址)。
* 执行 `systemctl reload docker` 重启服务生效。
2. **启用企业版加速功能**:
* 私有化部署仓库(如 harbor1)可开启 P2P 分发或全球节点同步功能。
3. 临时切换网络环境测试(如从公司内网切换至公网)。
**问题现象:安全扫描报错**
* **原因**:镜像包含高危漏洞或依赖项版本过低。
* **解决方案**:
1. 使用 `docker scan 镜像名` 运行安全扫描,查看具体漏洞详情。
2. 升级 Dockerfile 中 `FROM` 指定的基础镜像版本(如 `FROM alpine:3.19` 替代 `alpine:3.10`)。
3. 使用阿里云容器镜像服务提供的「安全镜像」,自动集成漏洞修复补丁。
4. 在 CI/CD 流程中集成 Trivy 或 Clair 漏洞扫描工具,阻断不安全镜像流入生产环境。
***
### 3.6 最佳实践建议
[Section titled “3.6 最佳实践建议”](#36-最佳实践建议)
1. **生产环境规范**:
* 使用企业版并启用安全扫描、加签与访问控制。
* 避免使用 `latest` 标签,采用语义化版本管理。
2. **性能优化**:
* 内网推送使用 VPC 域名(如 `registry-vpc.cn-hangzhou.aliyuncs.com`)以提升速度。
* 大镜像(如 AI 模型)启用按需加载功能,减少启动时间 60%。
通过以上步骤,可高效利用 ACR 实现镜像全生命周期管理,兼顾安全性与运维效率。如需进一步探索 API 集成或自定义认证,可参考[ACR 官方文档](https://help.aliyun.com/zh/acr)。
# 对象存储加速
## **1. 功能简介**
[Section titled “1. 功能简介”](#1-功能简介)
对象存储加速支持用户将 S3 兼容对象存储接入平台,例如阿里云 OSS、腾讯云 COS、火山引擎 TOS、华为云 OBS、自建 MinIO 等,并通过 JuiceFS 文件系统和缓存加速能力,将对象存储中的模型、数据集等内容挂载到任务容器中使用。
本功能适用于大模型推理、训练数据读取、模型冷启动优化等场景。用户可以按目录将对象存储中的数据预热到指定加速区域,减少任务运行时从远端对象存储读取数据的等待时间。对象存储加速是一项缓存加速能力,不是新的持久化存储服务。源数据仍保存在用户的对象存储中。

## **2. 操作流程**
[Section titled “2. 操作流程”](#2-操作流程)
### **2.1. 对象存储加速**
[Section titled “2.1. 对象存储加速”](#21-对象存储加速)
进入存储加速管理页面后,在左侧菜单点击「对象存储加速」,进入对象存储加速管理页面。
页面中会展示当前账号下已创建的对象存储加速配置,包括配置名称、云服务商、最后预热时间、加速用量、区域和操作入口。

### **2.2. 获取对象存储配置**
[Section titled “2.2. 获取对象存储配置”](#22-获取对象存储配置)
#### **2.2.1.** 权限说明
[Section titled “2.2.1. 权限说明”](#221-权限说明)
必须具备以下权限:
* ListObjectsV2:用于校验 S3 加速页面所提供的目录是否存在。
* ListObjectsV2Input。
* PutObject:用于校验对象存储是否具备写权限。此操作会创建临时文件进行校验,原因在于对象存储会生成 uuid 并放置到对象存储目录下。
* PutObjectInput。
* DeleteObject:用于清理由 PutObject 创建的临时文件。
* DeleteObjectInput。
🔥
在使用过程中,请勿停用访问密钥(AK)、安全密钥(SK)或对其进行修改,以免功能不可用,对您的使用体验造成不良影响。
#### **2.2.2.** 阿里云 OSS
[Section titled “2.2.2. 阿里云 OSS”](#222-阿里云-oss)
可参照 *这篇文档* 了解如何创建 Access Key 和 Secret Key。
进入对象存储的控制台,找到 Access Key 入口:

创建一个 Access Key 用于挂载:

#### **2.2.3.** 腾讯云 COS
[Section titled “2.2.3. 腾讯云 COS”](#223-腾讯云-cos)
Secret ID(AccessKey)和 Secret Key 需要在 *API 密钥管理* 中查看或创建。

#### **2.2.4. 自建 S3 - MinIO**
[Section titled “2.2.4. 自建 S3 - MinIO”](#224-自建-s3---minio)
理论上兼容 MinIO 和 RustFS

#### **2.2.5. 火山引擎 TOS**
[Section titled “2.2.5. 火山引擎 TOS”](#225-火山引擎-tos)
可参照 *这篇文档* 了解如何创建 Access Key 和 Secret Key。
火山引擎 TOS 为每个区域都提供了公网和内网 *endpoint 链接*,你可以根据实际的场景选用。
 
Endpoint 获取:需要选择 S3 Endpoint

在下面 2.3 章节中配置对象存储时,需要使用携带 s3 的 Endpoint

#### 2.2.6. 华为云 OBS
[Section titled “2.2.6. 华为云 OBS”](#226-华为云-obs)
可参照*这篇文档* 了解如何创建 Access Key 和 Secret Key。
需在对应的 bucket 中设置桶策略,如下图

### **2.3.** 配置对象存储加速
[Section titled “2.3. 配置对象存储加速”](#23-配置对象存储加速)
在对象存储加速页面点击「新增对象存储配置」,填写对象存储相关信息。
需要填写的主要信息包括配置名称、云服务商、地域、Endpoint、AccessKey、SecretKey、Bucket 名称和加速目录。
加速目录建议填写业务所需的子目录,例如模型目录、训练数据目录或推理数据目录。不建议直接选择 Bucket 根目录。
推荐示例:
```text
oss://demo-bucket/models/qwen/
oss://demo-bucket/dataset/train/
oss://demo-bucket/checkpoints/v1/
```
不推荐示例:
```text
oss://demo-bucket/
```
如果直接选择 Bucket 根目录,后续目录加载、缓存预热和缓存删除的范围都会变大,可能导致目录加载较慢、缓存空间占用过多,也不利于区分不同业务数据。
当前目录树仅展示目录和子目录,不展示具体文件。如果文件直接放在 Bucket 根目录下,用户需要选择整个根目录范围才能对这些文件进行预热。因此,建议将模型、数据集、日志等文件按业务目录进行组织。

当执行保存配置操作时,系统会自动对配置的可用性进行检测。只有在校验通过之后,配置才可成功保存。
### 2.4. 配置加速区域
[Section titled “2.4. 配置加速区域”](#24-配置加速区域)
对象存储配置保存成功后,需要为该配置选择加速区域。在列表中点击「配置区域」,选择需要启用的区域。
配置加速区域主要用于准备对象存储加速能力。配置完成后,该区域具备后续挂载和缓存能力,但数据不会自动全部缓存到本地。
也就是说,配置区域不等于缓存预热。首次配置完成后,区域通常显示为「缓存未同步」状态。此时区域已经可以挂载使用,但首次访问数据时可能仍需要从对象存储读取。建议在正式使用前,按需执行「预热缓存」。
  
此时系统正在为该区域启用对象存储加速能力,请等待加载完成再进行或许操作。

此时该区域的对象存储创建完成,因为还没有进行数据预热,所以显示加速用量为 0B。
### 2.5. 预热缓存
[Section titled “2.5. 预热缓存”](#25-预热缓存)
区域配置完成后,可以点击「预热缓存」选择需要提前缓存的数据目录。
预热缓存需要同时选择预热区域和预热目录。用户可以选择一个或多个可用区域,也可以选择一个或多个目录进行预热。系统会将所选目录中的数据提前加载到对应加速区域,后续任务访问这些数据时可以减少从对象存储读取的等待时间。
预热缓存弹窗中的目录树采用按需加载方式。打开弹窗时,仅展示当前目录下的第一层目录;点击目录左侧箭头后,再加载下一层子目录。当前仅展示目录和子目录,不展示具体文件。
点击「开始预热」后,系统会先同步目录信息,使平台能够识别所选目录;随后在后台执行缓存预热,将所选目录下的数据加载到指定加速区域。
目录信息同步期间,「预热缓存」和「删除缓存」入口会短暂置灰并显示「元数据更新中」。同步完成后,按钮恢复可点击。后续缓存预热会继续在后台执行,不影响已可用区域的挂载使用。
   
### 2.6. 删除缓存
[Section titled “2.6. 删除缓存”](#26-删除缓存)
如果某些目录的数据不再需要加速,可以点击「删除缓存」释放缓存空间。
删除缓存用于释放所选目录对应的加速用量。删除后,平台会移除 JuiceFS 文件系统中对应目录的数据记录,并更新加速用量。该操作不会删除对象存储中的源文件,也不会删除对象存储配置。后续任务再次访问这些数据时,可能需要重新从对象存储读取,或重新执行缓存预热。
删除缓存弹窗中展示的是当前配置下已缓存目录的集合。目录树仅展示目录名称和缓存用量,不展示具体文件。
如果删除了全部可选缓存目录,加速用量会明显降低。但由于系统会保留外层父目录等基础目录信息,加速用量通常不会回到 0B,可能显示为 4KB 左右,请以页面实际展示为准。
删除缓存过程中,平台会更新缓存状态,因此该操作为异步执行。在更新完成前,「预热缓存」和「删除缓存」入口会显示为「元数据更新中」,暂时不可重复点击。
   
### 2.7. 任务发布时挂载
[Section titled “2.7. 任务发布时挂载”](#27-任务发布时挂载)
在任务发布页面,用户可以选择已配置并启用区域的对象存储加速配置进行挂载。
发布任务时,需要选择任务运行区域。任务运行区域应与对象存储加速区域保持一致。例如,对象存储加速配置已启用「福建五区」「浙江六区」,任务也应选择「福建五区」或「浙江六区」的计算资源。
在「存储配置」区域选择对应的对象存储加速配置,并填写容器内挂载路径。挂载路径需以 `/` 开头,例如:
```text
/mnt/data
/root/.cache/huggingface
```
这里将对象存储 Bucket 中的 `/qwen1-5/hub/`挂载到了容器中的 `/root/.cache/huggingface` 目录中。
任务启动后,平台会将对象存储加速配置挂载到容器内指定路径。如果该区域缓存已同步,任务可以更快读取数据;如果缓存未同步或缓存已被删除,任务首次访问时可能需要从对象存储重新读取。
 
### 2.8. 验证挂载
[Section titled “2.8. 验证挂载”](#28--验证挂载)
提交任务后,容器启动时会自动挂载所选对象存储加速配置。待容器启动完成后,可进入容器并验证挂载结果。
用户可以查看容器内挂载路径下的目录和文件是否存在,例如:
```text
ls /root/.cache/huggingface
```
如果能够看到对象存储中对应目录下的数据,说明挂载成功。

### 2.9. 子账号授权
[Section titled “2.9. 子账号授权”](#29-子账号授权)
#### 2.9.1. 授权操作
[Section titled “2.9.1. 授权操作”](#291-授权操作)
##### 2.9.1.1. 腾讯云
[Section titled “2.9.1.1. 腾讯云”](#2911-腾讯云)
1. 找到对象存储。

2. 点击存储桶列表。
  
##### 2.9.1.2. 阿里云
[Section titled “2.9.1.2. 阿里云”](#2912-阿里云)
1. 找到对象存储。

2. 找到要设置权限的桶,然后点进去。

3. 设置权限。
  
##### 2.9.1.3. 火山云
[Section titled “2.9.1.3. 火山云”](#2913-火山云)
1. 找到对象存储。

2. 找到要设置的桶

3. 设置权限
    
#### 2.9.2. IAM 权限和桶权限的关系
[Section titled “2.9.2. IAM 权限和桶权限的关系”](#292-iam-权限和桶权限的关系)

##### 2.9.2.1. 核心区别与重叠
[Section titled “2.9.2.1. 核心区别与重叠”](#2921-核心区别与重叠)
为了更具体地理解,我们来看看两者的对比:
场景一:简单权限控制(within one account)
“我希望我创建的某个 IAM 用户只能读取 A 桶。”
* 方案 A (使用 IAM):在 IAM 中,给该用户附加一个策略,策略内容为对 `arn:aws:s3:::bucket-A`资源拥有 `s3:GetObject`和 `s3:ListBucket`权限。
* 方案 B (使用 Bucket Policy):在 A 桶的策略中,添加一条语句,允许该用户的 ARN 执行 `s3:GetObject`和 `s3:ListBucket`。
* 结论:两种方案效果几乎一样,任选其一即可。通常更推荐使用 IAM 方案,因为权限集中在 IAM 控制台,更易于统一管理身份及其权限。
## 3. 区域状态说明
[Section titled “3. 区域状态说明”](#3-区域状态说明)
对象存储加速列表中会展示每个加速区域的状态。用户可根据区域状态判断当前区域是否可用、缓存是否完成,以及是否需要处理异常。
| | | |
| --------------------------------------------------- | ------------------------------ | ------------------------------- |
| 状态 | 含义 | 用户处理建议 |
| 区域加载中  | 系统正在为该区域启用对象存储加速能力 | 请等待加载完成 |
| 缓存未同步  | 区域已可用,但数据尚未完成缓存预热,首次访问可能较慢 | 建议点击「预热缓存」后使用 |
| 缓存同步中  | 区域正在进行缓存预热 | 可继续使用,未缓存完成的数据首次访问可能较慢 |
| 缓存同步完成  | 缓存预热已完成 | 可正常使用 |
| 预热失败  | 本次缓存预热失败,缓存可能不是最新状态 | 检查配置、权限或目录后重新预热 |
| 区域下线  | 该加速区域当前不可用 | 请更换其他可用区域 |
| 存储异常  | 对象存储服务返回权限或服务错误,平台暂时无法正常访问对象存储 | 检查 AK/SK 权限、Bucket 状态和对象存储服务可用性 |
| 区域异常  | PVC 创建失败 | 平台异常,需要让用户稍后重新尝试 |
当区域显示为「区域加载中」「区域下线」「存储异常」或「区域异常」时,暂不支持对该区域发起缓存预热,请等待区域恢复或更换其他可用区域。
当区域显示为「缓存未同步」「缓存同步中」「缓存同步完成」或「预热失败」时,仍可以选择该区域进行缓存预热。缓存同步中的区域可以继续挂载使用,也可以继续对其他目录发起预热;预热失败时,建议检查对象存储配置、权限或目录后重新预热。
## **4.** **功能效果**
[Section titled “4. 功能效果”](#4-功能效果)
> 冷启动定义:模型服务从零实例状态(缩放到 0)接收请求到准备处理第一个请求的时间间隔,是影响部署响应能力、服务等级协议(SLA)和成本控制的关键因素。为了优化冷启动,我们将介绍以下策略:对象存储加速,它通过提前将 S3 数据缓存到本地,从而提高性能。
**性能提升显著**
冷启动带来的挑战:
* 用户体验:首次请求响应时间长,影响用户满意度
* 成本控制:频繁冷启动导致资源浪费和成本增加
* 服务可用性:冷启动时间过长可能导致服务超时
S3 存储加速的优化策略:
1. 预取机制:利用 JuiceFS 预取功能,后台线程提前下载模型权重和数据
2. 分布式缓存:将模型权重缓存在分布式文件系统中,避免重复下载
3. 智能预热:对高频访问的模型进行预热处理
| | | |
| ----- | -------------------------- | --------- |
| 部署方式 | 冷启动时间 | 性能提升 |
| 传统方式 | 数分钟(如 Stable Diffusion XL) | |
| S3 加速 | 10 秒以内 | 提升 90% 以上 |
**资源利用优化**
* 读取加速:本地缓存机制提供接近本地磁盘的读取速度
* 并行下载:多线程并行下载,充分利用网络带宽
* 智能缓存:自动管理缓存空间,优先缓存高频访问数据
* 按需加载:仅在首次访问时从云端拉取数据,避免重复下载
* 空间复用:多个任务可共享同一份缓存数据,节省存储空间
## **5.** **应用场景**
[Section titled “5. 应用场景”](#5-应用场景)
### **5.1. 模型版本管理与无停机更新**
[Section titled “5.1. 模型版本管理与无停机更新”](#51-模型版本管理与无停机更新)
在生产环境中,AI 模型需要频繁更新迭代,传统方式需要重新构建和发布 Docker 镜像,过程繁琐且耗时。
S3 存储加速解决方案:
* 解耦模型与镜像:将模型文件存储在 S3 中,Docker 镜像只包含运行环境,实现模型与代码的分离
* 快速模型切换:通过更新 S3 中的模型文件,无需重建镜像即可完成模型更新
* A/B 测试:可同时挂载多个模型版本,方便进行对比测试
实际效果:
* 模型更新时间:从数小时缩短至几分钟
* 运维效率:提升 80% 以上
### **5.2. 弹性扩容与负载均衡**
[Section titled “5.2. 弹性扩容与负载均衡”](#52-弹性扩容与负载均衡)
在业务高峰期或突发流量场景下,需要快速扩容计算节点以应对负载增长。
S3 存储加速解决方案:
* 快速节点启动:新扩容的节点可直接使用缓存的模型数据,避免重复下载
* 智能缓存预热:新节点启动时自动预热常用模型,减少首次访问延迟
* 跨区域部署:支持在不同区域快速部署节点,提升服务覆盖范围
实际效果:
* 扩容时间:从传统的 10-30 分钟缩短至 1-3 分钟
* 资源利用率:提升 60% 以上
* 服务稳定性:显著提升,支持平滑扩缩容
## **6.** **操作流程一览**
[Section titled “6. 操作流程一览”](#6-操作流程一览)

## **7.** **注意事项**
[Section titled “7. 注意事项”](#7-注意事项)
* 对象存储加速是缓存能力,不是新的持久化存储。请继续以对象存储作为源数据保存位置。
* 删除缓存不会删除对象存储源数据,而是删除 JuiceFS 文件系统中对应目录的数据记录/元数据,使平台不再将该目录作为已缓存数据展示。对象存储源数据更新后,缓存不会自动同步,建议重新执行缓存预热。
* 不建议直接选择 Bucket 根目录作为加速目录。请勿停用或修改 AccessKey / SecretKey。
* 任务运行区域应与对象存储加速区域保持一致。元数据更新中时不可重复发起预热或删除操作。缓存同步中仍可挂载使用,但未缓存数据首次访问可能较慢。
* 区域下线、区域异常或配置失效时,请更换可用区域、检查对象存储配置,或联系平台管理员处理。
## 8. 常见问题
[Section titled “8. 常见问题”](#8-常见问题)
### 8.1. 配置区域后,数据是否已经缓存完成?
[Section titled “8.1. 配置区域后,数据是否已经缓存完成?”](#81-配置区域后数据是否已经缓存完成)
不是。配置区域只表示该对象存储配置已经具备挂载和缓存能力。数据是否被缓存,需要用户点击「预热缓存」并选择目录执行预热。
### 8.2. 预热缓存会删除对象存储数据吗?
[Section titled “8.2. 预热缓存会删除对象存储数据吗?”](#82-预热缓存会删除对象存储数据吗)
不会。预热缓存只会将对象存储中的数据加载到加速区域缓存中,不会修改或删除对象存储源数据。
### 8.3. 删除缓存会删除对象存储源文件吗?
[Section titled “8.3. 删除缓存会删除对象存储源文件吗?”](#83-删除缓存会删除对象存储源文件吗)
不会。删除缓存只会移除平台侧 JuiceFS 文件系统中对应目录的数据记录,并更新加速用量,不会删除对象存储中的源文件,也不会删除对象存储配置。
### 8.4. 为什么按钮显示“元数据更新中”?
[Section titled “8.4. 为什么按钮显示“元数据更新中”?”](#84-为什么按钮显示元数据更新中)
因为系统正在同步或更新目录相关信息。在该操作完成前,目录树可能不是最新状态,因此暂时不允许重复预热或删除。更新完成后,按钮会恢复可点击。
### 8.5. 缓存同步中还能使用吗?
[Section titled “8.5. 缓存同步中还能使用吗?”](#85-缓存同步中还能使用吗)
可以。只要区域可用,任务就可以挂载使用。缓存同步中表示部分数据仍在后台预热,首次访问未缓存完成的数据时,可能仍需从对象存储读取。
### 8.6. 为什么预热进度可能变化?
[Section titled “8.6. 为什么预热进度可能变化?”](#86-为什么预热进度可能变化)
后端会持续巡检缓存同步情况,进度仅作为参考,可能不是严格线性增长。用户主要关注区域是否可用,以及是否存在异常状态。
### 8.7. 为什么删除缓存后,加速用量变少了?
[Section titled “8.7. 为什么删除缓存后,加速用量变少了?”](#87-为什么删除缓存后加速用量变少了)
删除缓存后,平台会移除所选目录对应的数据记录,因此加速用量会减少。首次配置区域完成且尚未预热任何数据时,加速用量可能显示为 0B。后续执行过预热或删除缓存后,即使删除了全部可选缓存目录,系统仍会保留外层父目录等基础目录信息,因此加速用量通常不会回到 0B,可能显示为 4KB 左右。
### 8.8. 多个任务共享同一份缓存是什么意思?
[Section titled “8.8. 多个任务共享同一份缓存是什么意思?”](#88-多个任务共享同一份缓存是什么意思)
同一加速区域内,多个任务访问相同对象存储目录时,可以复用该区域已有的缓存数据,不需要每个任务都重新从对象存储下载一遍。
例如,某个模型目录已经预热到「上海一区」。后续多个任务如果都运行在「上海一区」,并挂载同一个对象存储目录,就可以复用这份缓存,从而减少模型加载时间。
# K8S YAML 导入
K8S YAML 导入功能允许熟悉 K8S 的用户以自定义 Deployment 资源或 Job 资源的 YAML 配置文件的方式实现更高自由度的自定义配置。
例如:
* 发布 Job 任务
* 使用多容器 Pod
* [调整扩缩容和滚动更新策略](https://kubernetes.io/zh-cn/docs/reference/kubernetes-api/workload-resources/deployment-v1/)
* [调整容器从启动到销毁整个生命周期的行为](https://kubernetes.io/zh-cn/docs/reference/kubernetes-api/workload-resources/pod-v1/#PodSpec)
* [调整容器启动时采用的用户](https://kubernetes.io/zh-cn/docs/reference/kubernetes-api/workload-resources/pod-v1/#PodSpec)
* [为容器配置启动命令和环境变量](https://kubernetes.io/zh-cn/docs/reference/kubernetes-api/workload-resources/pod-v1/#PodSpec)
自定义 YAML 功能运行时遵循以下的逻辑顺序:
1. 从 UI(API)获取所有 UI 可定义的配置项,包括:
1. 卡型、CPU、内存;
2. 镜像地址,端口列表;
3. 节点数量
4. 共享内存、共享存储卷、对象存储加速
2. 从 UI(API)获取用户提供的 YAML;
3. 根据 API 配置项,覆盖或补充用户提供的 YAML 中的对应配置项。其中有几项特别情况:
1. 由于支持多容器 Pod,而 UI 上只允许填写 1 个镜像,平台实际上不会校验 YAML 中所填写的镜像链接与 UI 中实际的镜像链接是否一致。
2. 主容器的 name 字段建议设置为 API 调用时 service\_name 字段的值连接上”-container”,否则任务启动后将无法查看容器日志或使用 webshell。平台自动生成的模板 YAML 的 name 字段即满足这一规则,若无必要请不要修改。
3. 所有 YAML 中的端口会被移除。平台只会根据 UI(API)上设置的端口列表建立服务暴露链路。值得注意的是,由于 Pod 内共享网络命名空间,因此 Pod 内的同一个端口只能被 Pod 内的一个服务所监听,并不需要担心流量到底应当发往哪个容器的问题。
4. 对于 Job 任务,发布任务时通过 UI(API)设定的副本数将同时设置到 Job 任务的 completions 和 parallelism 字段。在发布任务后,completions 不可被更改,通过修改副本数(节点数)的 UI(API)可以调整 parallelism,但是必须小于等于 completions。
4. 覆盖所有关于调度的配置项,例如标签选择器、污点容忍等。
5. 覆盖所有可能带来安全风险的配置项,可参考 K8S 官方的[Pod 安全性标准中的 Restricted 标准](https://kubernetes.io/zh-cn/docs/concepts/security/pod-security-standards/#restricted),我们放开了其中的“以 root 用户启动容器”限制,其余保持一致。
这里给出几个典型应用场景下的 K8S Yaml 配置文件样例
## 发布 Job 任务
[Section titled “发布 Job 任务”](#发布-job-任务)
创建两个 container,选择双卡 GPU、cpu 平均分配、内存:第一个 container 与第二个 container 比例为 9:1
```yaml
apiVersion: batch/v1
kind: Job
metadata:
creationTimestamp: null
name: pi
spec:
backoffLimit: 4
template:
metadata:
creationTimestamp: null
spec:
containers:
- image: harbor.suanleme.cn/your/image1:version
name: yourcontainername1
resources:
limits:
cpu: '28'
nvidia.com/gpu: 1
memory: 90Gi
requests:
cpu: 1166m
nvidia.com/gpu: 1
memory: 2133Mi
- image: harbor.suanleme.cn/your/image2:version
name: yourcontainername2
resources:
limits:
cpu: '4'
nvidia.com/gpu: 1
memory: 90Gi
requests:
cpu: 2333m
nvidia.com/gpu: 1
memory: 10666Mi
restartPolicy: Never
status: {}
```
## 发布多容器 Pod
[Section titled “发布多容器 Pod”](#发布多容器-pod)
创建两个 container,选择双卡 4090、cpu:第一个 container 与第二个 container 比例为 7:1、内存:第一个 container 与第二个 container 比例为 9:1
```yaml
apiVersion: apps/v1
kind: Deployment
metadata:
labels:
app: d10161633-python-web-user-id40-4474-jajdlva2
gongjiyun.com/task-type: deployment
spec:
affinity:
nodeAffinity:
requiredDuringSchedulingIgnoredDuringExecution:
nodeSelectorTerms:
- matchExpressions:
- key: nvidia.com/gpu.product
operator: In
values:
- NVIDIA-GeForce-RTX-4090
containers:
- image: harbor.suanleme.cn/your/image1:version
name: d1758620954106-62013-container1
resources:
limits:
cpu: '28'
memory: 90Gi
nvidia.com/gpu: '1'
requests:
cpu: '7'
memory: 25Gi
- image: harbor.suanleme.cn/your/image2:version
name: d1758620954106-62013-container2
ports:
- containerPort: 80
resources:
limits:
cpu: '4'
memory: 10Gi
nvidia.com/gpu: '1'
requests:
cpu: '7'
memory: 25Gi
priorityClassName: default-pc
schedulerName: requested-to-capacity-ratio-custom-scheduler
status: {}
```
## 实现容器内业务的优雅退出
[Section titled “实现容器内业务的优雅退出”](#实现容器内业务的优雅退出)
部分业务程序处理单次请求可能需要数十分钟级别的较长时间,在服务缩容等场景中,如果不等待请求完成即退出程序,可能会对用户体验造成较大不良影响。
对于此类程序,可以在业务代码里面处理 SIGTERM 信号:
* 捕获 SIGTREM 信号
* 执行对应的清理逻辑
* 主动退出程序
并在 yaml 中配置适当的优雅退出宽限时间来实现(默认 30s,可按需延长)。也可以通过 preStop 配置以其它方式通知程序。这里给出 yaml 文件样例(此处的 preStop 命令仅作格式上的说明,无实际意义)。
```yaml
......
containers:
- image: harbor.suanleme.cn/repository/imagename:v1 #选用的镜像
lifecycle: #(可选)回调函数退出时执行的逻辑
preStop:
exec:
command:
- /bin/sh
- '-c'
- sleep 30
name: d1749797718484-39886-container #默认生成
resources: #选卡时确定此配置,不可修改
limits:
cpu: '14'
memory: 63Gi
nvidia.com/gpu: '1'
requests:
cpu: '7'
memory: 32256Mi
terminationGracePeriodSeconds: 200 #(关键)定义优雅退出最大时间
```
## 自定义 yaml 增加环境变量和启动命令等信息
[Section titled “自定义 yaml 增加环境变量和启动命令等信息”](#自定义-yaml-增加环境变量和启动命令等信息)
```yaml
.......
containers:
- args: #启动参数
- serve
- MiniMaxAI/MiniMax-M1-80k
- '--trust-remote-code'
- '--quantization'
- experts_int8
- '--max_model_len'
- '4096'
- '--dtype'
- bfloat16
- '--tensor-parallel-size'
- '8'
command: #启动命令
- vllm
env: #环境变量
- name: HF_ENDPOINT
value: https://hf-mirror.com
image: harbor.suanleme.cn/xiongdw/mem-allocator:v1
name: d1750145858219-7590-container
resources:
limits:
cpu: '56'
memory: 252Gi
nvidia.com/gpu: '4'
requests:
cpu: '28'
memory: 126Gi
volumeMounts: #共享内存挂载
- mountPath: /dev/shm
name: shm-volume
terminationGracePeriodSeconds: 200 #任务最大退出时间
volumes:
- emptyDir:
medium: Memory
name: shm-volume
status: {}
```
## 解决容器内无法访问外部四层服务的问题
[Section titled “解决容器内无法访问外部四层服务的问题”](#解决容器内无法访问外部四层服务的问题)
部分业务程序可能需要访问云上消息队列,而且选择了采用 IP+ 端口的四层流量方式访问。默认我们的平台仅允许七层流量,这会导致无法从消息队列中拉取任务。如果存在此问题,可考虑使用此配置。
```yaml
apiVersion: apps/v1
kind: Deployment
metadata:
creationTimestamp: null
labels:
app: d06161816-mem-allocatorv1-186-11icjyhf
name: d06161816-mem-allocatorv1-186-11icjyhf
namespace: wp2upu39jptxiuhkfkm0nx2bdkp9elwo-186
spec:
replicas: 1
selector:
matchLabels:
app: d06161816-mem-allocatorv1-186-11icjyhf
strategy: {}
template:
metadata:
annotations: #此项为放开四层流量的限制
sidecar.istio.io/inject: 'false'
creationTimestamp: null
labels:
app: d06161816-mem-allocatorv1-186-11icjyhf
spec:
......
```
## 服务零中断滚动更新
[Section titled “服务零中断滚动更新”](#服务零中断滚动更新)
如果主动切换业务程序所在的集群,我们会并发地要求新集群拉起新实例,旧集群关闭旧实例。但是,有些时候我们需要在新实例启动后才关闭旧实例。为此,我们可以通过如下配置来让旧实例等待一段时间再退出。
```yaml
apiVersion: apps/v1
kind: Deployment
metadata:
labels:
app: xxx
spec:
replicas: 1
selector:
matchLabels:
app: xxx
template:
metadata:
annotations:
[proxy.istio.io/config](http://proxy.istio.io/config): |
drainDuration: 4m
terminationDrainDuration: 5m
holdApplicationUntilProxyStarts: true
labels:
app: nginx
spec:
terminationGracePeriodSeconds: 400 # 确保 preStop 执行完成
containers:
- name: nginx
image: [harbor.suanleme.cn/library/nginx:v1.20](http://harbor.suanleme.cn/library/nginx:v1.20) # 可替换为你的 harbor 镜像
lifecycle:
preStop:
exec:
command: ["sleep", "350"]
ports:
- containerPort: 80
```
## 以 root 用户启动容器
[Section titled “以 root 用户启动容器”](#以-root-用户启动容器)
部分业务容器可能希望以 root 身份启动,这与 K8S 的默认行为不同,可以通过自定义配置来进行设置。
```yaml
......
containers:
- image: harbor.suanleme.cn/repository/imagename:v1 #选用的镜像
name: d1749797718484-39886-container #默认生成
securityContext:
runAsUser: 0 #此处填写用户 UID,0 标识 root,也可定义其他可用 UID
runAsGroup: 0 #(可选):此处表示 root 组的 GID
```
# 预制服务
# 容器化部署 MiniMax-H3
## 1.简介
[Section titled “1.简介”](#1简介)
MiniMax H3 是 MiniMax Hailuo 视频系列中的最新模型。它可生成最长 15 秒、24 FPS 的视频,支持原生 32 kHz 立体声音频,覆盖 11 种语言,最高分辨率可达 2K。该模型由 33.1B 密集单流全能变压器(omni transformer)驱动,并配备 Qwen3-VL-32B 文本编码器。
服务支持三种生成模式,均已适配 turbo 4 步加速和满血模型工作流:
* 文生视频(一段文字直接出带音频的视频)
* 图生视频(一张首帧图片驱动画面与运镜)
* 参考生视频(最多 9 张参考图 + 3 段参考视频 + 3 段参考音频,锁定角色形象、画风或音色)
三种模式的模型与用法差异见第 7 节。
## 2.快速上手
[Section titled “2.快速上手”](#2快速上手)
首先我们进入 创建任务,推荐选用内存较大的 5090 机器。
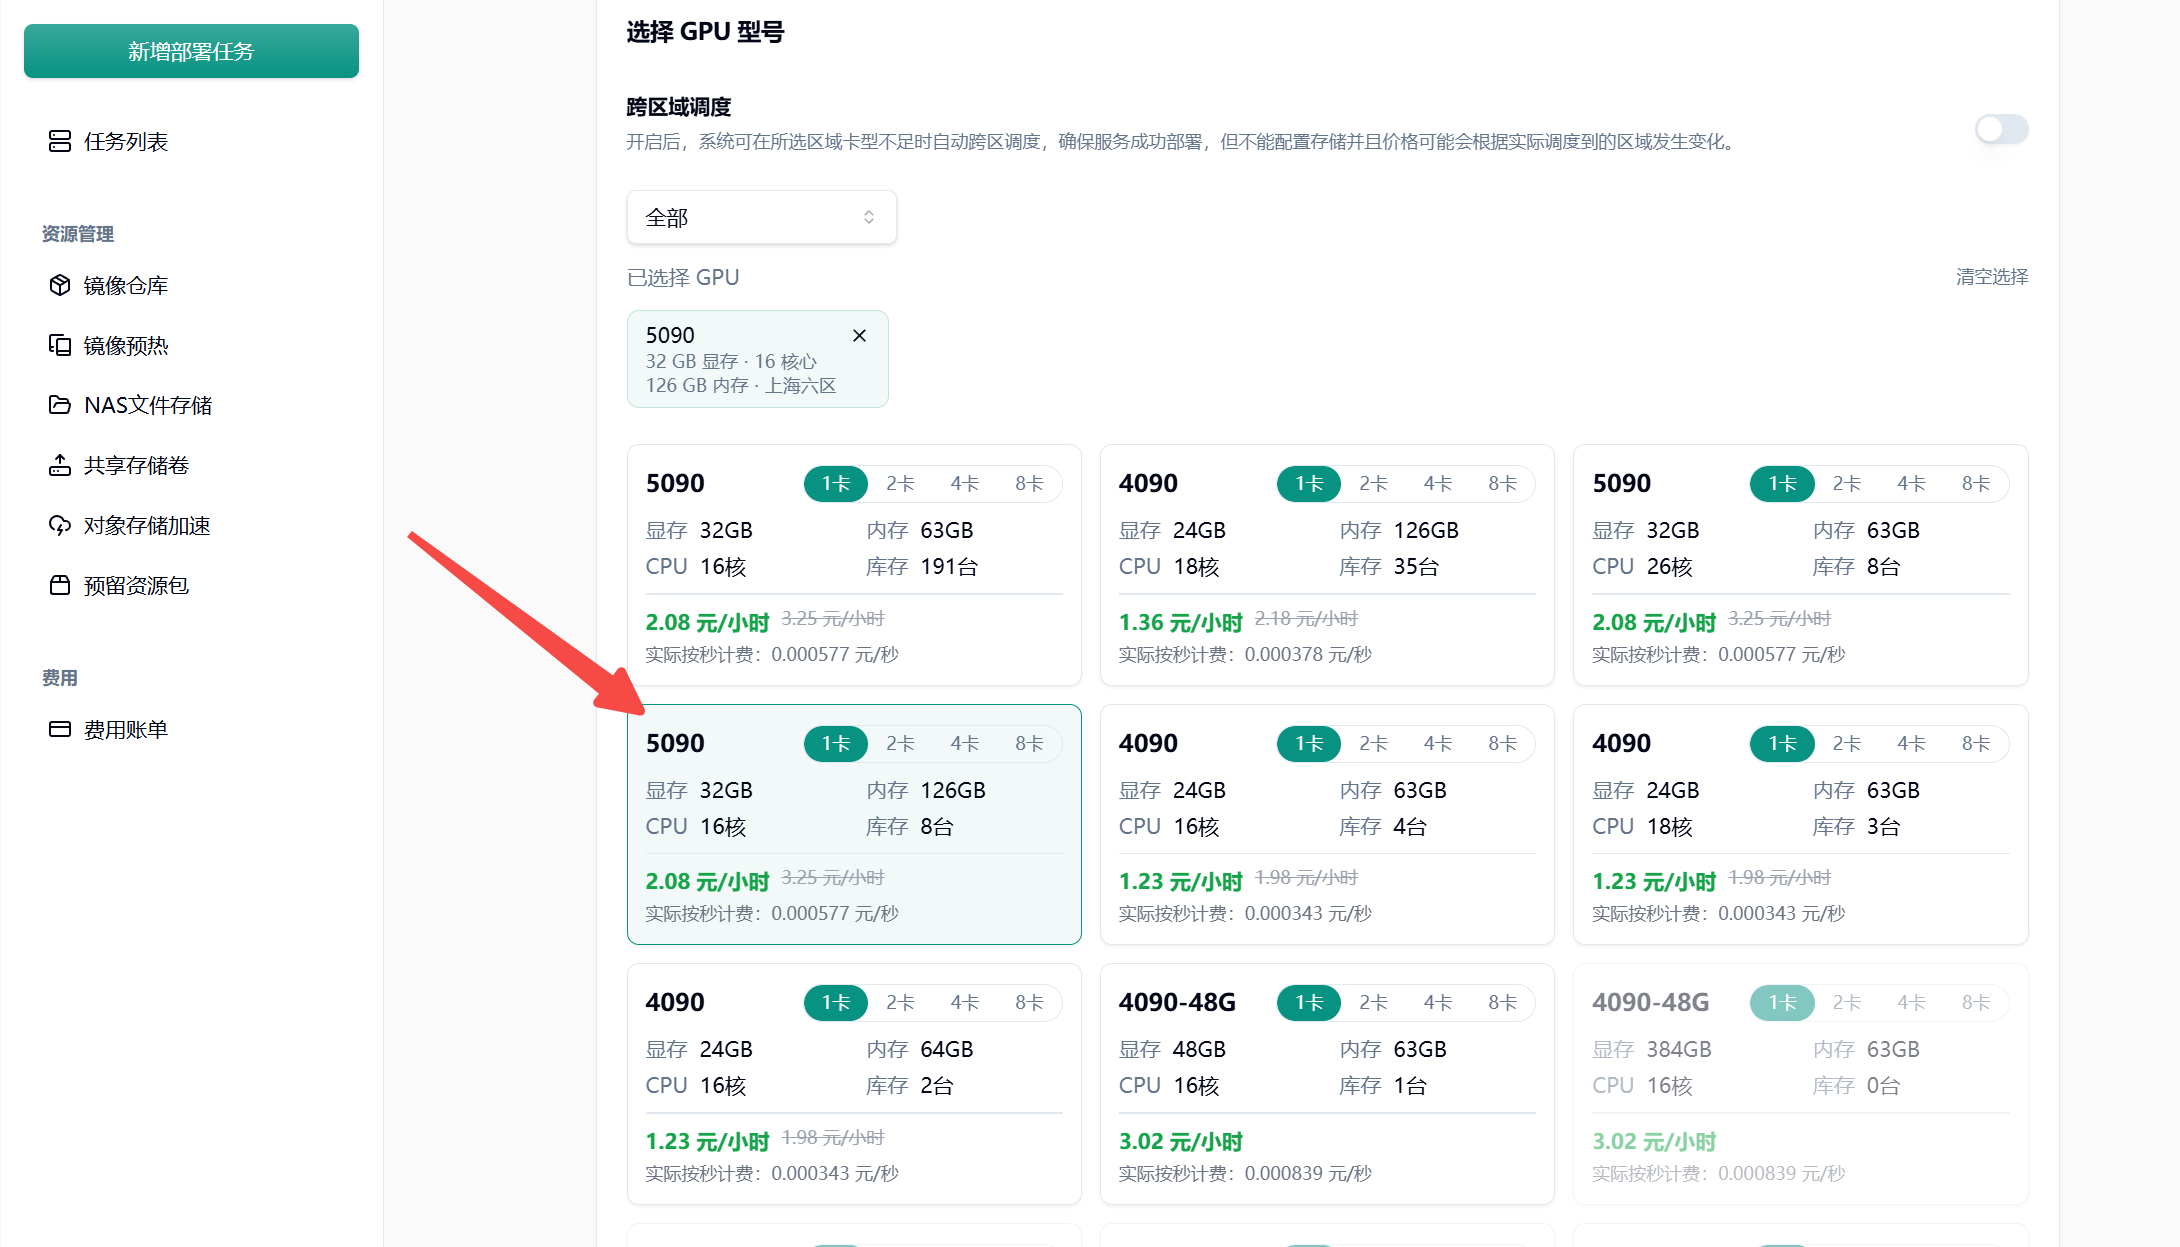
选择 MiniMax-H3 预制镜像后发布任务
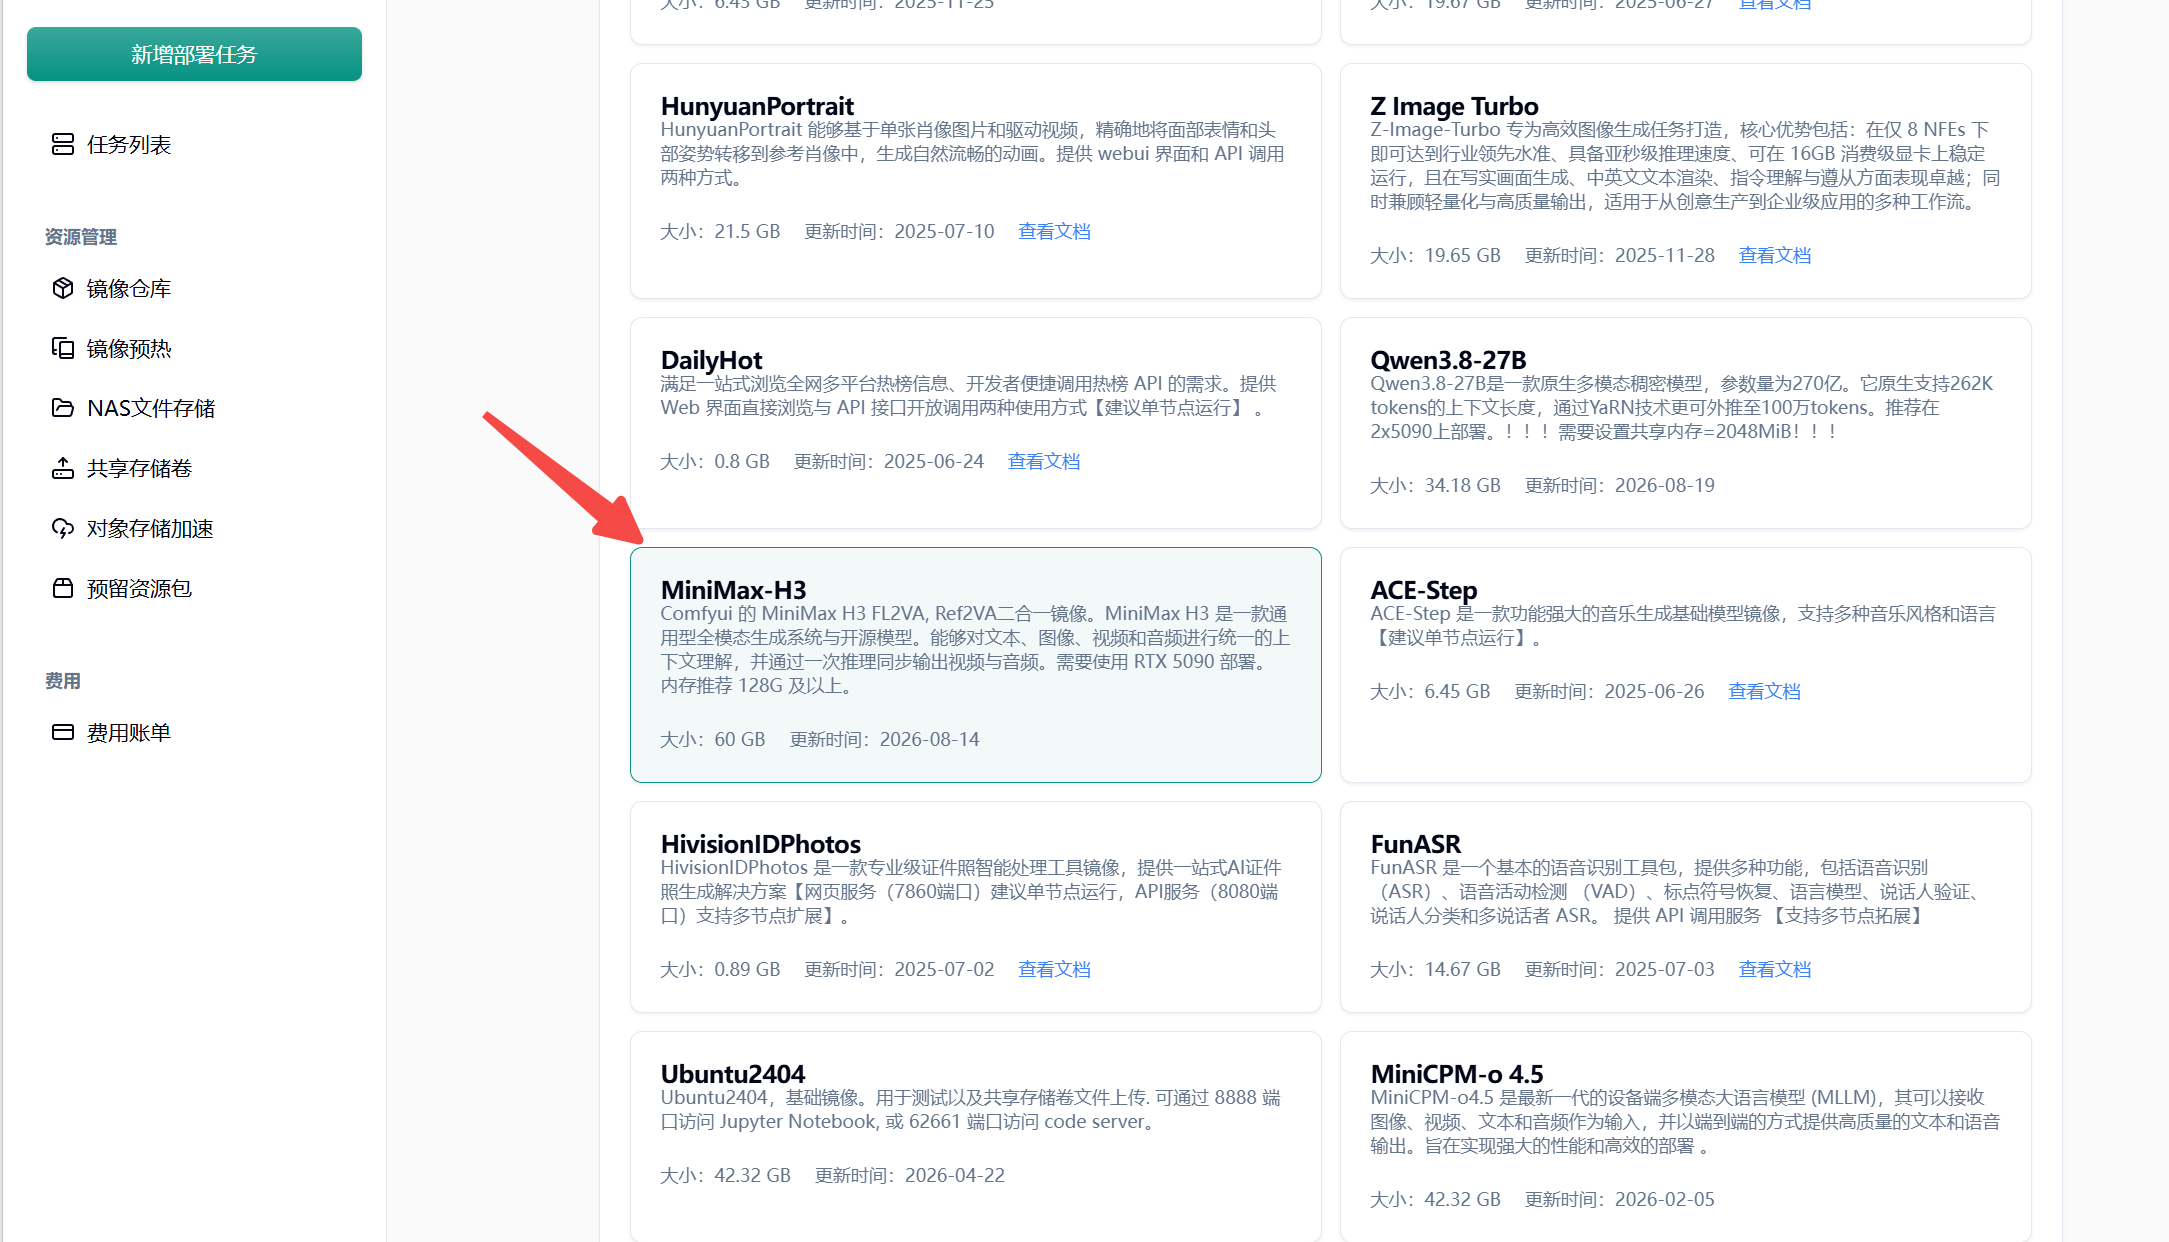
集群有镜像缓存时 1\~2 分钟 任务即可启动成功
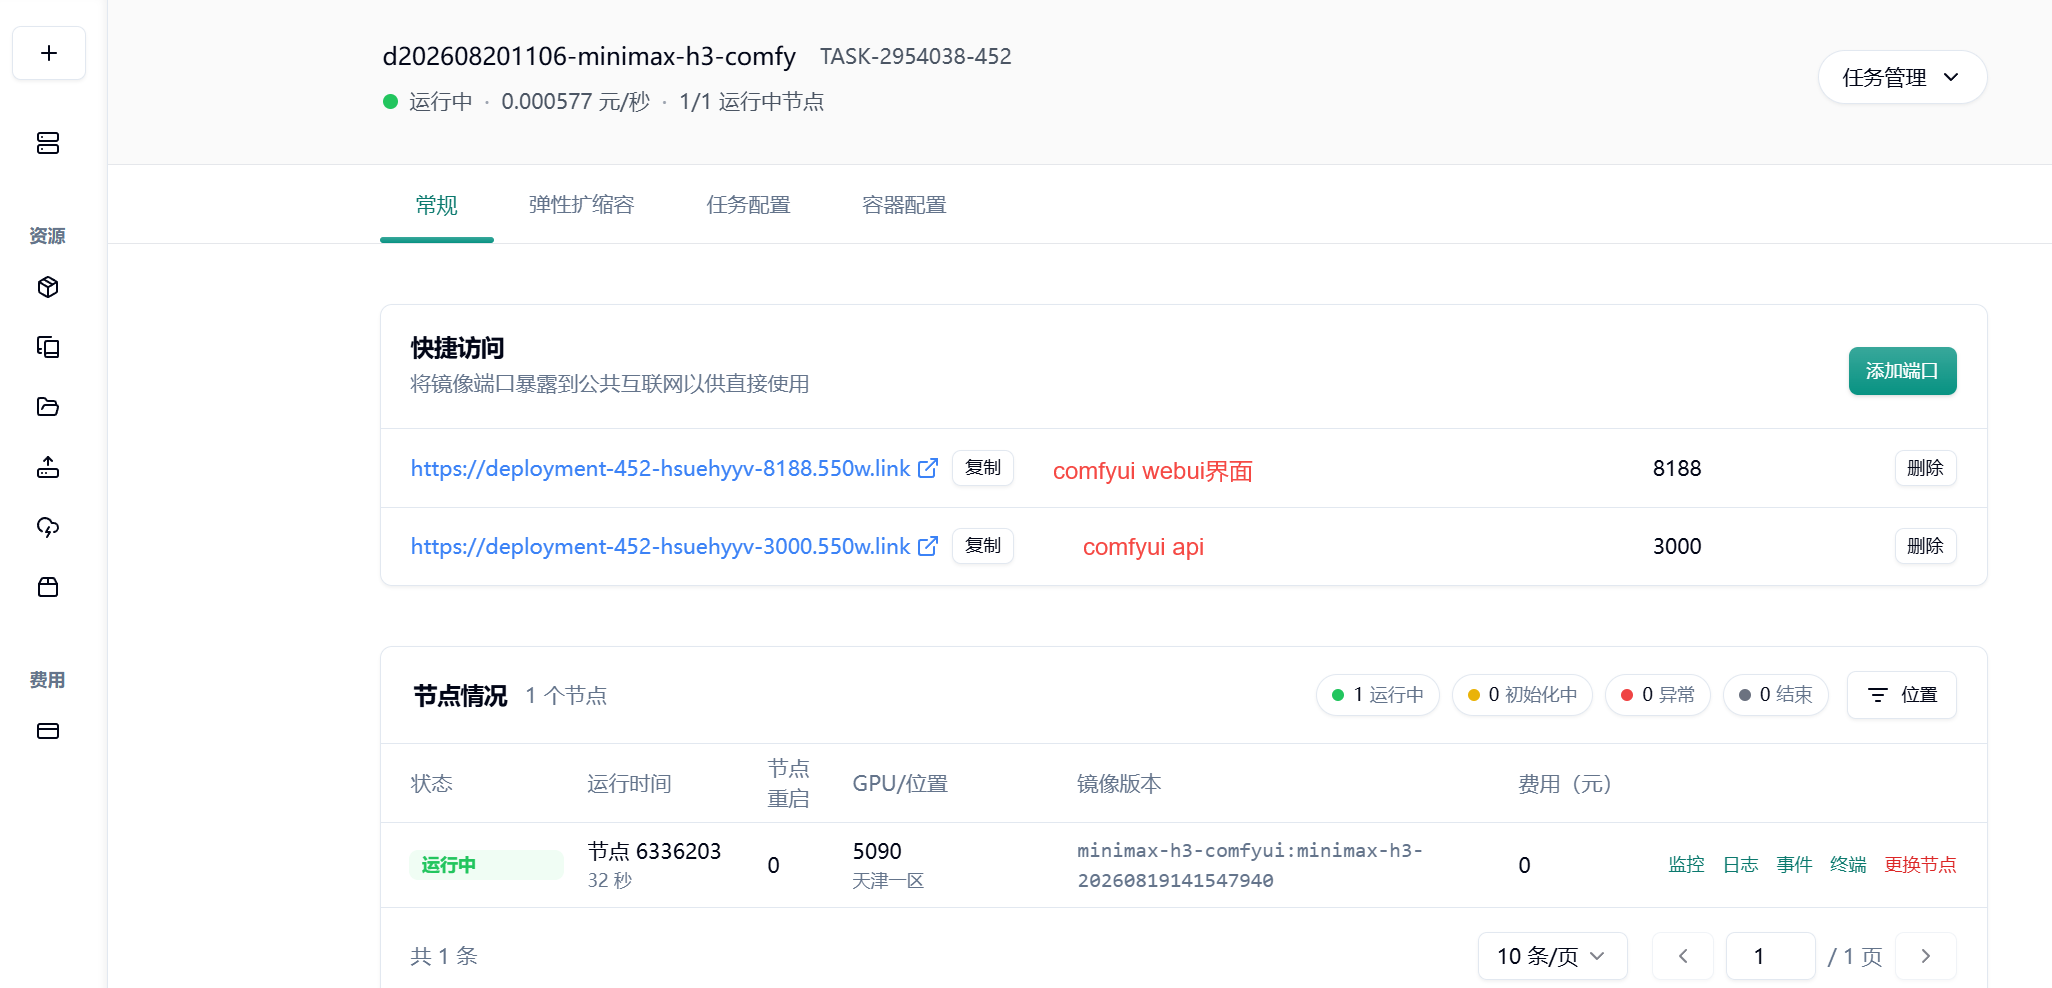
任务启动成功后点击 8188 端口进入 comfyui webui 界面 选择对应工作流即可开始生成视频
## **3.工作流介绍:**
[Section titled “3.工作流介绍:”](#3工作流介绍)
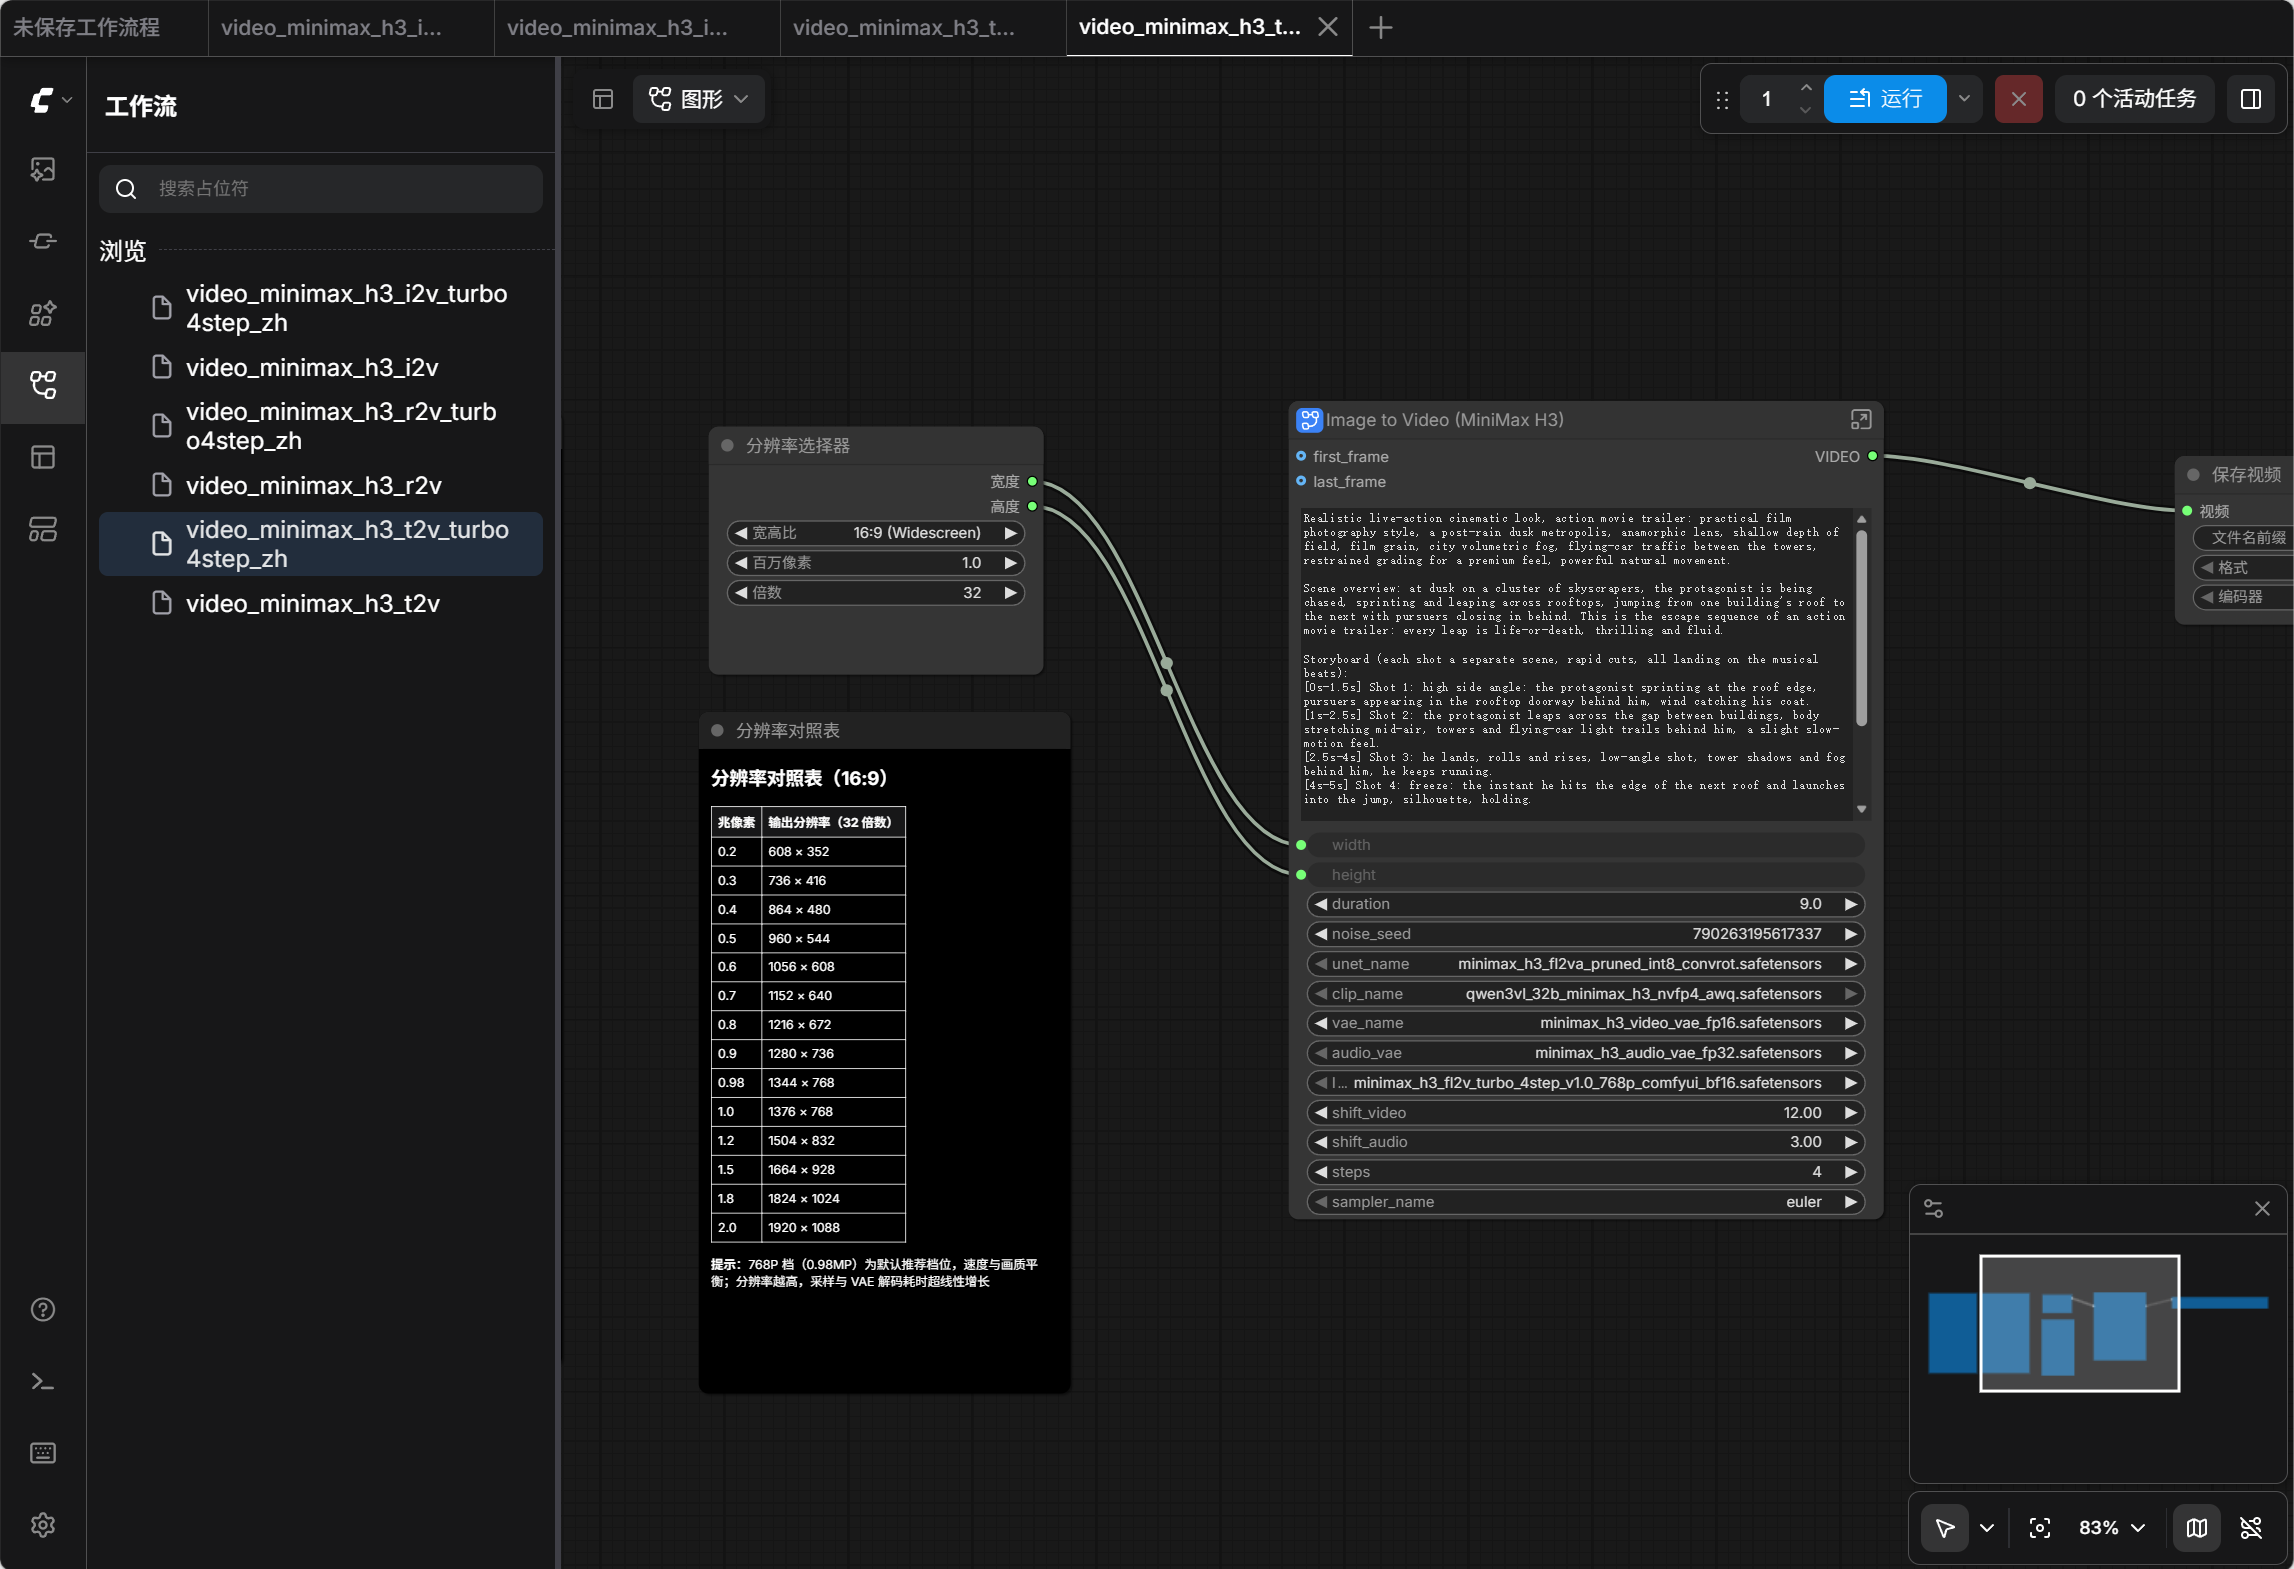
**video\_minimax\_h3\_t2v.json**
输入文字描述,输出带原生音频的视频(最长 15 秒/24FPS/最高 2K)。提示词可写镜头运动、场景内容、对白和音效,模型同步生成画面和声音。支持多镜头剪辑标记、中文对白标签、屏幕文字渲染。采样器 res\_multistep,20 步,画质最高,速度最慢。
**video\_minimax\_h3\_t2v\_turbo4step\_zh.json**
功能与原版相同,加载 4 步蒸馏 LoRA + SigmaShift 噪声调度,采样器改 euler、步数降到 4 步,速度约 5 倍。日常使用推荐。不要在 turbo 档下手动加步数,蒸馏 LoRA 按 4 步训练,加步数不会提升画质只会更慢。
**video\_minimax\_h3\_i2v.json**
上传一张起始图作为视频首帧,配合文字描述驱动镜头运动和动态变化,同步生成音频。LoadImage 选图后接到 first\_frame 输入口(尾帧引导接 last\_frame,可同时使用)。输入图片长宽比尽量与生成分辨率一致。res\_multistep,20 步。
**video\_minimax\_h3\_i2v\_turbo4step\_zh.json**
功能与原版相同,加载 fl2v turbo 4 步 LoRA + SigmaShift,euler/4 步,速度约 5 倍。日常使用推荐。
**video\_minimax\_h3\_r2v.json** 把参考图片、参考视频、参考音频融入生成,锁定角色身份、画风、动作风格或音色。最多 9 张参考图 + 3 段参考视频(可各带音轨)+ 3 段独立音频。提示词里用 ``、`